ไฟล์ดาวน์โหลด 28 ไฟล์ชื่อเป็นเวลา จับคู่กลับงานด้วยเสียงและ Hungarian
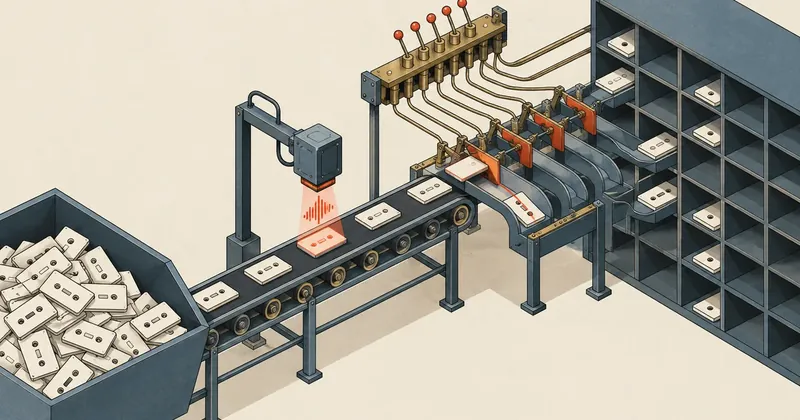
เมื่อไฟล์ไม่มีป้ายบอกว่าเป็นของงานไหน เสียงที่ฝังอยู่ในไฟล์คือลายนิ้วมือที่ดีที่สุด และการจับคู่ต้องเป็นหนึ่งต่อหนึ่งทั้งชุด ไม่ใช่ให้แต่ละไฟล์เลือกที่ชอบเอง
สรุปใน 1 นาที
- อาการ/ปัญหา
- ไฟล์วิดีโอ 28 ไฟล์ตั้งชื่อด้วยวันที่กับเวลา ไม่รู้ว่าไฟล์ไหนเป็นของงานไหน
- ใครควรอ่าน
- คนที่ต้องจับคู่ไฟล์ผลลัพธ์ที่ไม่มีป้ายกลับไปหาต้นทาง
- ทางแก้แบบสั้น
- ใช้เสียงที่ฝังในไฟล์ correlate กับแทร็กอ้างอิงเป็นเมทริกซ์ 28x28 แล้วจับคู่หนึ่งต่อหนึ่งด้วย linear_sum_assignment รับเฉพาะคะแนนเกิน 0.90 และตรวจ SHA-256 ตอนคัดลอก
พอดีผมได้ไฟล์วิดีโอผลลัพธ์มา 28 ไฟล์อยู่ในโฟลเดอร์ดาวน์โหลดเดียวกัน เป็นไฟล์จากเครื่องมือประมวลผลเป็นชุด ชื่อไฟล์มีแต่วันที่กับเวลา ไม่มีรหัสงานอยู่ในชื่อเลย ผมต้องรู้ว่าไฟล์ไหนเป็นของงานไหนก่อนจะนำไปวางบนแผนตัดต่อ ถ้าจับคู่ผิดคือภาพของท่อนหนึ่งไปวางทับเสียงของอีกท่อน ซึ่งตรวจด้วยตาจากภาพอย่างเดียวแทบไม่เจอ
ผมไม่เล่าว่าไฟล์มาจากเครื่องมือตัวไหนหรือผ่านขั้นตอนอะไรมา เล่าเฉพาะวิธีกู้ความสัมพันธ์ด้วยสัญญาณเสียง ซึ่งใช้ได้กับงานแบบเดียวกันทุกชนิดที่ไฟล์ผลลัพธ์ยังมีเสียงเดิมฝังอยู่
วิธีที่ไม่ควรทำ: เรียงตามเวลาดาวน์โหลด
วิธีที่ง่ายที่สุดคือเรียงไฟล์ตามเวลา แล้วจับคู่กับงานตามลำดับที่สั่ง ผมไม่ทำเพราะงานเสร็จไม่เรียงลำดับ งานที่สั่งทีหลังอาจเสร็จก่อน ชื่อเวลาในไฟล์บอกลำดับที่เสร็จ ไม่ได้บอกลำดับที่สั่ง และผิดครั้งเดียวคู่ที่เหลือจะเลื่อนผิดตามกันทั้งแถบ
สิ่งที่ผมมีในมือแทนคือสองอย่าง อย่างแรก ผลลัพธ์แต่ละไฟล์มีแทร็กเสียงร้องของงานนั้นฝังอยู่ อย่างที่สอง ผมมีสเต็มเสียงร้องต้นฉบับของทั้งเพลง และรู้ว่าแต่ละงานเริ่มที่ตำแหน่งไหนของเพลง ดังนั้นถ้าหาว่าเสียงในไฟล์ตรงกับช่วงไหนของสเต็ม ก็รู้ว่าเป็นงานไหน ผมให้คอมพิวเตอร์ "ฟัง" ด้วยการคำนวณ ไม่ได้นั่งฟังเอง
ขั้นตอนทั้งหมด
- ดึงเสียงจากทุกไฟล์ด้วย ffmpeg เป็น mono 8,000 Hz ชนิด float32 ใช้ ThreadPoolExecutor 4 เธรด และ `-threads 1` ต่อกระบวนการ
- สำหรับคู่ (ไฟล์ i, งาน k) ข้ามทันทีถ้าความยาวเสียงต่างจากความยาวงานเกิน 0.35 วินาที
- ตัดช่วงอ้างอิง x จากสเต็มรอบตำแหน่งเริ่มของงานบวกลบ 2,400 ซัมเปิล (บวกลบ 0.3 วินาที) บวกความยาวของไฟล์
- ทำ normalized cross-correlation ได้คะแนนสูงสุดกับ offset ต่อคู่ เก็บใน scores[28][28] ที่เริ่มด้วย -1
- `linear_sum_assignment(-scores)` ให้การจับคู่หนึ่งต่อหนึ่งที่คะแนนรวมสูงสุด
- assert คะแนนทุกคู่เกิน 0.90 แล้วบันทึกคะแนนอันดับสองของแต่ละไฟล์ไว้วัดความมั่นใจ
คะแนนต่อคู่: normalized cross-correlation
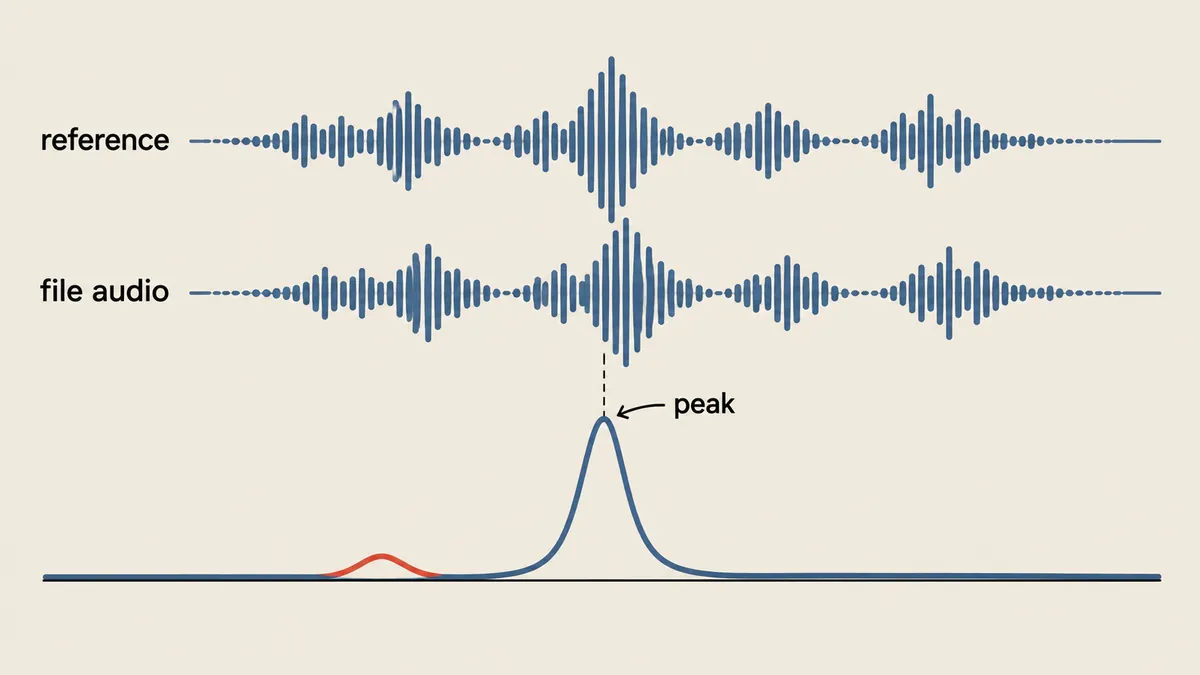
ตัวหลักคือฟังก์ชันที่หาตำแหน่งที่ไฟล์สั้น (probe) ตรงกับสัญญาณอ้างอิง (ref) ที่สุด ผมใช้สูตรเดียวกับที่ใช้ย้ายแผนตัดต่อบนเสียงชุดใหม่ ซึ่งผมเล่าไว้แล้วใน ย้ายแผนตัดต่อด้วย waveform correlation
import subprocess
import numpy as np
from scipy.signal import correlate
from concurrent.futures import ThreadPoolExecutor

SR = 8000

def load_mono(path):
    raw = subprocess.run(
        ['ffmpeg', '-v', 'error', '-threads', '1', '-i', str(path),
         '-ac', '1', '-ar', str(SR), '-f', 'f32le', '-'],
        capture_output=True, check=True).stdout
    return np.frombuffer(raw, dtype=np.float32).astype(np.float64)

def ncc_best(ref, probe):
    n = len(probe)
    cc = correlate(ref, probe, mode='valid', method='fft')
    c2 = np.concatenate(([0.0], np.cumsum(ref * ref)))
    energy = c2[n:] - c2[:-n]
    denom = np.sqrt(np.maximum(energy, 1e-12) * float(np.dot(probe, probe)))
    score = cc / denom
    k = int(np.argmax(score))
    return k, float(score[k])

with ThreadPoolExecutor(4) as ex:
    audios = list(ex.map(load_mono, files))      # files = 28 ไฟล์ที่ไม่มีป้าย
การหารด้วย sqrt(energy_window * dot(y, y)) ทำให้คะแนนอยู่ในช่วง -1 ถึง 1 ไม่ขึ้นกับความดัง และ energy_window คำนวณด้วย cumsum ของ x*x ครั้งเดียว ได้พลังงานของหน้าต่างเลื่อนทุกตำแหน่งโดยไม่ต้องวนทีละตำแหน่ง
จากนั้นสร้างเมทริกซ์คะแนน ค่าเริ่มต้นเป็น -1 สำหรับคู่ที่ถูกตัดออก
n_files, n_jobs = len(audios), len(jobs)
scores = np.full((n_files, n_jobs), -1.0)
offsets = np.zeros((n_files, n_jobs))

for i, y in enumerate(audios):
    for k, job in enumerate(jobs):               # job = {'start': วินาทีในเพลง, 'len': วินาที}
        if abs(len(y) / SR - job['len']) > 0.35:
            continue                             # ความยาวไม่เข้า ข้ามทันที
        c = int(job['start'] * SR)
        lo = max(0, c - 2400)
        x = stem[lo:c + 2400 + len(y)]           # บวกลบ 0.3 วินาทีรอบตำแหน่งที่คาด
        kk, sc = ncc_best(x, y)
        scores[i, k] = sc
        offsets[i, k] = (lo + kk - c) / SR
การกำหนดช่วงค้นรอบตำแหน่ง "สัมบูรณ์" ในเพลงสำคัญ เพราะเพลงมีท่อนซ้ำ ถ้าค้นทั้งสเต็มท่อนซ้ำจะให้คะแนนสูงทุกที่ ช่วงแคบรอบตำแหน่งที่คาดคือสิ่งที่แยกท่อนซ้ำออกจากกัน
ทำไมต้อง Hungarian แทน argmax
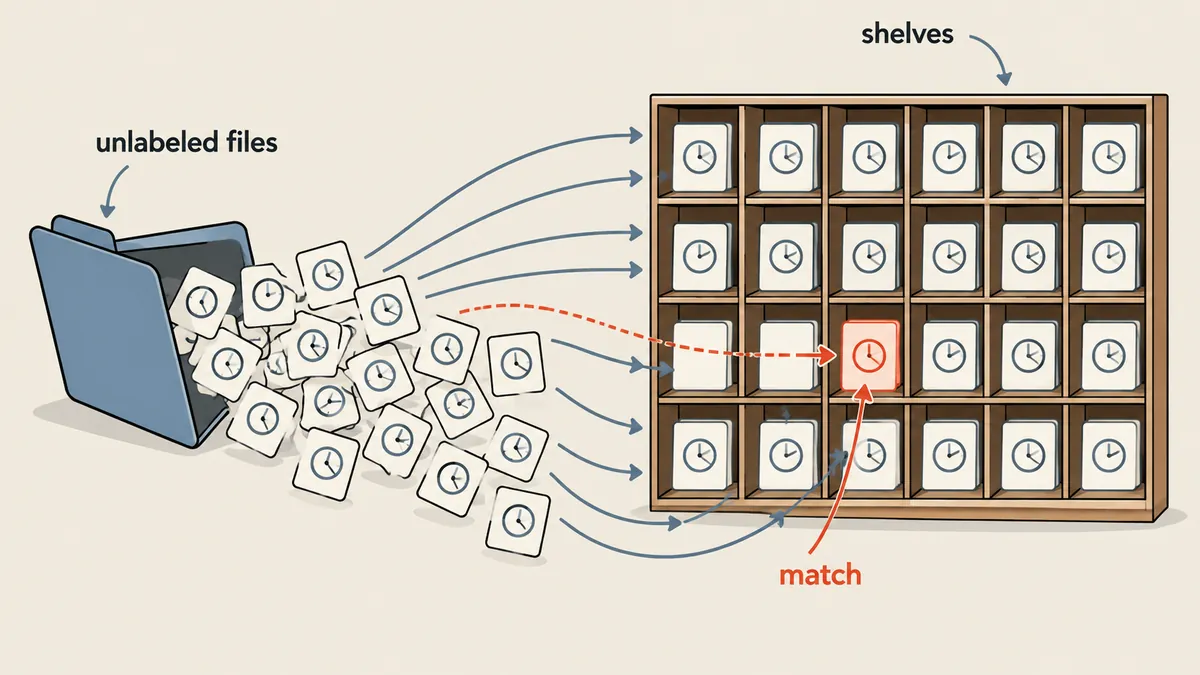
วิธีตรงไปตรงมาคือให้แต่ละไฟล์เลือกงานที่คะแนนสูงสุดของมันเอง (argmax ตามแถว) ปัญหาคือสองไฟล์เลือกงานเดียวกันได้ ถ้างานสองงานยาวใกล้กัน หรือเริ่มตรงท่อนที่ซ้ำกัน ผลที่ได้ไม่ใช่การเรียงสับเปลี่ยน (permutation) บางงานมีสองไฟล์ บางงานไม่มีเลย linear_sum_assignment บังคับให้เป็นหนึ่งต่อหนึ่งที่คะแนนรวมสูงสุด
ผมต้องบอกตรง ๆ ว่าในงานจริงชุดนี้ไม่เกิดการจับคู่ผิดจริง นี่เป็นเหตุผลเชิงการออกแบบ แต่ผมทดสอบด้วยข้อมูลสังเคราะห์เพื่อดูว่ามันพังอย่างไรเมื่อมีท่อนซ้ำ สร้างเพลงสุ่ม 60 วินาที ก๊อปช่วง 10 ถึง 14 วินาทีไปวางที่ 30 ถึง 34 วินาที (เลียนท่อนคอรัสซ้ำ) มี 6 งาน สองงานในนั้นเป็นท่อนที่ซ้ำกัน ยาว 4.00 กับ 4.02 วินาที
| แถว (ไฟล์) | งานที่ถูกต้อง | คะแนนงาน A | คะแนนงาน B | argmax เลือก |
|---|---|---|---|---|
| ไฟล์ 3 | A | 0.99246 | 0.99246 | B ผิด |
| ไฟล์ 5 | B | 0.98674 | 0.99266 | B ถูก |
ไฟล์ 3 ให้คะแนนงาน A กับ B เท่ากันเป๊ะ เพราะเสียงท่อนนั้นถูกก๊อปซ้ำ argmax เลยเลือก B และชนกับไฟล์ 5 ที่เลือก B เหมือนกัน ส่วน linear_sum_assignment มองทั้งเมทริกซ์พร้อมกัน เห็นว่าไฟล์ 5 ต้องได้ B ไฟล์ 3 ที่เหลือเลยได้ A คำตอบออกมาตรงกับของจริงทั้ง 6 ไฟล์ นี่เป็นผลจากข้อมูลสังเคราะห์ ผมไม่ได้อ้างว่าเกิดในงานจริง
แต่ละไฟล์เลือกเอง
เร็วและเขียนง่าย แต่ไม่รู้จักกันระหว่างไฟล์ สองไฟล์เลือกงานเดียวกันได้ และบางงานจะไม่มีไฟล์เลย
เลือกทั้งชุดพร้อมกัน
ผลเป็นการเรียงสับเปลี่ยนเสมอ หนึ่งไฟล์ต่อหนึ่งงาน ที่คะแนนรวมสูงสุด ท่อนซ้ำเลยไม่ทำให้ชนกัน
from scipy.optimize import linear_sum_assignment

rows, cols = linear_sum_assignment(-scores)      # ใส่ลบ เพราะฟังก์ชันหาค่าต่ำสุด
pairs = []
for i, k in zip(rows, cols):
    sc = scores[i, k]
    assert sc > 0.90, ('คะแนนต่ำเกินไป', i, k, sc)
    runner_up = np.delete(scores[i], k).max()    # คะแนนอันดับสองของไฟล์นี้
    pairs.append({'file': int(i), 'job': int(k), 'score': float(sc),
                  'nextBestCorrelation': float(runner_up),
                  'offset': float(offsets[i, k])})
ผลที่ได้จากชุดจริง
ตัวเลขจากไฟล์บันทึกผล คะแนนของคู่ที่เลือกอยู่ระหว่าง 0.9401 ถึง 0.99986 ส่วนคะแนนอันดับสองที่สูงที่สุดของทั้งชุดคือ 0.449 ส่วนต่างระหว่างอันดับหนึ่งกับอันดับสองเลยต่ำสุด 0.546 ช่องว่างกว้างขนาดนี้ทำให้ผมเชื่อผลโดยไม่ต้องฟังทีละไฟล์ offset ของทุกไฟล์อยู่ในช่วงบวกลบ 0.0000625 วินาที คือเสียงเริ่มตรงตำแหน่งที่คาดไว้
ไฟล์ผลลัพธ์เป็น 1280x720 ที่ 30 fps ความยาว 5.43 ถึง 8.97 วินาที สั้นกว่าความยาวงานเล็กน้อย ผมเลยใช้ offset จาก correlation คำนวณจุดเริ่มอ่าน (source-in) ตอน render ไม่สมมติเป็นศูนย์
คัดลอกอย่างปลอดภัยแล้วเขียน manifest
เมื่อได้คู่แล้วผมคัดลอกไฟล์ไปยังโฟลเดอร์ของงาน ไม่ย้ายและไม่ลบของเดิม ไฟล์ในโฟลเดอร์ดาวน์โหลดไม่ถูกแก้ ย้าย หรือลบเลย
import hashlib, json, shutil
from pathlib import Path

def sha256(p, chunk=1 << 20):
    h = hashlib.sha256()
    with open(p, 'rb') as f:
        while block := f.read(chunk):
            h.update(block)
    return h.hexdigest()

manifest = {'items': []}
for pr in pairs:
    src = Path(files[pr['file']])
    dst = Path(job_dirs[pr['job']]) / 'result.mp4'
    if not dst.exists():                          # ข้ามถ้ามีแล้ว รันซ้ำได้
        shutil.copy2(src, dst)
    assert dst.stat().st_size == src.stat().st_size, ('ขนาดไม่ตรง', dst)
    assert sha256(dst) == sha256(src), ('SHA-256 ไม่ตรง', dst)
    manifest['items'].append({**pr, 'sha256': sha256(dst)})

manifest['allTransferredAndVerified'] = True
Path('manifest.json').write_text(json.dumps(manifest, indent=2), encoding='utf-8')
ส่วนข้ามถ้ามีแล้วทำให้รันซ้ำได้โดยไม่เขียนทับ แต่การ assert ขนาดกับ SHA-256 ยังรันทุกครั้ง ไฟล์ที่ค้างครึ่งทางจากรอบก่อนจะไม่หลุดผ่านไปเงียบ ๆ
วิธีนี้ใช้ได้เฉพาะเมื่อไฟล์ผลลัพธ์ยังมีเสียงร้องเดิมอยู่ ถ้าไม่มีเสียงร้อง หรือเสียงเปลี่ยนมาก (เช่นผ่านการแปลงเสียง) คะแนน correlation จะตกและ assert 0.90 จะหยุดงานตั้งแต่ต้น ซึ่งเป็นพฤติกรรมที่ถูกต้อง ผมเลือกให้หยุดดีกว่าเดาแล้วจับคู่ผิด ส่วนที่ 8 kHz ความละเอียดคือ 0.125 มิลลิวินาที เพียงพอสำหรับตัดต่อที่ 30 fps
สรุป
เมื่อไฟล์ไม่มีป้าย ให้หาลายนิ้วมือในเนื้อหาของมันเอง เสียงที่ฝังอยู่ใช้ได้ดีเพราะเรามีต้นฉบับอ้างอิงและตำแหน่งที่คาดไว้ ลำดับที่ผมใช้คือกรองด้วยความยาวก่อนเพื่อลดงาน correlate ทีละคู่ แล้วค้นเฉพาะช่วงแคบรอบตำแหน่งสัมบูรณ์ แล้วใช้ assignment ให้ได้การเรียงสับเปลี่ยน ปิดท้ายด้วย assert คะแนนเกิน 0.90 กับบันทึกอันดับสองไว้เป็นหลักฐานความมั่นใจ ผมยังไม่ได้ลองกับไฟล์ที่เสียงถูกแปลงหนัก ๆ ถ้าใครลองแล้วได้ผลต่างจากนี้ เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย