origin รับ 80/443 เฉพาะ CDN กับบอทที่ยืนยันได้ อัปเดต set แบบอะตอมมิก
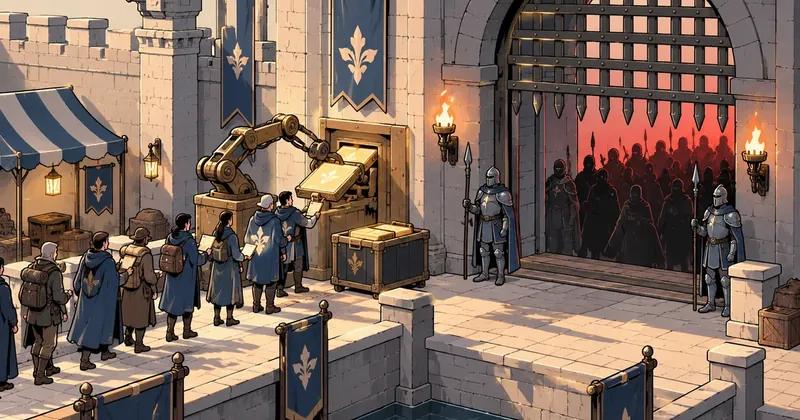
ถ้าเว็บอยู่หลัง CDN คนที่ควรเคาะ 80/443 ของ origin ได้มีแค่ CDN กับบอทที่ผ่านการยืนยัน ส่วนที่เหลือคือสแกนเนอร์ แต่รายการ IP ของทุกฝ่ายเปลี่ยนได้ทุกวัน เลยต้องมีสคริปต์ที่อัปเดตมันโดยไม่เปิดช่องให้ไฟร์วอลล์โหลดไม่ขึ้นหรือว่างเปล่าแม้เสี้ยววินาที
สรุปใน 1 นาที
- อาการ/ปัญหา
- origin ของเว็บหลัง CDN ควรรับเฉพาะ CDN กับบอทค้นหาที่ยืนยันแล้ว แต่รายการ IP เปลี่ยนทุกวัน
- ใครควรอ่าน
- ผู้ดูแล VPS เว็บที่อยู่หลัง CDN
- ทางแก้แบบสั้น
- ปิด 80/443 ให้เหลือ nft set แบบ interval ที่อัปเดตรายวันใน transaction เดียว ตรวจแหล่งข้อมูลก่อนแตะไฟร์วอลล์ และเก็บสำเนาล่าสุดที่ดีไว้
พอดีผมเปิดล็อก nginx ของ VPS หน้าเว็บที่ทำให้เว็บลูกค้ารายหนึ่งดู แล้วเจอคำขอจากที่อยู่แปลก ๆ ยิงตรงเข้า IP ของ origin วันละหลายร้อยครั้ง ไล่ดู path แล้วเป็นพวกหาไฟล์ที่ไม่ควรมี ทั้งที่ DNS ของเว็บเป็นแบบผ่าน CDN หมดแล้ว ผู้เข้าชมตัวจริงไม่มีทางมาจากที่อยู่พวกนี้ ผมเลยตั้งใจว่า origin ต้องรับ 80/443 จากช่วง IP ของ CDN เท่านั้น แล้วเขียนสคริปต์ให้ไปดึงช่วง IP มาอัปเดตเองทุกวัน ฟังดูง่าย แต่ตอนทำจริงเจอกับดักสองเรื่องที่ผมพลาดคิดไปก่อน คือบอทค้นหาที่ไม่ได้ผ่าน CDN กับช่วงเวลาที่ set ว่างตอนอัปเดต บทความนี้เล่าทั้งหมดโดยใช้ชื่อ set และช่วง IP ตัวอย่าง ไม่ใช่ของจริง
ชื่อตาราง ชื่อ set และช่วง IP ทุกตัวในบทความนี้เป็นตัวอย่างที่ผมเขียนใหม่ ไม่ใช่กฎจริงของเครื่องไหน ก่อนเอาไปใช้ให้ทดลองบนเครื่องที่ยังมีทางเข้าสำรอง (คอนโซลของผู้ให้บริการหรือเครื่องที่ถึงกันในวงภายใน) เพราะกฎที่ผิดหนึ่งบรรทัดทำให้เว็บล่มทั้งที่เซิร์ฟเวอร์ปกติดี
ทำไม origin ถึงไม่ควรรับใครนอกจาก CDN
หลักคิดสั้นมาก เมื่อ DNS ชี้ไปที่ CDN แบบ proxied ผู้เยี่ยมเยือนทุกคนจะคุยกับ CDN ก่อน แล้ว CDN ค่อยเปิดการเชื่อมต่อใหม่มาหา origin ของเรา แปลว่าการเชื่อมต่อที่ถึง nginx ตัวจริงควรมาจากช่วง IP ของ CDN เท่านั้น ใครที่ยิงตรงมาที่ IP ของ origin คือคนที่ข้าม CDN ไปแล้ว ซึ่งก็คือสแกนเนอร์ บอทสุ่มหาช่องโหว่ หรือไม่ก็คนที่หา origin เจอจากประวัติ DNS เก่า
ใครก็เคาะ 80/443 ได้
CDN ช่วยกรองได้เฉพาะคำขอที่ผ่านมันเท่านั้น ส่วนคำขอที่ยิงตรง IP ถึง nginx ครบ ไม่มี WAF ไม่มี rate limit ของ CDN ขวางอยู่ ล็อกเต็มไปด้วยขยะ และ nginx ต้องเสียแรงตอบทุกตัว
เฉพาะ CDN กับบอทที่ยืนยันได้
พอร์ตเว็บเปิดให้แค่ช่วง IP ที่ประกาศอย่างเป็นทางการ ที่เหลือโดน drop ตั้งแต่ชั้นไฟร์วอลล์ nginx ไม่เห็นด้วยซ้ำว่ามีคนมาเคาะ ล็อกสะอาดขึ้นเห็นได้ชัด
ส่วนตัวผมถือว่านี่เป็นชั้นป้องกันที่ถูกที่สุดชั้นหนึ่งสำหรับเว็บที่อยู่หลัง CDN เพราะไม่ต้องรู้จักช่องโหว่ของใครเลย แค่ตัดคนที่ไม่ควรมาออกไปก่อน ตามใจชอบถ้าใครอยากเสริมด้วยกฎอื่นอีกชั้น แต่ชั้นนี้ผมว่าควรมี
กับดักแรก บอทค้นหาที่ไม่ผ่าน CDN
ผมทำตามหลักข้างบนแบบซื่อ ๆ เปิดแค่ช่วง CDN แล้วหลังจากนั้นไม่กี่วัน Search Console รายงานว่าดึง sitemap ไม่ได้ ตอนแรกผมสงสัยไฟล์ sitemap เองก่อน ตรวจแล้วไม่มีอะไรผิด สงสัยต่อว่าเป็นที่ CDN มีกฎบล็อกบอทหรือเปล่า ก็ไม่ใช่ ผมเสียเวลาไปสองสามชั่วโมงกับเรื่องนี้ก่อนจะนึกขึ้นได้ว่าบอทค้นหาบางตัวไม่ได้ผ่าน CDN ของเรา มันดึงจากที่อยู่ของตัวเองแล้วเข้าหา origin ตรง ๆ ผ่านชื่อโดเมน ผมเองที่เพิ่งตัดทางตรงทิ้งไปกับมือ
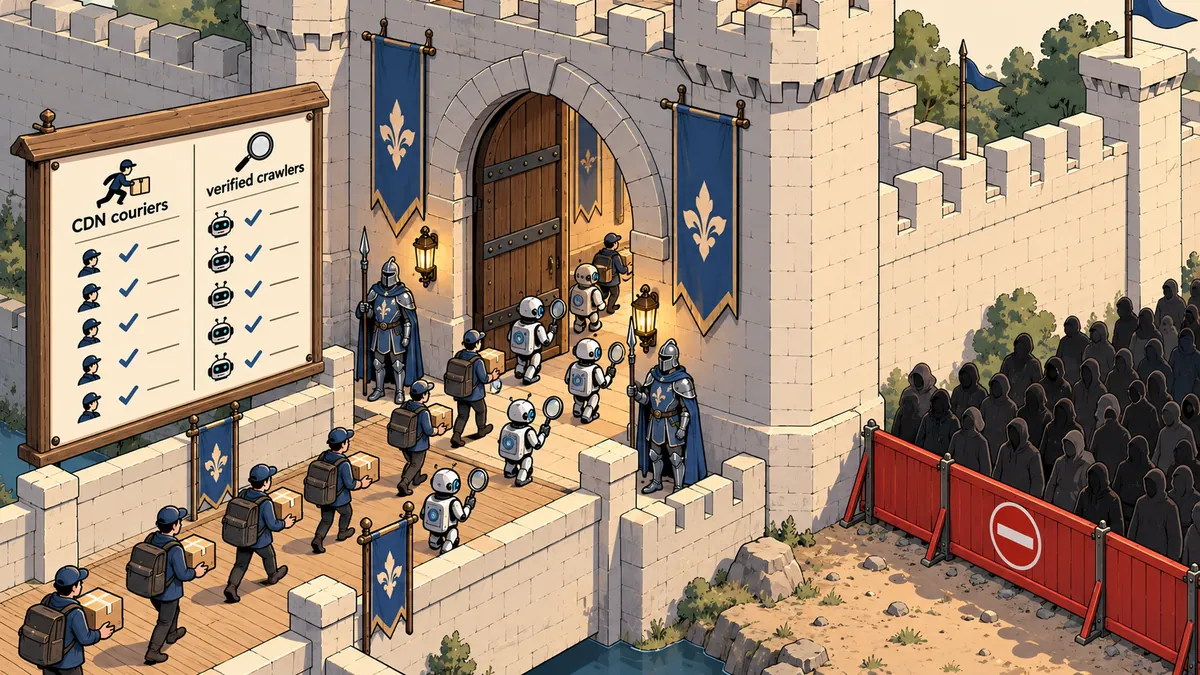
ข้อสรุปคือ allow list ของ origin ต้องมีสองกลุ่ม กลุ่มแรกคือช่วง IP ของ CDN กลุ่มที่สองคือบอทที่ผู้ให้บริการประกาศรายการ IP ทางการเป็นไฟล์ให้ดึงได้ ผมรวมแหล่งไว้ทั้งหมด 12 แหล่ง ได้แก่ CDN สองรายการ (v4 กับ v6 เป็นข้อความธรรมดา) บอทของเสิร์ชเอนจินหลัก ๆ รวมชุดตัวดึงพิเศษที่ผู้ใช้สั่งให้ดึง บอทของแพลตฟอร์ม AI ที่เปิดรายการ และบอทของเครื่องมือ SEO หนึ่งสองเจ้า ส่วนบอทที่ไม่มีรายการทางการ ผมไม่เดาช่วง IP ให้ ปล่อยให้เข้าผ่าน CDN อย่างเดียว
พวกที่ไม่ประกาศช่วง IP (บางตัวสร้างตัวอย่างลิงก์ในโซเชียล) จะเข้า origin ตรงไม่ได้ ต้องเข้าผ่าน CDN เท่านั้น ซึ่งปกติก็ทำได้อยู่แล้วเพราะมันคุยกับชื่อโดเมนที่ชี้ไป CDN ส่วนอีกด้านหนึ่ง ถ้า DNS เป็นแบบ proxied แล้วลืมเปิดช่วงของ CDN ที่ไฟร์วอลล์ ผู้ใช้จะเห็นเว็บล่มทั้งที่เซิร์ฟเวอร์ปกติ ตรวจสองข้อนี้ทุกครั้งที่แก้
รายการ IP ไม่คงที่ เลยต้องรันทุกวัน
ผมไม่เชื่อว่ารายการ IP ของผู้ให้บริการจะคงที่ตลอดไป มีแต่เพิ่มช่วงใหม่ ปลดช่วงเก่า ถ้าฝัง IP ลงไฟล์ไฟร์วอลล์ครั้งเดียวแล้วลืม วันหนึ่งช่วงที่ CDN เพิ่งเริ่มใช้ก็ไม่อยู่ในลิสต์ เว็บล่มเป็นช่วง ๆ แบบหาสาเหตุยาก ผมเลยทำให้สคริปต์ Python ตัวเดียวทำทุกอย่าง ตั้ง systemd timer รันทุกวันตอน 03:40 มีสุ่มหน่วงไม่เกิน 30 นาที เพื่อไม่ให้ทุกเครื่องในโลกยิงแหล่งเดียวกันตรงเวลาเป๊ะ
# web-allow.timer (ตัวอย่าง)
[Unit]
Description=Refresh web allow sets daily

[Timer]
OnCalendar=*-*-* 03:40:00
RandomizedDelaySec=30min
Persistent=true
OnBootSec=2min

[Install]
WantedBy=timers.target
Persistent=true ทำให้ถ้าเครื่องดับตอนถึงเวลา มันจะรันชดเชยเมื่อเปิดขึ้นมา ส่วน OnBootSec=2min ให้รันอีกรอบหลังบูต เผื่อ set ที่โหลดจากไฟล์เก่าล้าสมัยไปแล้ว บรรทัดท้ายสุดของล็อกทุกรอบสรุปจำนวนต่อแหล่งไว้ ผมเปิดดูแค่บรรทัดเดียวก็รู้ว่าวันนี้ปกติไหม รอบหนึ่งที่ตรวจพบ v4 ราวหนึ่งพันช่วง v6 ราวสองร้อยช่วง
ด่านตรวจแหล่งข้อมูลก่อนแตะไฟร์วอลล์
สิ่งที่ผมกลัวที่สุดคือแหล่งหนึ่งล้มหรือส่งของแปลก ๆ มา แล้วสคริปต์ยัดมันลงไฟร์วอลล์ตรง ๆ ลองนึกภาพไฟล์ที่ตอบมาเป็นหน้า error หรือว่างเปล่า ผลคือ set ว่าง เว็บล่มทั้งเว็บ หรือแย่กว่านั้นคือมีช่วงกว้างเกินจริงหลุดมา เช่น /0 ซึ่งเท่ากับเปิดให้ทั้งโลก ผมเลยวางด่านต่อแหล่งไว้ก่อนเสมอ
- ดึงด้วย timeout 30 วินาที อ่านไม่เกิน 2,000,000 ไบต์ ถ้าเกินถือว่าผิดปกติ
- ใช้ regex ดึงเฉพาะสิ่งที่หน้าตาเป็น prefix ออกมา ไม่เชื่อโครงสร้างไฟล์ทั้งก้อน
- ส่งทุก prefix เข้า
ipaddress.ip_networkถ้าไม่ใช่ที่อยู่จริงจะเกิด ValueError - ปฏิเสธทุกที่อยู่ที่ไม่ใช่ global เช่น 10.x หรือ 127.x ที่มักโผล่มาจากไฟล์เสีย
- ปฏิเสธช่วงที่กว้างเกินเพดานของแหล่งนั้น เช่น CDN ไม่เล็กกว่า /12 สำหรับ v4 และ /29 สำหรับ v6 ส่วนบอทไม่เล็กกว่า /16 กับ /32
- ปฏิเสธรายการว่าง หรือเกิน 5,000 prefix
- แหล่งที่ผ่านทุกข้อ เก็บเป็นสำเนาล่าสุดที่ดี แหล่งที่ไม่ผ่าน ใช้สำเนานั้นแทน
import ipaddress, re, urllib.request

UA = "web-allow-updater/1.0"      # ชื่อกลาง ๆ ไม่ใส่โดเมน
MAX_BYTES = 2_000_000
MAX_PREFIXES = 5000
CIDR = re.compile(r'(?<![\w:.])([0-9a-fA-F:.]{2,45}/\d{1,3})(?!\w)')

def fetch(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    with urllib.request.urlopen(req, timeout=30) as r:
        raw = r.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise ValueError("response too large")
    return raw.decode("utf-8", "replace")

def validate(text, min_v4, min_v6):
    nets = []
    for c in CIDR.findall(text):
        n = ipaddress.ip_network(c, strict=False)   # ValueError ถ้าไม่ใช่ที่อยู่
        if not n.is_global:
            raise ValueError(f"non-global: {n}")
        floor = min_v4 if n.version == 4 else min_v6
        if n.prefixlen < floor:
            raise ValueError(f"too broad: {n}")
        nets.append(n)
    if not nets or len(nets) > MAX_PREFIXES:
        raise ValueError(f"unexpected count: {len(nets)}")
    return nets
ถ้าแหล่งที่ต้องมี คือ CDN ไม่มีข้อมูลเลย ทั้งดึงสดไม่ได้และไม่มีสำเนาเก่า สคริปต์จะเขียนในล็อกว่า nothing changed แล้ว exit 1 ไม่แตะไฟร์วอลล์เด็ดขาด ผมถือว่า "ไม่รู้" ดีกว่า "เดา" ในเรื่องนี้ ส่วนแหล่งบอทที่ล้ม ใช้สำเนาเก่าไปก่อนได้ เพราะบอทเปลี่ยนช่วงไม่บ่อยเท่า
ลำดับอัปเดตที่ห้ามสลับ
ตรงนี้คือหัวใจของเรื่อง เพราะตอนแรกผมคิดว่าแค่เขียนไฟล์ใหม่แล้วสั่ง nft -f ก็จบ ที่จริงมีสองกับดักซ้อนกัน อย่างแรก ถ้าไฟล์ include ที่ nftables.conf อ้างถึงเสียหนึ่งไฟล์ ตอนบูตครั้งหน้า nftables โหลดไม่ขึ้น เครื่องบูตมาแบบไม่มีไฟร์วอลล์เลย อย่างที่สอง ถ้าใช้วิธี flush set แล้วค่อยเพิ่มสมาชิกเป็นคนละคำสั่ง จะมีช่วงสั้น ๆ ที่ set ว่างระหว่างสองคำสั่งนั้น ซึ่งคำขอจริงจาก CDN ที่เข้ามาพอดีจะโดน drop
ทางแก้คือ nft รับคำสั่งหลายบรรทัดจาก stdin เป็น transaction เดียว ทุกบรรทัดสำเร็จพร้อมกัน หรือไม่ก็ไม่มีอะไรเปลี่ยนเลย
โครงของ set กับกฎที่ใช้มีหน้าตาประมาณนี้ (แบบย่อ ตัดกฎอื่นของเครื่องทิ้ง)
table inet fw {
    set web4 { type ipv4_addr; flags interval; auto-merge; }
    set web6 { type ipv6_addr; flags interval; auto-merge; }

    chain input {
        type filter hook input priority 0; policy drop;
        ct state established,related accept
        ip  saddr @web4 tcp dport { 80, 443 } accept
        ip  saddr @web4 udp dport 443 accept
        ip6 saddr @web6 tcp dport { 80, 443 } accept
        ip6 saddr @web6 udp dport 443 accept
    }
}
include "/etc/web-allow/web-allow.nft"
บรรทัด udp 443 มีไว้ให้ QUIC ผ่าน ถ้าลืมจะเห็นว่าเบราว์เซอร์ที่ลอง HTTP/3 ช้าไปครู่หนึ่งก่อนถอยกลับ TCP ส่วนชนิด interval กับ auto-merge ทำให้ใส่เป็นช่วง CIDR ได้ตรง ๆ และเมื่อสองช่วงซ้อนกัน nft รวมให้เอง
ตัวสคริปต์ทำสามอย่างตามลำดับ ผมแยกเป็นฟังก์ชันเดียวจะได้ตามอ่านง่าย
import os, subprocess

def apply(v4, v6, final="/etc/web-allow/web-allow.nft"):
    new = final + ".new"
    body = []
    if v4: body.append("add element inet fw web4 { " + ", ".join(map(str, v4)) + " }")
    if v6: body.append("add element inet fw web6 { " + ", ".join(map(str, v6)) + " }")

    # 1) เขียนไฟล์ถาวรเป็น .new แล้วตรวจก่อน (include เสียหนึ่งไฟล์ = บูตมาไม่มีไฟร์วอลล์)
    with open(new, "w") as f:
        f.write("\n".join(body) + "\n")
    subprocess.run(["nft", "-c", "-f", new], check=True)

    # 2) อัปเดต set สดใน transaction เดียว ไม่มีช่วงที่ set ว่าง
    tx = "flush set inet fw web4\nflush set inet fw web6\n" + "\n".join(body) + "\n"
    subprocess.run(["nft", "-f", "-"], input=tx, text=True, check=True)

    # 3) ค่อยแทนไฟล์ถาวรเป็นขั้นสุดท้าย
    os.replace(new, final)
ลำดับนี้ผมเรียงจากสิ่งที่ผิดแล้วเสียหายน้อยที่สุดไปมากที่สุด ถ้า nft -c ไม่ผ่าน ไม่มีอะไรเปลี่ยนทั้งไฟล์จริงและ set สด ถ้า transaction ล้ม set สดยังเป็นของเดิม ไฟล์ถาวรก็ยังเป็นของเดิม เหลือขั้นสุดท้ายที่ os.replace ซึ่งเป็น rename ในไฟล์ซิสเต็มเดียวกัน เลยเป็นอะตอมมิกตามธรรมชาติของมัน
รีเจน real IP ของ nginx ในสคริปต์เดียวกัน
พอ origin รับแต่ CDN ปัญหาถัดมาคือ nginx จะเห็น IP ของ CDN เป็นต้นทางทุกคำขอ ล็อกกับ rate limit เลยใช้ไม่ได้ เหมือนเรื่องที่ผมเคยเจอใน ฟอร์มที่ส่งไม่ผ่านเพราะ IP หลัง proxy วิธีแก้คือบอก nginx ว่า IP ช่วงไหนเชื่อ header ได้ ช่วงนั้นก็คือช่วงของ CDN ชุดเดียวกับที่เพิ่งดึงมา ผมเลยให้สคริปต์เดียวกันรีเจนไฟล์ของ nginx ต่อท้าย
# generated by web-allow-updater - do not edit by hand
set_real_ip_from 203.0.113.0/24;      # ตัวอย่าง ช่วงจริงถูกเติมโดยสคริปต์
set_real_ip_from 198.51.100.0/24;
real_ip_header   X-Client-IP;         # ชื่อ header ตามที่ CDN ของคุณส่งมา
สคริปต์เขียนไฟล์นี้ แล้วรัน nginx -t ถ้าผ่านก็ reload ถ้าไม่ผ่านก็คืนไฟล์เดิม ไม่ปล่อยให้ nginx เจอ config เสียตอน reload ครั้งหน้า สองส่วนนี้ผูกกันเพราะสิ่งที่ไฟร์วอลล์เชื่อว่าเป็น CDN กับสิ่งที่ nginx เชื่อว่าเป็น CDN ควรเป็นชุดเดียวกันเสมอ ถ้าสองชุดไม่ตรงกัน ใครสักคนที่ไม่ใช่ CDN อาจปลอม header ได้
ทำไมไม่ใช้วิธีเพิ่มทีละช่วง ลบทีละช่วง
ตอนแรกผมคิดจะทำแบบฉลาดกว่านี้ คือเทียบรายการใหม่กับ set สด แล้วสั่ง add เฉพาะช่วงที่เพิ่ม delete เฉพาะช่วงที่หาย ข้อดีคือ set ไม่เคยถูกแตะส่วนที่ไม่เปลี่ยน แต่พอลองเขียนจริงผมเจอว่ามันซับซ้อนเกินคุ้ม เพราะ set ชนิด interval มี auto-merge ช่วงที่ผมใส่เข้าไปอาจถูกรวมกับช่วงข้าง ๆ ทำให้ช่วงที่ผมสั่ง delete ไม่มีอยู่ตรง ๆ ใน set แล้วคำสั่ง delete ทั้งก้อนล้มด้วย error ผมเสียเวลากับเรื่องนี้ไปราวชั่วโมงหนึ่งก่อนจะยอมถอย
ซับซ้อน ผิดง่าย
ต้องจำลองการรวมช่วงของ nft เอง ถ้าคำนวณไม่ตรงกับที่ nft รวมจริง delete ล้มทั้งชุด และสถานะกลางทาง ๆ ก็ตรวจยาก
ง่ายและเดาผลได้
ทุกรอบ set เท่ากับรายการที่เพิ่งผ่านด่านเป๊ะ ไม่มีสถานะสะสม ถ้าเกิดอะไรผิดก็รอบถัดไปแก้ให้เอง ราคาที่จ่ายคือส่งช่วงราวหนึ่งพันบรรทัดทุกรอบ ซึ่งเล็กมากสำหรับ kernel
สรุปคือผมเลือกแบบ flush ทั้งก้อนใน transaction เดียว เพราะ transaction ของ nft ทำให้ผู้สังเกตภายนอกไม่เห็นสถานะกลางอยู่แล้ว การ "flush" ในที่นี้เลยไม่ได้แปลว่า set ว่างจริง ๆ ในสายตาของแพ็กเก็ตที่ผ่านเข้ามา ข้อควรระวังเดียวคือห้ามแยกสองคำสั่งนี้เป็นสอง process ใช้ nft -f - ครั้งเดียวด้วยข้อความเดียวเท่านั้น
มีอีกเรื่องที่ผมเคยพลาดคือการชี้ไฟล์ถาวรด้วย path ที่ผู้ใช้ทั่วไปเขียนได้ ไฟล์ที่ถูก include ตอนบูตเป็นไฟล์ที่ root เป็นเจ้าของและรันด้วยสิทธิ์สูงสุด ผมเก็บไว้ในโฟลเดอร์ของมันเองที่ root เขียนได้คนเดียว ไม่เอาไว้ที่ /tmp
ทดสอบก่อนปล่อยให้ timer รันเอง
ผมไม่ปล่อยให้ timer ทำงานครั้งแรกโดยไม่เคยเห็นผล ทดสอบสามอย่างบนเครื่องที่ยังเข้าได้ทางอื่น
# 1) รันด้วยมือ แล้วเทียบ set สดกับไฟล์
python3 /usr/local/sbin/web-allow-update.py
nft list set inet fw web4 | head -n 20
nft list set inet fw web6 | head -n 20

# 2) ยัดไฟล์เสียแล้วดูว่า nft -c ปฏิเสธโดยไม่แตะของจริง
printf 'add element inet fw web4 { not-an-address }\n' > /tmp/bad.nft
nft -c -f /tmp/bad.nft; echo "exit=$?"

# 3) ปิดเครือข่ายออกแหล่งหนึ่ง (ให้ดึงล้ม) แล้วดูล็อกว่าใช้สำเนาเดิม
journalctl -u web-allow.service -n 30 --no-pager
ข้อที่สองสำคัญที่สุดสำหรับผม เพราะมันพิสูจน์ว่าด่านตรวจ syntax ทำงานจริงก่อนถึงของจริง ส่วนข้อสามผมจำลองด้วยการชี้แหล่งหนึ่งไปที่ที่อยู่ที่ไม่ตอบ แล้วดูว่าล็อกบอกว่าใช้สำเนาล่าสุดที่ดี และจำนวน prefix ของแหล่งนั้นเท่าเดิม
สิ่งที่ผมได้และที่ยังต้องระวัง
หลังเปิดใช้ คำขอแปลก ๆ ในล็อก nginx หายไปเกือบหมด เพราะมันไม่ถึง nginx อีกแล้ว ไฟร์วอลล์แค่ drop เงียบ ๆ ผมถือว่าได้ผลตามที่ตั้งใจ แต่มีข้อจำกัดสามข้อที่ควรรู้ ข้อแรก มันไม่ได้แทน WAF ตัวที่ผ่าน CDN มาก็ยังเป็นคำขอที่อาจเป็นการโจมตีได้ ข้อสอง ผมพึ่งความถูกต้องของรายการที่ผู้ให้บริการประกาศ ถ้าเขาประกาศผิดผมก็ผิดตาม ด่านตรวจกันได้แค่ของที่ผิดรูปแบบหรือกว้างเกินไป กันความผิดพลาดเชิงเนื้อหาไม่ได้ ข้อสาม ถ้ามีเครื่องมือเฝ้าดูเว็บจากภายนอก อย่าลืมใส่ช่วง IP ของมันเข้าลิสต์เอง ไม่งั้นจะเห็นเว็บ "ล่ม" ทุกครั้งที่ตรวจ
เรื่องที่ผมยังไม่ได้ทำคือแจ้งเตือนเมื่อจำนวน prefix ของแหล่งใดเปลี่ยนมากผิดปกติในรอบเดียว ตอนนี้ดูได้จากบรรทัดสรุปในล็อกด้วยตา ตรงไหนที่ผมอธิบายตกหรือโค้ดมีจุดที่ควรเข้มกว่านี้ เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย