เล่น 9 stem พร้อมกันในเบราว์เซอร์ นาฬิกาเดียว ไม่เพี้ยนตอน seek
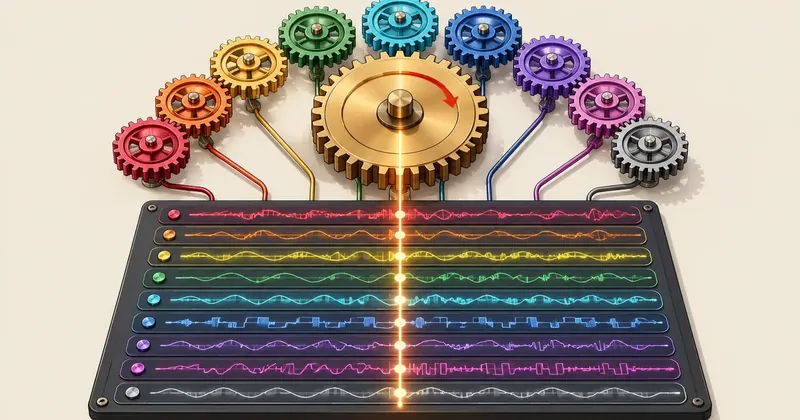
ถ้าเสียง 9 ชิ้นต้องตรงกันระดับมิลลิวินาที ห้ามให้มีนาฬิกาเกินหนึ่งเรือนในหน้าเดียว ผมเลยย้ายทุกอย่างไปอยู่ใต้ AudioContext ตัวเดียว แล้วให้ตำแหน่งเพลงมาจากนาฬิกาของเสียงเท่านั้น
สรุปใน 1 นาที
- อาการ/ปัญหา
- เปิดเสียง 9 สเต็มด้วยแท็ก audio แยกกันแล้วเสียงเหลื่อมและเพี้ยนตอน seek
- ใครควรอ่าน
- คนทำเครื่องเล่นหลายแทร็กในเบราว์เซอร์
- ทางแก้แบบสั้น
- Decode เป็น AudioBuffer แล้วสั่งทุก BufferSource start(origin, offset) บน AudioContext ตัวเดียว ให้ตำแหน่งเพลงมาจากนาฬิกาเสียง และใช้เซิร์ฟเวอร์ที่รองรับ HTTP Range
พอดีผมมีเพลงทดลองเพลงหนึ่งที่แยกออกมาเป็นไฟล์ WAV 9 สเต็ม ต้องการเปิดฟังในหน้าเว็บทีละชิ้นหรือพร้อมกัน กดปิดเสียงร้อง เปิดเฉพาะกลอง แล้วต้องตรงกับวิดีโอพรีวิวอีกตัวด้วย ผมเริ่มจากวิธีที่ใครก็คิดถึงก่อนคือแท็ก <audio> 9 ตัว สั่ง play() พร้อมกัน ได้ยินแล้วรู้ทันทีว่าไม่ไหว เสียงดูก้อง ๆ เหมือนเฟสเพี้ยน พอกด seek ไปกลางเพลงยิ่งแย่ ชิ้นหนึ่งไปถึงแล้ว อีกชิ้นยังโหลดไม่เสร็จ
บทความนี้เล่าว่าผมเปลี่ยนมาใช้ Web Audio API ตัวเดียวคุมทั้งหมดได้อย่างไร โค้ดเป็นเวอร์ชันที่เขียนใหม่ให้อ่านง่าย ชื่อไฟล์ ชื่อแทร็ก และพอร์ตผมใช้ชื่อกลาง ๆ หมด และสเต็มเป็นเสียงจากเพลงทดลองเท่านั้น
อาการ: แท็ก audio เก้าตัว เสียงเหลื่อมกันตอนเล่นและตอน seek
โค้ดรอบแรกหน้าตาเรียบง่ายมาก
// รอบแรก: แท็ก audio ตัวละสเต็ม
const stems = ['vocals', 'drums', 'bass' /* ... รวม 9 ตัว */].map(name => {
  const a = new Audio(`/audio/stems/${name}.wav`);
  a.preload = 'auto';
  return a;
});

function playAll() { stems.forEach(a => a.play()); }
function seekAll(t) { stems.forEach(a => { a.currentTime = t; }); }
มองผ่าน ๆ ก็ถูกต้องครับ แต่ทุกบรรทัดในนี้เป็นการส่งคำสั่งแยกกัน 9 ครั้ง และแต่ละแท็กมีขั้นตอนของตัวเอง คือ ต้องโหลดข้อมูลพอ ต้อง seek ในไฟล์ของตัวเอง ต้องรอเดคอดเดอร์ของตัวเอง แล้วค่อยเริ่มเล่นเมื่อมันพร้อม ไม่มีใครรับประกันว่าสองตัวจะเริ่มในจังหวะเดียวกัน
หลักการทั่วไปคือแท็ก audio หลายตัวเริ่มเหลื่อมกันได้หลายสิบมิลลิวินาทีเมื่อสั่งเล่นหรือ seek ผมไม่ได้เอาเครื่องมือมาวัดค่าความเหลื่อมจริงในงานนี้ เลยไม่ขอระบุตัวเลขเฉพาะ รู้แค่ว่าเสียงชิ้นเดียวกันที่ซ้อนกันเหลื่อมแค่ระดับนี้ก็ได้ยินเป็นเสียงก้องแล้ว
ทำไมต้องมีนาฬิกาเรือนเดียว
ปัญหาไม่ใช่ว่าเบราว์เซอร์เล่นเสียงไม่ดี ปัญหาคือแต่ละแท็กเป็นเครื่องเล่นอิสระที่มีเวลาเริ่มของตัวเอง ต่อให้ผมสั่งในลูปเดียวกัน ทั้ง 9 ตัวก็ไม่ได้เริ่มที่ขอบซัมเปิลเดียวกัน อีกเรื่องคือ currentTime ของแท็กแต่ละตัวค่อย ๆ ห่างกันได้เองเมื่อเวลาผ่านไป ไม่มีใครเอาไปเทียบกับตัวอื่น
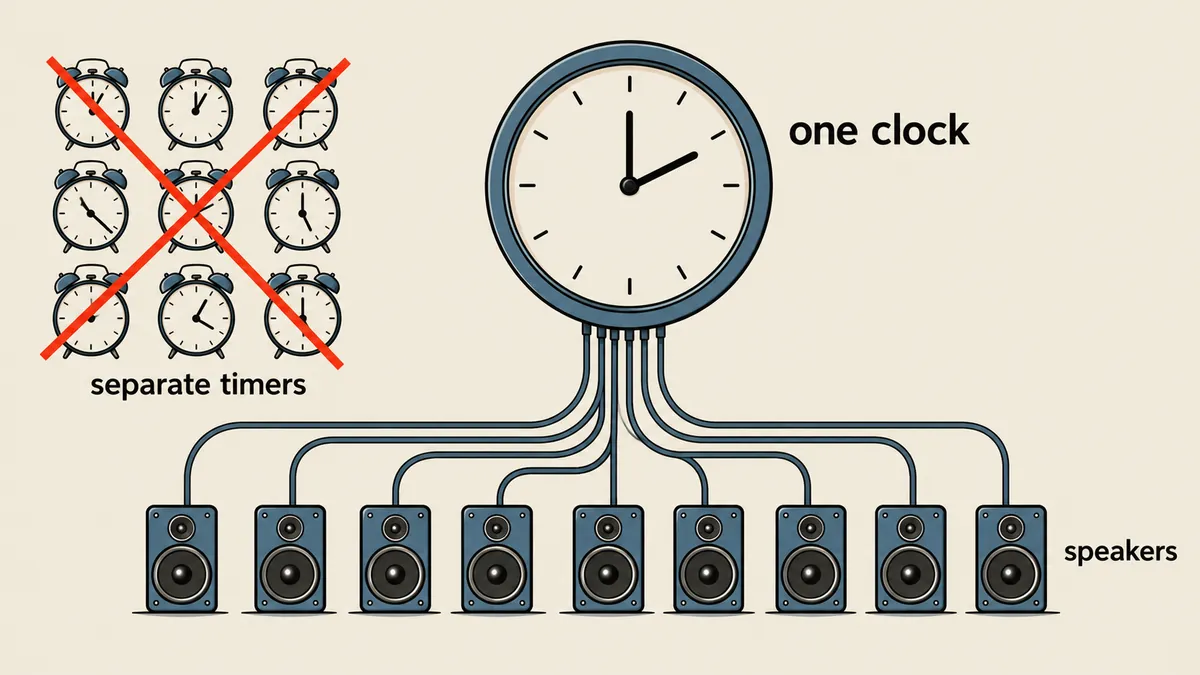
AudioContext มีนาฬิกาของมันเองคือ context.currentTime เป็นวินาทีแบบทศนิยม เดินตามฮาร์ดแวร์เสียงจริง และ source ทุกตัวที่อยู่ใต้ context เดียวกันสั่งเริ่มด้วยเวลาในนาฬิกานี้ได้ ผมเลยตัดสินใจเรื่องเดียวคือ ห้ามใช้ setInterval หรือ Date.now() หาตำแหน่งเพลง ตำแหน่งต้องคำนวณจาก context.currentTime ลบด้วยเวลาที่สั่งเริ่มเท่านั้น
โครงที่ใช้: decode ทั้งหมดเป็น AudioBuffer แล้วสั่ง start พร้อมกัน
หลักการมีสามข้อ ข้อแรกคือโหลด WAV ทุกไฟล์ด้วย fetch แล้ว decodeAudioData เป็น AudioBuffer ไว้ก่อนเล่น ข้อสองคือทุกครั้งที่กดเล่น สร้าง AudioBufferSourceNode ใหม่ 9 ตัว แล้วสั่ง start(origin, offset) ด้วยค่า origin เดียวกัน ข้อสามคือ origin ต้องล่วงหน้าไปจากตอนนี้เล็กน้อย ผมใช้ 25 มิลลิวินาที เพื่อให้ทั้ง 9 คำสั่งถูกจัดตารางเสร็จก่อนถึงเวลาเริ่ม ถ้าตั้ง origin = currentTime พอดี ตัวที่ถูกสั่งทีหลังในลูปจะพลาดจังหวะเริ่มไปนิดหนึ่ง
โค้ดหลักที่เขียนใหม่ให้อ่านง่ายจากของจริง (ของจริงยาวประมาณ 17 บรรทัดแต่บีบเป็นบรรทัดยาว)
// stem-transport.js — เวอร์ชันย่อ ใช้ได้กับ config ด้านล่าง
class StemTransport extends EventTarget {
  constructor(config) {
    super();
    this.config = config;                 // { duration, masterGain, tracks: [{id, src}] }
    this.duration = config.duration;      // 192.8 วินาที
    this.tracks = config.tracks.map(t => ({ ...t, muted: false, solo: false, gain: 1 }));
    this.paused = true;
    this._position = 0;                   // ตำแหน่งตอนหยุด (วินาที)
    this._origin = 0;                     // เวลา context ตอนสั่งเริ่ม
    this._sources = [];
  }

  async load() {
    if (this.loaded) return;
    this.context ??= new AudioContext({ sampleRate: 48000 });
    this.master = this.context.createGain();
    this.master.gain.value = this.config.masterGain;      // 0.8854
    this.master.connect(this.context.destination);
    this.buffers = new Map(); this.gains = new Map();

    for (const t of this.tracks) {
      const res = await fetch(t.src);
      if (!res.ok) throw new Error('โหลดแทร็กไม่สำเร็จ: ' + t.id);
      const buf = await this.context.decodeAudioData(await res.arrayBuffer());
      if (Math.abs(buf.duration - this.duration) > 0.01)
        throw new Error('ความยาวแทร็กไม่ตรงกัน: ' + t.id);   // กันไฟล์ผิดชุดตั้งแต่ต้น
      const g = this.context.createGain();
      g.connect(this.master);
      this.buffers.set(t.id, buf); this.gains.set(t.id, g);
    }
    this.loaded = true;
  }

  get currentTime() {
    if (this.paused) return this._position;
    const run = Math.max(0, this.context.currentTime - this._origin);
    return Math.min(this.duration, this._position + run);   // ตำแหน่งมาจากนาฬิกาเสียง
  }

  _startSources() {
    this._stopSources();
    this._origin = this.context.currentTime + 0.025;        // ล่วงหน้า 25 ms
    for (const t of this.tracks) {
      const s = this.context.createBufferSource();
      s.buffer = this.buffers.get(t.id);
      s.connect(this.gains.get(t.id));
      s.start(this._origin, this._position);                // ทุกตัวใช้ origin เดียวกัน
      this._sources.push(s);
    }
  }

  _stopSources() {
    for (const s of this._sources) { try { s.stop(); } catch (e) {} s.disconnect(); }
    this._sources = [];
  }
}
ตรงที่เทียบความยาว buf.duration กับ this.duration ผมใส่ไว้เพราะถ้าสเตมหนึ่งสั้นหรือยาวกว่าตัวอื่นแม้นิดเดียว เสียงจะเหลื่อมกันเงียบ ๆ โดยไม่มีอะไรฟ้อง ให้โยน error ระบุชื่อแทร็กออกมาตั้งแต่ตอนโหลดดีกว่า config ของงานนี้เป็น JSON ง่าย ๆ
{
  "duration": 192.8,
  "masterGain": 0.885369738339,
  "tracks": [
    { "id": "vocals",         "src": "/audio/stems/vocals.wav" },
    { "id": "backing-vocals", "src": "/audio/stems/backing-vocals.wav" },
    { "id": "keys",           "src": "/audio/stems/keys.wav" },
    { "id": "guitar",         "src": "/audio/stems/guitar.wav" },
    { "id": "bass",           "src": "/audio/stems/bass.wav" },
    { "id": "drums",          "src": "/audio/stems/drums.wav" },
    { "id": "percussion",     "src": "/audio/stems/percussion.wav" },
    { "id": "strings",        "src": "/audio/stems/strings.wav" },
    { "id": "fx",             "src": "/audio/stems/fx.wav" }
  ]
}
ค่า masterGain มาจาก min(1, 0.95 / peak ของผลรวมทุกสเตม) ผลรวมของทั้ง 9 ชิ้นเปิดพร้อมกันมี peak ประมาณ 1.073 ถ้าไม่ลดเสียงมีโอกาสแตกตอนเปิดครบ ผมเลยลดให้เหลือเพดาน 0.95
seek, mute และ solo โดยไม่มีเสียงคลิก
AudioBufferSourceNode เริ่มซ้ำไม่ได้ครับ เรียก start ได้ครั้งเดียวตลอดชีวิตของมัน เพราะฉะนั้น seek คือทิ้งของเก่าทั้ง 9 ตัวแล้วสร้างใหม่ ไม่ใช่การเลื่อนตำแหน่ง ฟังดูเปลืองแต่ source เป็นแค่ตัวชี้ไปที่ buffer ที่ decode ไว้แล้ว ไม่มีการอ่านไฟล์ซ้ำ
// เสริมใน StemTransport
set currentTime(t) {
  t = Math.max(0, Math.min(this.duration, Number(t) || 0));
  const playing = !this.paused;
  this._stopSources();
  this._position = t;                   // ตำแหน่งใหม่
  if (playing) this._startSources();    // origin ใหม่ + start(origin, t) ครบ 9 ตัว
  this.dispatchEvent(new Event('seeked'));
}

_applyGains() {
  const now = this.context.currentTime;
  const anySolo = this.tracks.some(t => t.solo);
  for (const t of this.tracks) {
    const audible = !t.muted && (!anySolo || t.solo);
    // เปลี่ยนค่าแบบนุ่ม ค่าคงที่เวลา 15 ms ไม่ตัดสัญญาณทันที เลยไม่มีเสียงคลิก
    this.gains.get(t.id).gain.setTargetAtTime(audible ? t.gain : 0, now, 0.015);
  }
}
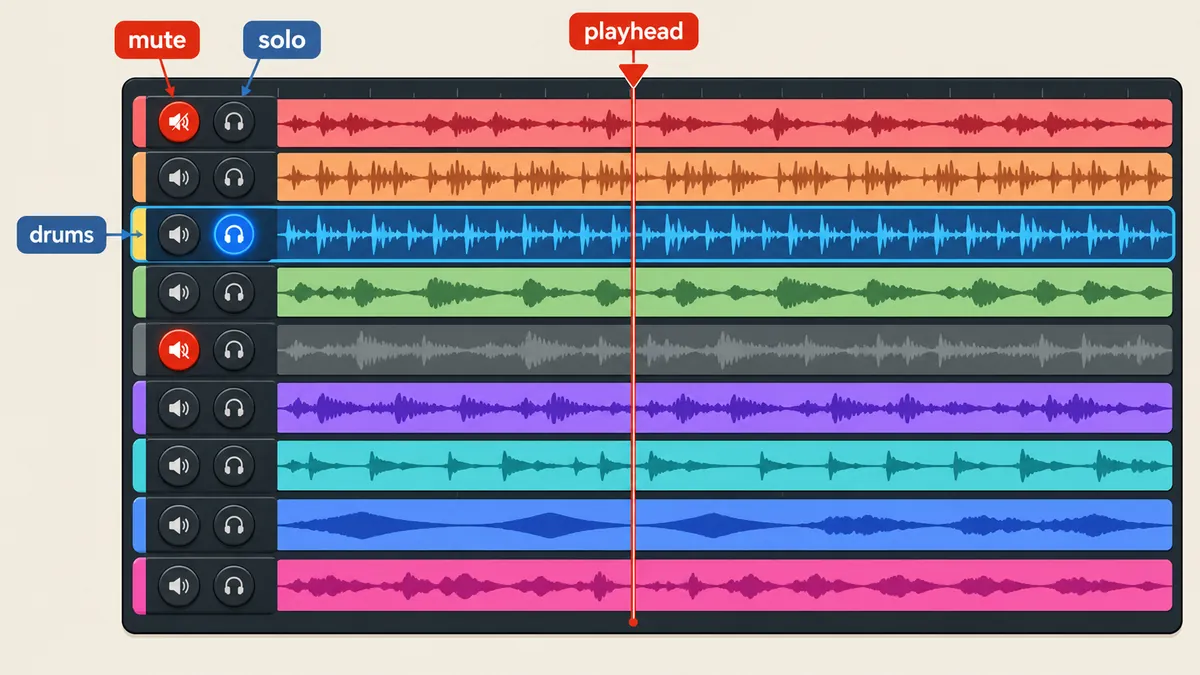
สาเหตุที่ไม่ตั้ง gain.value = 0 ตรง ๆ คือการตัดคลื่นกลางรอบทำให้เกิดเสียงกริ๊กที่ได้ยินชัด setTargetAtTime ค่อย ๆ ไหลไปหาเป้าหมายตามเส้นโค้งเอ็กซ์โพเนนเชียล ค่าคงที่เวลา 15 มิลลิวินาทีสั้นพอให้ปุ่มรู้สึกฉับไว แต่ยาวพอให้คลื่นเรียบ กติกาเสียงที่ได้ยินคือ audible = !muted && (!anySolo || solo) ถ้ามีสเตมใดสเตมหนึ่งกด solo อยู่ ตัวอื่นทั้งหมดเงียบ ถ้าไม่มี solo ก็ตามสถานะ mute ของแต่ละตัว
ส่วนปุ่มลัดที่ใช้บ่อยสุดสามแบบ ทำจากสถานะ solo กับ mute ชุดเดียวกัน
solo เสียงร้องนำ
ตั้ง solo ที่สเตมร้องนำสเตมเดียว ตัวอื่นเงียบทั้งหมดผ่านสูตร audible ไม่ต้องเขียนเงื่อนไขพิเศษ
mute ร้องนำกับร้องประสาน
ปิดสองสเตมที่เป็นเสียงคน เหลือเครื่องดนตรีครบทั้ง 7 ชิ้น
ปุ่มเล่นเป็น async: กันกดเร็วระหว่างโหลด
play() ในเครื่องเล่นนี้เป็น async เพราะต้องรอสองอย่างก่อนเสียงออก คือ context.resume() ซึ่งเบราว์เซอร์จะอนุญาตก็ต่อเมื่อมาจากการกดของผู้ใช้ กับ load() ที่ decode ไฟล์ครบ ปัญหาที่ต้องกันไว้คือถ้าผู้ใช้กดเล่นแล้วกดหยุดทันทีระหว่างที่ยังโหลดอยู่ พอโหลดเสร็จเครื่องเล่นอาจเริ่มเล่นเองทั้งที่ผู้ใช้สั่งหยุดไปแล้ว ผมกันด้วยตัวนับ _intent
async play() {
  const intent = ++this._intent;           // จำว่าคำสั่งนี้คือรอบที่เท่าไร
  this.context ??= new AudioContext({ sampleRate: 48000 });
  await this.context.resume();
  await this.load();
  if (intent !== this._intent) return;     // มี pause หรือ play ใหม่แทรกระหว่างรอ -> ยกเลิก
  if (!this.paused) return;
  if (this._position >= this.duration) this._position = 0;
  this.paused = false;
  this._startSources();
}

pause() {
  this._intent++;                          // ทำให้ play ที่ค้างอยู่หมดอายุ
  if (!this.paused) this._position = this.currentTime;
  this._stopSources();
  this.paused = true;
}
ลูปที่อัปเดตแถบเลื่อนใช้ requestAnimationFrame อ่าน currentTime ซึ่งคำนวณจากนาฬิกาเสียงอยู่แล้ว ลูปเลยเป็นแค่ตัววาดภาพ ถ้าเฟรมตก เสียงไม่กระตุกตามเพราะเสียงไม่ได้ขึ้นกับลูปนี้เลย
ราคาที่ต้องจ่าย: decode ทั้งหมดแล้ว RAM พุ่ง
วิธีนี้ไม่ฟรี decodeAudioData แปลง WAV เป็น float32 ทั้งไฟล์ในหน่วยความจำ ตัวเลขข้างล่างเป็นการคำนวณ ไม่ได้วัดหน่วยความจำจริงของเบราว์เซอร์
คำนวณคือ 192.8 x 48,000 x 2 x 4 = 74,035,200 ไบต์ต่อสเตม คูณ 9 ได้ราว 666 ล้านไบต์ ถ้าเป็นเพลงสามนาทีบนเครื่องที่มี RAM เหลือก็ไหว แต่ไม่เหมาะกับไฟล์ยาวเป็นชั่วโมงแน่นอน กรณีนั้นต้องคิดใหม่เป็นการ stream ทีละช่วง ซึ่งยากกว่ามากเพราะต้องจัดตารางต่อกันเอง
ตัวเลข 666 MB เป็นการประมาณของไฟล์ที่ผมใช้ ผมใช้เครื่องเล่นนี้บนคอมพิวเตอร์เครื่องเดียวสำหรับตรวจงานตัวเอง ไม่ได้เปิดให้ใครอื่นใช้ ถ้าจะเอาไปทำหน้าเว็บสาธารณะต้องวัดกับเครื่องเป้าหมายก่อน อย่าเชื่อตัวเลขของผม
เซิร์ฟเวอร์พรีวิวที่รองรับ HTTP Range บน loopback
เปิดไฟล์ HTML ตรง ๆ ด้วย file:// ใช้ไม่ได้ครับ เบราว์เซอร์ไม่ให้ fetch ไฟล์เสียงขึ้นมา decode จากต้นทางแบบ file และถ้าหน้าพรีวิวมี <video> ด้วย ตัววิดีโอต้องการ HTTP Range เพื่อ seek ไปกลางไฟล์ python -m http.server ธรรมดาไม่ตอบ Range ผมเลยเขียนเซิร์ฟเวอร์ static เล็ก ๆ เองให้ผูกเฉพาะ 127.0.0.1 และไม่มี API เขียนหรือเผยแพร่อะไรทั้งสิ้น
# serve_preview.py — static เฉพาะ loopback รองรับ Range ช่วงเดียว
from pathlib import Path
from http.server import ThreadingHTTPServer, SimpleHTTPRequestHandler
from urllib.parse import urlsplit

ROOT = Path(__file__).resolve().parent

class Handler(SimpleHTTPRequestHandler):
    def __init__(self, *a, **kw):
        super().__init__(*a, directory=str(ROOT), **kw)

    def do_GET(self):
        if urlsplit(self.path).path == '/':
            self.send_response(302); self.send_header('Location', '/preview.html')
            self.end_headers(); return
        super().do_GET()

    def send_head(self):
        self.remaining = None
        path = Path(self.translate_path(self.path)).resolve()
        if not path.is_relative_to(ROOT):                 # กันออกนอกโฟลเดอร์
            self.send_error(403); return None
        if not path.is_file():
            return super().send_head()
        size = path.stat().st_size
        start, end, partial = 0, size - 1, False
        spec = self.headers.get('Range')
        if spec:
            try:
                unit, value = spec.split('=', 1)
                assert unit == 'bytes' and ',' not in value   # รับช่วงเดียวเท่านั้น
                a, b = value.split('-', 1)
                if a:
                    start = int(a)
                    if b: end = min(int(b), end)
                else:
                    start = max(0, size - int(b))             # รูปแบบ bytes=-N
                assert 0 <= start <= end < size
                partial = True
            except (ValueError, AssertionError):
                self.send_response(416)
                self.send_header('Content-Range', f'bytes */{size}')
                self.end_headers(); return None
        f = path.open('rb'); f.seek(start)
        self.remaining = end - start + 1
        self.send_response(206 if partial else 200)
        self.send_header('Content-Type', self.guess_type(str(path)))
        self.send_header('Content-Length', str(self.remaining))
        self.send_header('Accept-Ranges', 'bytes')
        self.send_header('Cache-Control', 'no-cache')
        if partial:
            self.send_header('Content-Range', f'bytes {start}-{end}/{size}')
        self.end_headers(); return f

    def copyfile(self, source, output):
        if self.remaining is None:
            return super().copyfile(source, output)
        left = self.remaining
        try:
            while left:
                data = source.read(min(left, 256 * 1024))
                if not data: break
                output.write(data); left -= len(data)
        except (BrokenPipeError, ConnectionResetError):
            pass

ThreadingHTTPServer(('127.0.0.1', 8800), Handler).serve_forever()
จุดที่ผมเขียนเองเข้มกว่าปกติมีสามอย่าง ช่วง Range ที่มีเครื่องหมายจุลภาคปฏิเสธเลย เพราะไม่ได้รองรับหลายช่วง รูปแบบ bytes=-N รองรับเพราะเบราว์เซอร์ใช้ขอท้ายไฟล์ และช่วงที่ผิดรูปหรือเกินขนาดตอบ 416 พร้อม Content-Range: bytes */ขนาด ตามมาตรฐาน ส่วน Cache-Control: no-cache ตั้งไว้เพราะระหว่างทำงานผมเขียนทับไฟล์พรีวิวบ่อย จะได้ไม่ต้องล้างแคช ทดสอบด้วย curl ได้เลย
# ขอเฉพาะ 4 ไบต์แรก ควรได้ 206 พร้อม Content-Range
curl -s -D - -o /dev/null -H "Range: bytes=0-3" http://127.0.0.1:8800/audio/stems/vocals.wav

# ขอเกินขนาดไฟล์ ควรได้ 416
curl -s -D - -o /dev/null -H "Range: bytes=999999999999-" http://127.0.0.1:8800/audio/stems/vocals.wav

# ลองออกนอกโฟลเดอร์ ควรได้ 403 หรือ 404 ไม่ใช่เนื้อไฟล์
curl -s -o /dev/null -w "%{http_code}\n" --path-as-is http://127.0.0.1:8800/../secret.txt
เซิร์ฟเวอร์นี้ไม่มีระบบยืนยันตัวตนเลย ที่ปลอดภัยพอเพราะมันฟังเฉพาะ 127.0.0.1 เครื่องอื่นในเครือข่ายต่อเข้ามาไม่ได้ ถ้าเปลี่ยนเป็น 0.0.0.0 เมื่อไรต้องมาคิดเรื่องสิทธิ์ใหม่ทั้งหมด
ลำดับที่ผมใช้ตั้งเครื่องเล่นแบบนี้
- ตั้งเซิร์ฟเวอร์ static ที่ตอบ Range บน loopback ก่อน ห้ามเปิดหน้าด้วย file://
- เตรียม config JSON ที่ระบุความยาวเป้าหมายและ masterGain ที่คำนวณจาก peak ของผลรวม
- decode ทุกสเตมแล้วเทียบความยาวกับ config ไม่ตรงให้โยน error ระบุชื่อแทร็ก
- ทุกครั้งที่เริ่มเล่นหรือ seek ให้สร้าง BufferSource ใหม่ 9 ตัว start(origin, offset) ด้วย origin = currentTime + 0.025
- อ่านตำแหน่งจาก context.currentTime - origin เท่านั้น อย่าใช้ setInterval
- mute กับ solo เปลี่ยนแค่ gain ผ่าน setTargetAtTime ค่าคงที่ 15 ms
- ตั้งตัวนับ intent ให้ play ที่ค้างอยู่ตอนโหลดถูกยกเลิกเมื่อกด pause
เครื่องเล่นนี้เป็นภาคแรกของชุด ภาคสองคือการเอาเสียงชุดนี้ไปเป็นนาฬิกาหลักให้วิดีโอพรีวิว เล่าไว้ใน พรีวิวตัด MV ในหน้าเว็บเดียว ใช้เสียงเป็นนาฬิกา วิดีโอสองตัวสลับกัน ตรงนั้นผมพึ่งตัวเลข currentTime ของเครื่องเล่นตัวนี้ทั้งหมด
สิ่งที่ผมได้จากงานนี้คือ ถ้าต้องการให้หลายสิ่งตรงกัน ให้หาเรือนเวลาเรือนเดียวที่ทุกสิ่งอ่านจากมัน แล้วเลิกสั่งแต่ละสิ่งให้เริ่มด้วยวิธีของตัวเอง ผมไม่ได้วัดความเหลื่อมของแท็ก audio จริง ตัวเลข 666 MB ก็เป็นค่าคำนวณ ส่วนสคริปต์ตรวจพรีวิวอัตโนมัติที่มีอยู่ในโปรเจกต์ผมยังไม่ได้ย้อนอ่านซ้ำ เลยไม่ขออ้างผลของมัน ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย