AdSense บอก ads.txt "ไม่พบ" ทั้งที่ไฟล์อยู่ — ไล่ log พิสูจน์ทีละชั้น

"Google มองไม่เห็นไฟล์เรา" คือเคสที่เดาไปก็ผิดไป — วิธีเดียวที่ให้คำตอบชัวร์คือเดินตามเส้นทางเดียวกับ crawler แล้วเปิด access log ดูว่าเขาเคยมา แล้วได้อะไรกลับไป
พอดีหน้า Sites ของ AdSense ขึ้นสถานะ ads.txt ว่า "ไม่พบ" ทั้งที่ ssh เข้าไปดู ไฟล์อยู่ตรงนั้นชัดๆ เนื้อหาถูกต้อง คำถามแรกที่ผุดขึ้นมาคือ "หรือ firewall เราไปบล็อค crawler ของ Google?" — เซิร์ฟเวอร์ที่ผมดูแลมีทั้ง CSF, ModSecurity, ตัวกรอง bot อีกชั้น ผู้ต้องสงสัยเพียบ
แทนที่จะเดา ผมไล่พิสูจน์ทีละชั้นจนเจอคำตอบ (สปอยล์: ไม่มีใครบล็อคเลย) — วิธีไล่นี่แหละที่อยากแชร์ เอาไปใช้กับเคส "Google มองไม่เห็นไฟล์เรา" ได้ทุกแบบ IP ในบทความเป็นค่าสมมติ (203.0.113.10)
ชั้นที่ 1: ไฟล์อยู่จริงไหม เสิร์ฟถูกไหม
cat /home/user/domains/example.org/public_html/ads.txt
# google.com, pub-XXXXXXXXXXXXXXXX, DIRECT, f08c47fec0942fa0
stat -c '%y' .../ads.txt   # ดูวันที่สร้างไฟล์ไว้ด้วย — จะสำคัญตอนท้าย
ชั้นที่ 2: ยิงเทสด้วย UA ของ Google
ตัวกรอง bot ส่วนใหญ่ดูที่ User-Agent เพราะฉะนั้นต้องเทสด้วย UA ที่ Google ใช้จริง:
IP=203.0.113.10   # IP เซิร์ฟเวอร์เรา
for ua in 'curl/8.0' 'Mediapartners-Google' \
          'Mozilla/5.0 (compatible; Google-adstxt)' \
          'Mozilla/5.0 (compatible; Googlebot/2.1)'; do
  code=$(curl -sk --resolve example.org:443:$IP -A "$ua" \
         -o /dev/null -w '%{http_code}' https://example.org/ads.txt)
  echo "[$code] $ua"
done
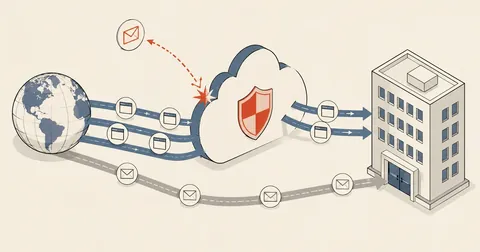
ได้ 200 ทุก UA แสดงว่า origin ไม่กรอง — แต่ยังสรุปไม่ได้ เพราะเว็บอยู่หลัง Cloudflare ซึ่ง Google วิ่งผ่าน CF ไม่ได้วิ่งตรงมาหาเรา
ชั้นที่ 3: เทสผ่าน Cloudflare edge จริง
จุดพลาดคลาสสิกครับ: เทสจากเซิร์ฟเวอร์ตัวเอง DNS อาจ resolve ลัดเข้า localhost ไม่ผ่าน CF ต้องบังคับ resolve ไป IP ของ CF edge ให้เดินเส้นเดียวกับที่ Google เดิน:
dig +short example.org A          # ได้ IP CF เช่น 104.21.x.x
curl -sk --resolve example.org:443:104.21.x.x \
  -A 'Mozilla/5.0 (compatible; Googlebot/2.1)' \
  -D - https://example.org/ads.txt | head -20
# HTTP/2 200 / content-type: text/plain / cf-cache-status: DYNAMIC + เนื้อไฟล์ถูกต้อง
อย่าลืมเทส redirect ด้วย เพราะ crawler เริ่มที่ http:
curl -sk -A 'Mediapartners-Google' -o /dev/null \
  -w '%{http_code} -> %{redirect_url}\n' http://example.org/ads.txt
# 301 -> https://example.org/ads.txt   (hop เดียว โดเมนเดิม = โอเคตาม spec)
และ www / non-www ต้องได้ไฟล์เดียวกันทั้งคู่
ชั้นที่ 4: หลักฐานชี้ขาด — access log
ทุกอย่างข้างบนคือ "ตอนนี้เข้าได้" แต่คำถามจริงคือ "Google เคยมา แล้วได้อะไรกลับไป" — log ตอบได้:
zgrep -h 'ads.txt' /var/log/nginx/domains/example.org.log* | grep -i google
# 66.249.79.1  "GET /ads.txt HTTP/1.1" 301 162  Googlebot   <- เริ่มที่ http
# 66.249.79.6  "GET /ads.txt HTTP/2.0" 200 85   Googlebot   <- ตาม redirect มา ได้ไฟล์
# หา 4xx/5xx:
zgrep -h 'ads.txt' ...log* | grep -i google | awk '$9!~/200|301/'
# (ว่าง = Google ไม่เคยโดนปฏิเสธเลย)
response ให้ Googlebot ขนาด 85 bytes ทั้งที่ไฟล์เรา 59 bytes — อย่าเพิ่งตกใจว่าเสิร์ฟผิดไฟล์ครับ นั่นคือ gzip ของไฟล์ 59 bytes (ไฟล์เล็กมาก บีบแล้ว overhead ทำให้ใหญ่ขึ้น) crawler ส่ง Accept-Encoding: gzip มา log เลยบันทึกขนาดหลังบีบ
เครื่องที่รัน nginx คั่นหน้า apache — request เดียวโผล่ทั้งสอง log ฝั่ง nginx บอกส่ง 59 bytes (ไฟล์ถูก) ฝั่ง apache บอก 4738 bytes (HTML ของแอป) ไล่จนพบว่า nginx เสิร์ฟไฟล์ static ให้ client เองแล้ว ส่วนสำเนา request ที่ proxy ไป apache คำตอบถูกทิ้ง ไม่เคยถึง client — พิสูจน์ด้วยการยิง 1 request ที่ UA ไม่ซ้ำใคร (-A 'TRACE-1') แล้ว grep ทั้งสอง log เทียบกัน ถ้าไม่พิสูจน์ตรงนี้คงนั่งแก้ผีไปอีกนาน
สรุปคดี: ไม่มีใครบล็อค — มันคือ "สถานะค้าง"
หลักฐานประกอบกัน:
- ไฟล์ ads.txt เพิ่งถูกสร้างตอน rebuild เว็บ (ดูจาก
stat) - สถานะ "ไม่พบ" ใน AdSense ประทับเวลาก่อนหน้านั้นไม่นาน — คือผลเช็คจากรอบที่ไฟล์ยังไม่มีอยู่จริง
- สถานะหน้า Sites ของ AdSense ไม่ใช่ realtime — refresh ห่างเป็นวันถึงหลายสัปดาห์ โดยเฉพาะไซต์ใหม่
- log ยืนยัน Google fetch รอบใหม่ได้ 200 ไปแล้ว
รอสองสามวัน สถานะพลิกเป็นเขียวเองครับ ไม่ต้องแก้อะไรที่เซิร์ฟเวอร์เลย
บทเรียน
- "Google มองไม่เห็น" อย่าเพิ่งโทษ firewall — ไล่จาก log ไม่ใช่จากความกลัว
- เทสต้องเดินเส้นเดียวกับ crawler: ผ่าน CF edge, เริ่มที่ http, ใช้ UA จริง, เทสทั้ง www/non-www
- ขนาดใน log ไม่ตรงขนาดไฟล์ ไม่ได้แปลว่าเสิร์ฟผิด — คิดถึง gzip ก่อน
- สถานะใน dashboard ของ Google มี lag เสมอ — ให้น้ำหนักกับ access log ของเรามากกว่าป้ายสถานะของเขา
ส่วนตัวผมถือคติเดียวกับทุกเคส forensics: อย่าแก้อะไรจนกว่าจะมีหลักฐานว่ามันพังจริง เคสนี้ถ้ารีบไปรื้อ firewall ตามความกลัว ได้เสียของแน่ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai

ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย