โค้ดชุดเดียวสองบทบาท เว็บอยู่โฮสต์ worker อยู่เครื่องที่บ้าน

ตอนแรกผมคิดจะแยกโค้ดเป็นสองรีโป ทำไปได้ครึ่งวันก็รู้ตัวว่ากำลังสร้างภาระให้ตัวเองไปตลอดชีวิต ทางที่ถูกคือโค้ดยังเป็นชุดเดียว แล้วให้ค่าตัวแปรเดียวตัดสินว่าเครื่องนี้จะสวมบทบาทไหน
พอดีระบบหลังบ้านที่ผมดูแลอยู่ตัวหนึ่งมันโตจนอึดอัด ตอนเริ่มมันคือ Laravel ตัวเดียววางอยู่บนเครื่องเดสก์ท็อปที่ออฟฟิศ เว็บก็อยู่นั่น ฐานข้อมูลก็อยู่นั่น คิวงานก็อยู่นั่น งานที่ต้องเรียกโปรแกรมภายนอกหนัก ๆ อย่างอ่านเอกสาร แปลงไฟล์ ถอดเสียง ก็อยู่นั่นหมด ทำงานได้ดีมากจนถึงวันที่เน็ตออฟฟิศหลุดยาว แล้วทีมทั้งทีมใช้อะไรไม่ได้เลยสักอย่าง
ผมเลยนั่งเขียนแผนแยกระบบ หลักที่ตั้งไว้ก่อนเริ่มคือห้ามแตกโค้ดเป็นสองชุด เพราะรู้ตัวดีว่าถ้าแตกเมื่อไหร่ อีกสามเดือนสองฝั่งจะไม่เหมือนกันแล้ว บทความนี้คือโครงที่ออกมา พร้อมของที่เอาไปใช้ต่อได้ทันที
ชื่อโฮสต์ พาธ ชื่อฐานข้อมูล และชื่อโมดูลในบทความเป็นค่าตัวอย่าง โครงและโค้ดเป็นของจริง
ปัญหาคือทุกอย่างกองอยู่เครื่องเดียว
รายการที่แขวนอยู่บนเครื่องนั้นเครื่องเดียวมีประมาณนี้ — หน้าเว็บที่ทีมเปิดทั้งวัน, ปลายทางรับ webhook จากระบบข้อความภายนอก, ฐานข้อมูล, คิวงาน, และงานที่ต้องเรียกโปรแกรมในเครื่องอีกเจ็ดแปดชนิด เครื่องดับเมื่อไหร่ ข้อความที่ลูกค้าส่งเข้ามาระหว่างนั้นก็หายไปด้วย เพราะไม่มีใครรับ
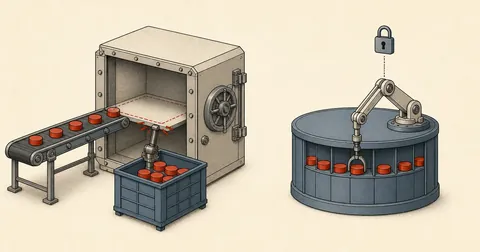
เครื่องเดียวถือทุกบทบาท
เครื่องรีบูต เน็ตหลุด หรือคนไปถอดปลั๊กผิดตัว = เว็บดับ ข้อความขาเข้าหาย งานเบื้องหลังหยุด ทีมรออย่างเดียว ไม่มีอะไรทำงานต่อได้เลย
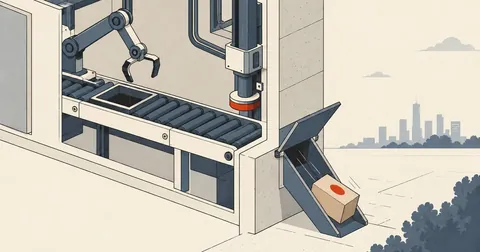
เว็บอยู่โฮสต์ที่เปิดตลอด งานหนักอยู่เครื่องที่บ้าน
เครื่องที่บ้านดับ = เว็บยังใช้ได้ครบ ข้อความยังเข้าระบบปกติ เฉพาะงานที่ต้องใช้โปรแกรมในเครื่องเท่านั้นที่ค้างคิวไว้ แล้วทำต่อเมื่อกลับมา
ข้อสำคัญของเป้าหมายนี้คือคำว่า "ค้างคิวไว้" ไม่ใช่ "หาย" งานที่ทำไม่ได้ตอนนี้ต้องยังอยู่ครบให้ทำทีหลัง ถ้าออกแบบแล้วงานหายตอนเครื่องดับ ก็เท่ากับย้ายปัญหาไปที่อื่นเฉย ๆ
หลักสี่ข้อที่ตั้งไว้ก่อนเขียนโค้ดสักบรรทัด
ผมเขียนสี่ข้อนี้ไว้บนกระดาษก่อน แล้วทุกครั้งที่ไม่แน่ใจว่าจะออกแบบทางไหน ก็กลับมาอ่านสี่ข้อนี้
- โค้ดชุดเดียวสองบทบาท — ตัดสินด้วย `APP_ROLE=web` หรือ `APP_ROLE=worker` ใน .env เท่านั้น ไม่แตกรีโป ไม่แตก branch
- ทิศเดียว: worker วิ่งมาดึงจากเว็บ — ฝั่งเว็บไม่ต้องรู้จักเครื่อง worker ไม่มีอะไรวิ่งเข้าหา worker เลย
- ส่งออกทุกอย่างทำที่ฝั่งเว็บ — worker คืนแค่ "ผลลัพธ์" สถานะการส่งอยู่ที่เดียว
- ไฟล์อยู่ที่เก็บกลาง — ทั้งสองฝั่งมองเห็นไฟล์ชุดเดียวกัน ไม่มีใครถือไฟล์ไว้คนเดียว
ข้อสองเป็นข้อที่จ่ายผลตอบแทนสูงที่สุด พอ worker เป็นฝ่ายวิ่งเข้ามาดึงเอง เครื่องที่บ้านไม่ต้องมีทางเข้าจากอินเทอร์เน็ตเลยสักทาง ไม่ต้องเปิดพอร์ต ไม่ต้องมีโดเมน ไม่ต้องมีอุโมงค์ และที่สำคัญกว่านั้นคือเครื่อง worker ดับแล้วไม่มีอะไรพัง มีแค่งานกองรออยู่ในตารางเท่านั้น
APP_ROLE ตัวเดียวครอบทั้ง scheduler route และ command
ของที่ต้องแยกตามบทบาทจริง ๆ มีแค่สามที่ — งานตามเวลา, route ฝั่ง worker, และคำสั่งที่ต้องเรียกโปรแกรมในเครื่อง ที่เหลือโค้ดเหมือนกันทุกบรรทัด
# .env ฝั่งโฮสต์เว็บ
APP_ROLE=web
DB_HOST=127.0.0.1
QUEUE_CONNECTION=redis
FILESYSTEM_DISK=s3
WORKER_TOKEN=<TOKEN>

# .env ฝั่งเครื่องที่บ้าน
APP_ROLE=worker
WEB_API_BASE=https://app.example.com
WORKER_TOKEN=<TOKEN>
FILESYSTEM_DISK=s3
ตัว helper สั้น ๆ ตัวเดียว แล้วเรียกใช้ได้ทั้งระบบ
// app/helpers.php
function app_role(): string
{
    return config('app.role', 'web');   // config/app.php: 'role' => env('APP_ROLE', 'web')
}

function is_web(): bool    { return app_role() === 'web'; }
function is_worker(): bool { return app_role() === 'worker'; }
งานตามเวลาครอบทั้งก้อนไปเลย ไม่ต้องมาไล่ทีละบรรทัด
// routes/console.php
if (is_web()) {
    Schedule::command('mail:fetch')->everyFiveMinutes();
    Schedule::command('docs:vault')->everyMinute();
    Schedule::command('jobs:release-stale')->everyFiveMinutes();
    Schedule::command('billing:close-stale')->dailyAt('01:30');
}

// เครื่อง worker ไม่มีงานตามเวลาเลยสักตัว — มันมีหน้าที่เดียวคือวนดึงงาน
ตอนพัฒนา ผมเปิด `APP_ROLE=web+worker` บนเครื่องเดียวให้ worker วิ่งดึงงานจาก API ของตัวเอง เพื่อทดสอบทั้งวงจรได้โดยไม่ต้องมีสองเครื่อง สะดวกมากตอนเขียน แต่ห้ามเอาโหมดนี้ขึ้นใช้จริง เพราะมันลบข้อดีทั้งหมดของการแยกทิ้ง แล้วยังกลบบั๊กประเภท "ลืมส่งค่าข้ามเครื่อง" ไปด้วย ให้ปิดทันทีที่มีเครื่องที่สอง
ตาราง ai_jobs กับการจองงานแบบ atomic
คิวงานปกติของ Laravel ใช้ไม่ได้กับเคสนี้ เพราะ worker อยู่คนละเครื่องคนละวง ไม่ได้เห็น Redis ก้อนเดียวกัน ผมเลยทำตารางคิวของตัวเองที่คุยกันผ่าน HTTP ได้
// database/migrations/xxxx_create_ai_jobs_table.php
Schema::create('ai_jobs', function (Blueprint $t) {
    $t->id();
    $t->string('type', 40);                 // doc.index / pdf.render / media.convert ...
    $t->json('payload');
    $t->string('status', 12)->default('queued');   // queued -> running -> done | failed
    $t->unsignedTinyInteger('priority')->default(5);
    $t->unsignedTinyInteger('attempts')->default(0);
    $t->timestamp('run_after')->nullable();
    $t->timestamp('locked_at')->nullable();
    $t->string('locked_by', 64)->nullable();
    $t->json('result')->nullable();
    $t->text('error')->nullable();
    $t->timestamps();
    $t->index(['status', 'run_after', 'priority']);
});
หัวใจอยู่ที่การจองงาน ห้ามอ่านมาก่อนแล้วค่อยอัปเดตเด็ดขาด ต้องเป็นคำสั่งเดียวที่จองสำเร็จหรือไม่สำเร็จเท่านั้น แล้วเช็กจำนวนแถวที่โดนแก้
-- จองงานหนึ่งใบให้ worker ที่ระบุ
UPDATE ai_jobs
   SET status = 'running', locked_by = ?, locked_at = NOW(), attempts = attempts + 1
 WHERE id = (
        SELECT id FROM (
          SELECT id FROM ai_jobs
           WHERE status = 'queued'
             AND (run_after IS NULL OR run_after <= NOW())
           ORDER BY priority ASC, id ASC
           LIMIT 1
        ) AS pick
      )
   AND status = 'queued';
-- affected = 1 คือจองได้ · affected = 0 คือมีคนชิงไปแล้ว ให้วนไปหาใบถัดไป
// app/Services/AiJobs.php
public function claim(string $worker): ?object
{
    $affected = DB::update($this->claimSql(), [$worker]);
    if ($affected !== 1) {
        return null;                 // ไม่ได้แปลว่าพัง แปลว่าคนอื่นเอาไปก่อน
    }
    return DB::table('ai_jobs')->where('locked_by', $worker)
             ->where('status', 'running')->orderByDesc('locked_at')->first();
}
เงื่อนไข AND status = 'queued' ในบรรทัดท้ายสำคัญกว่าที่หน้าตามันดู ถ้าไม่มีบรรทัดนั้น worker สองตัวที่ยิงเข้ามาพร้อมกันจะเลือก id เดียวกันได้ แล้วต่างคนต่างอัปเดตสำเร็จทั้งคู่ = งานใบเดียวถูกทำสองรอบ ผมเขียนเรื่องการจองก่อนยิงนี้ไว้ละเอียดอีกตอนหนึ่งต่างหาก เพราะงานที่มีผลกับโลกภายนอกมีรายละเอียดมากกว่านี้อีกเยอะ
worker:pull วนดึงงานทางเดียว
ฝั่งเว็บเปิด route ไว้ชุดหนึ่งใต้ middleware ที่ตรวจโทเคน ตัว route พวกนี้จะมีเฉพาะตอน role=web เท่านั้น
// routes/worker.php — โหลดเฉพาะเมื่อ is_web()
Route::middleware('worker.token')->prefix('worker')->group(function () {
    Route::post('/claim',        [WorkerController::class, 'claim']);
    Route::post('/{id}/result',  [WorkerController::class, 'result']);
    Route::post('/{id}/fail',    [WorkerController::class, 'fail']);
    Route::post('/heartbeat',    [WorkerController::class, 'heartbeat']);
});
ฝั่ง worker เป็น command ตัวเดียววนไปเรื่อย ๆ
// app/Console/Commands/WorkerPull.php
public function handle(): int
{
    abort_unless(is_worker(), 1, 'คำสั่งนี้รันได้เฉพาะเครื่องที่ตั้ง APP_ROLE=worker');
    $me = gethostname().'-'.getmypid();

    while (! $this->shouldQuit()) {
        $job = $this->api()->post('/worker/claim', ['worker' => $me])->json('job');
        if (! $job) { sleep(5); $this->beat($me); continue; }

        try {
            $result = app(HandlerMap::class)->run($job['type'], $job['payload']);
            $this->api()->post("/worker/{$job['id']}/result", ['result' => $result]);
        } catch (\Throwable $e) {
            // ส่งแค่ประเภทกับรหัสข้อผิดพลาด ไม่ส่งข้อความที่มีข้อมูลลูกค้าติดไปด้วย
            $this->api()->post("/worker/{$job['id']}/fail", ['error' => class_basename($e).': '.$e->getCode()]);
        }
    }
    return 0;
}
# /etc/systemd/system/app-worker.service (เครื่องที่บ้าน)
[Unit]
Description=App worker (pull mode)
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=appuser
WorkingDirectory=/home/appuser/app
ExecStart=/usr/bin/php /home/appuser/app/artisan worker:pull --max-time=3600
Restart=always
RestartSec=5
KillSignal=SIGTERM
TimeoutStopSec=120

[Install]
WantedBy=multi-user.target
ตอน worker ดับ ฝั่งเว็บต้องรู้ตัว ไม่ใช่ปล่อยให้ทีมนั่งงงว่าทำไมกดแล้วไม่มีอะไรเกิดขึ้น ผมให้ worker ยิง heartbeat ทุกนาที แล้วหน้าเว็บโชว์เป็นข้อความเดียวว่า "งานรอคิว N รายการ · เครื่องประมวลผลติดต่อล่าสุด HH:MM" เกินสิบห้านาทีค่อยแจ้งเตือนคนดูแล แค่นี้ทีมก็เข้าใจสถานการณ์เองได้โดยไม่ต้องโทรถาม
ไฟล์ต้องอยู่ที่เดียวกันทั้งสองฝั่ง
จุดที่กินเวลาแก้มากที่สุดในงานนี้ไม่ใช่คิว แต่เป็นไฟล์ ในโค้ดเดิมมีที่ที่เรียก storage_path() ตรง ๆ อยู่สิบแปดจุด ทุกจุดสมมติว่า "ไฟล์อยู่ในเครื่องเดียวกับที่โค้ดรัน" ซึ่งพอแยกสองเครื่องแล้วสมมติฐานนั้นพังทันที
ผมย้ายไฟล์ทั้งหมดไปที่เก็บแบบ object storage แล้วเขียน helper ตัวเดียวมาครอบ แนวคิดคือ "ดาวน์โหลดลงที่ชั่วคราว ทำงาน แล้วลบทิ้งให้ครบทุกเส้นทาง"
// app/Support/RemoteFile.php
public static function withLocal(string $disk, string $path, \Closure $fn)
{
    $tmp = tempnam(sys_get_temp_dir(), 'rf_');
    chmod($tmp, 0600);
    try {
        file_put_contents($tmp, Storage::disk($disk)->get($path));
        return $fn($tmp);
    } finally {
        @unlink($tmp);          // ต้องอยู่ใน finally เท่านั้น ไม่งั้น early return ทิ้งขยะไว้
    }
}
เรียกใช้แล้วโค้ดเดิมแทบไม่ต้องแก้อะไรนอกจากบรรทัดที่เปิดไฟล์
$text = RemoteFile::withLocal('s3', $doc->path, function (string $local) {
    return app(PdfReader::class)->extract($local);      // โปรแกรมภายนอกต้องการพาธจริงในเครื่อง
});
ไฟล์ชั่วคราวของงานแบบนี้คือเอกสารลูกค้าตัวจริง ไม่ใช่ของเล่น กติกาที่ผมบังคับตัวเองคือโฟลเดอร์ 0770 · ไฟล์ 0600 · ชื่อสุ่ม · ลบใน finally เสมอ รวมถึงเส้นทางที่ return ออกกลางคันและเส้นทางที่โยน exception ด้วย ถ้าลบใน try แล้ววันหนึ่งมีคนใส่ early return เพิ่มเข้ามา ไฟล์จะค้างอยู่ในเครื่องแบบไม่มีใครรู้
แยก "ตัดสินใจ" ออกจาก "รัน binary"
นี่คือส่วนที่กินแรงจริงของงานทั้งหมด ประมาณสองในสามของเวลาที่ใช้ไปอยู่ตรงนี้ ของเดิมเขียนรวมกันหมด — ฟังก์ชันเดียวทั้งเรียกโปรแกรมอ่านไฟล์ ทั้งคิดว่าผลที่ได้แปลว่าอะไร ทั้งเขียนลงฐานข้อมูล ทั้งส่งข้อความออก พอจะแยกเครื่องก็ต้องผ่ามันออกเป็นสองท่อน
กติกาที่ผมใช้ตัดคือถามคำถามเดียว — โค้ดบรรทัดนี้ต้องการโปรแกรมที่ลงไว้ในเครื่องไหม ถ้าต้องการ มันไปอยู่ฝั่ง worker ถ้าไม่ต้องการ มันอยู่ฝั่งเว็บ ง่ายแค่นั้น และที่สำคัญคือการส่งออกทั้งหมดอยู่ฝั่งเว็บเสมอ ต่อให้ worker เป็นคนสร้างของที่จะส่งก็ตาม เพราะถ้ายอมให้ worker ส่งเองเมื่อไหร่ สถานะ "ส่งแล้วหรือยัง" จะกระจายอยู่สองเครื่อง แล้ววันที่ต้องกันการส่งซ้ำจะไม่มีที่ให้ยืนเลย
แผน cutover กับทางถอย
ผมไม่กล้าสลับของแบบนี้ด้วยความรู้สึก เลยเขียนออกมาเป็นลำดับสิบแปดขั้น แบ่งเป็นสามช่วง — เตรียมโค้ดล่วงหน้าโดยไม่กระทบของเดิม, เตรียมเครื่องใหม่แบบยังไม่สลับ, แล้วค่อยสลับในวันที่ทีมไม่ได้ใช้งาน
# ช่วงเตรียม (ทำล่วงหน้าได้ ระบบเดิมไม่กระทบ)
php artisan migrate --force                  # ตาราง ai_jobs ขึ้นก่อน ยังไม่มีใครใช้
rclone copy storage/app/private remote:bucket/private --progress   # ย้ายไฟล์รอบแรก
php artisan config:cache && php artisan route:cache
# ลด TTL ของ DNS เหลือ 60 วินาที ล่วงหน้าอย่างน้อยหนึ่งวัน

# ช่วงสลับ
php artisan down --secret=<TOKEN>            # ปิดของเก่า เหลือทางให้เราเข้าไปตรวจ
rclone copy storage/app/private remote:bucket/private        # ไฟล์รอบสุดท้าย
mysqldump --single-transaction --quick appdb | gzip > /tmp/final.sql.gz
# กู้ลงฐานข้อมูลฝั่งโฮสต์ใหม่ แล้วเทียบจำนวนแถวตารางหลักให้ตรงกันทั้งสองฝั่ง
-- ขั้นที่ห้ามข้าม: เทียบจำนวนแถวก่อนสลับ DNS
SELECT 'leads' t, COUNT(*) n FROM leads
UNION ALL SELECT 'messages', COUNT(*) FROM messages
UNION ALL SELECT 'invoices', COUNT(*) FROM invoices
UNION ALL SELECT 'documents', COUNT(*) FROM documents;
ทางถอยต้องเขียนไว้ก่อนลงมือ ไม่ใช่ไปคิดเอาตอนของพัง ของผมสั้นมาก — ชี้ DNS กลับที่เดิม แล้วเปิดระบบเก่าขึ้นมา แต่มีเงื่อนไขสำคัญหนึ่งข้อ
ถ้าฝั่งใหม่รับข้อมูลใหม่ไปแล้ว การชี้ DNS กลับเฉย ๆ เท่ากับทิ้งข้อมูลที่เกิดหลังสลับทั้งหมด ทางถอยที่ถูกต้องคือ dump จากฝั่งใหม่กลับมาทับฝั่งเก่าก่อน แล้วค่อยเปิดของเก่า ผมเลยตั้งกติกาว่าถอยได้ภายในวันเดียวกันเท่านั้น เกินจากนั้นคือเดินหน้าแก้อย่างเดียว ไม่มีถอยแล้ว
เมื่อไหร่ที่ไม่ควรแยก
ผมไม่ได้เชียร์ให้ทุกคนไปแยกระบบตามนะครับ งานนี้กินเวลาห้าถึงหกวันเต็ม ๆ และเพิ่มของที่ต้องดูแลอีกหลายชิ้น — โทเคน, ที่เก็บไฟล์กลาง, heartbeat, ตารางคิวของตัวเอง, สคริปต์ deploy อีกชุด เกณฑ์ที่ผมใช้ตัดสินมีสองข้อเท่านั้น
ข้อแรก งานหนักที่ต้องใช้โปรแกรมในเครื่องต้องเยอะพอจนย้ายไปโฮสต์ธรรมดาไม่ได้ ถ้าย้ายได้หมดก็ย้ายเถอะครับ จบเร็วกว่ากันมาก ข้อสอง เว็บกับข้อความขาเข้าต้องห้ามดับจริง ๆ ถ้าดับได้ชั่วโมงสองชั่วโมงโดยไม่มีใครเดือดร้อน อย่าเพิ่งทำ เอาเวลาไปทำ backup ให้ดีกว่านี้คุ้มกว่า
ใครมีเงื่อนไขไม่เหมือนผมก็ปรับตามสะดวกครับ ที่อยากให้เก็บไปใช้จริง ๆ มีสองอย่างคือ ตัวแปรเดียวคุมบทบาทอย่าไปแตกโค้ด และให้ฝั่งที่ไม่มีทางเข้าเป็นฝ่ายวิ่งมาดึงงานเสมอ สองข้อนี้ใช้ได้กับสถาปัตยกรรมอื่นด้วย ไม่ได้ผูกกับ Laravel เลย ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย