ย้ายเว็บ .aspx เก่าทั้งเว็บ ทำเป็น catalog JSON แล้วคัดรูปขยะออกเอง

เว็บเก่าที่รันมาสิบปีมักมีของดีอยู่ข้างใน แต่ทางเข้าหลังบ้านหายไปนานแล้ว เหลือแค่หน้าเว็บที่ยังเปิดได้ งานย้ายเว็บแบบนี้ไม่ได้ยากที่การดึงข้อความ มันยากตรงการทำให้ของที่ดึงมา 2,000 กว่าชิ้นเชื่อถือได้พอจะเอาไปขึ้นเว็บใหม่โดยไม่ต้องนั่งไล่ดูทีละรูป
พอดีมีเจ้าของเว็บติดต่อมาให้ทำเว็บใหม่ให้ เว็บเดิมเป็น ASP.NET WebForms ที่ทำไว้ตั้งแต่สิบกว่าปีก่อน คนทำหายไปนานแล้ว รหัสฐานข้อมูลไม่มี หลังบ้านเข้าไม่ได้ เหลือแค่ตัวเว็บที่ยังเปิดดูได้ปกติ แต่เนื้อหาข้างในเป็นงานที่เขาสะสมมาเองทั้งหมด ทิ้งไม่ได้แน่นอน
เว็บที่ผมเก็บข้อมูลออกมาคือเว็บของลูกค้าเอง และเจ้าของเป็นคนขอให้ผมทำใหม่ให้ ผมได้ทั้งสิทธิ์ในเนื้อหาและคำสั่งงานเป็นลายลักษณ์อักษรก่อนเริ่ม ไม่ใช่การไปไล่ดูดเว็บของคนอื่นมาใช้ ในบทความนี้ผมตัดชื่อเว็บ ชื่อกิจการ และรายละเอียดเชิงธุรกิจออกทั้งหมด เหลือไว้แต่วิธีทำ ใครจะเอาไปใช้ก็ควรใช้กับเว็บที่ตัวเองมีสิทธิ์เท่านั้นนะครับ
โจทย์จริงๆ ไม่ใช่ "ดึงข้อความออกมาให้ได้" อันนั้นใครก็ทำได้ โจทย์คือทำยังไงให้ของที่ดึงมา 785 หน้า กับรูป 2,074 รูป เอาไปขึ้นเว็บใหม่ได้เลยโดยไม่ต้องเปิดดูทีละรูป และลิงก์เก่าที่กูเกิลเก็บไว้ยังต้องเด้งมาหน้าใหม่ได้ถูกหน้าด้วย
ตัวที่ต่อเน็ตจริงมีแค่ตัวแรกตัวเดียว ที่เหลือทำงานกับไฟล์ในเครื่องล้วนๆ ตรงนี้ผมตั้งใจแยกตั้งแต่แรก เพราะตอนแกะข้อมูลมันต้องรันซ้ำเป็นสิบรอบ ถ้าต้องยิงเว็บเขาใหม่ทุกรอบนอกจากจะช้าแล้วยังกวนเซิร์ฟเวอร์เขาโดยไม่จำเป็น
เริ่มจากลิสต์หน้าที่ยอมให้เดิน ไม่ใช่ปล่อยให้ไล่ทั้งโดเมน
เว็บ WebForms รุ่นนั้นทั้งเว็บมีไฟล์จริงอยู่ไม่กี่ตัว ที่เหลือคือ query string ผมเลยไม่ทำ crawler แบบไล่ทุกลิงก์ที่เจอ แต่ทำ allowlist ของไฟล์ .aspx ที่ยอมให้เข้าคิว เจอ href ที่ไม่ใช่รายชื่อนี้ตัดทิ้งทันที กันไม่ให้มันหลุดไปเดินเว็บพี่น้องของเขาที่แขวนอยู่โดเมนอื่น
ALLOWED_PAGES = {
    "default.aspx", "about.aspx", "browse.aspx", "view.aspx",
    "services.aspx", "guide.aspx", "blog.aspx", "contact.aspx",
}

SEEDS = [
    "https://www.example.com/default.aspx",
    "https://www.example.com/browse.aspx?browsesub1=1001",
    "https://www.example.com/browse.aspx?browsesub1=1003",
]
URL ที่แบกเนื้อหาจริงมีแค่สามแบบ คือ view.aspx?id=N (เนื้อหาหนึ่งชิ้น) browse.aspx?browsesub1=NNNN (หน้ารวมหมวด) และ browse.aspx?tag=...&page=N (หน้ารวมตามแท็ก) ส่วนรูปทุกรูปวิ่งผ่าน image.aspx?ID=N ไม่มีนามสกุลไฟล์สักตัว
เรื่องหน้าถัดไปผมไม่ได้เดาเลขเอง ปล่อยให้มันเจอลิงก์ page= เองตามธรรมชาติ พอ pager ของเว็บหยุด crawler ก็หยุดตาม ปลอดภัยกว่าการวนเลขไปเรื่อยๆ แล้วยิงหน้าที่ไม่มีอยู่จริงอีกเป็นร้อยครั้ง
ทำ URL ให้เหลือรูปเดียวก่อนเข้าคิว
เว็บ WebForms ชอบปล่อยหน้าเดียวกันออกมาหลายหน้าตา สลับตัวพิมพ์ใหญ่เล็ก สลับลำดับคีย์ query บ้าง ใส่คีย์ว่างมาบ้าง ถ้าไม่จับมาล้างให้เหลือรูปเดียวก่อน คิวจะบวมแล้วเก็บหน้าเดิมซ้ำไปเรื่อยๆ
def canonical_url(href: str, base: str) -> str | None:
    if not href or href.startswith(("mailto:", "tel:", "javascript:", "#")):
        return None
    p = urlparse(urljoin(base, href))
    if p.netloc and p.netloc != "www.example.com":
        return None
    fname = (p.path or "/").rsplit("/", 1)[-1].lower() or "default.aspx"
    if fname not in ALLOWED_PAGES:
        return None
    qs = parse_qs(p.query, keep_blank_values=True)
    qs_norm = {k.lower(): v for k, v in qs.items()}
    qstr = "&".join(f"{k}={v[0]}" for k, v in sorted(qs_norm.items()))
    return f"https://www.example.com/{fname}" + (f"?{qstr}" if qstr else "")
ตัว fetch ผมทำง่ายๆ คือ session เดียว เธรดเดียว หน่วง 0.4 วินาทีทุกหน้า timeout 30 วินาที ลองใหม่ 3 ครั้งแบบถอยหลังเพิ่มทีละ 1.5 วินาที พลาดแล้วบันทึกลง error list ไม่ต้องโยน exception ให้ทั้งงานพัง งานแบบนี้ไม่มีเหตุผลต้องรีบ ยิงเบาๆ คืนเดียวก็จบ
เรื่องที่ต้องดักไว้ตั้งแต่บรรทัดแรกคือ encoding ครับ เซิร์ฟเวอร์เก่าหลายตัวไม่ส่ง charset มา หรือส่งมาผิด แล้ว requests จะเดาเป็น latin-1 ให้ ภาษาไทยกลายเป็นขยะทั้งหน้าโดยไม่มีใครเตือน
if not r.encoding or r.encoding.lower() in ("iso-8859-1", "windows-1252"):
    r.encoding = "utf-8"
html = r.text
(OUT_HTML / page_filename(url)).write_text(html, encoding="utf-8")
กับดักที่ทำให้ผมเสียหน้าไป 500 กว่าหน้า
ตอนเก็บไฟล์ผมแปลง query string เป็นชื่อไฟล์ตรงๆ โดยแทนที่อักขระที่ใช้ในชื่อไฟล์ไม่ได้ด้วยขีดล่าง ฟังดูปลอดภัยดี แต่เว็บนี้มีแท็กเป็นภาษาไทยอยู่หลายร้อยแท็ก
def page_filename(url: str) -> str:
    p = urlparse(url)
    fname = p.path.rsplit("/", 1)[-1] or "default.aspx"
    if p.query:
        safe = re.sub(r"[^A-Za-z0-9_=&-]", "_", p.query)   # ตัวการ
        return f"{fname[:-5]}__{safe}.html"
    return f"{fname[:-5]}.html"
อักษรไทยทุกตัวกลายเป็นขีดล่างหมด แท็กคนละตัวเลยได้ชื่อไฟล์เหมือนกันเป๊ะ เช่น browse__tag=_____.html แล้วเขียนทับกันเงียบๆ log บอกว่าดึงมา 1,346 URL แต่บนดิสก์เหลือไฟล์ 785 ไฟล์ ไม่มี error สักบรรทัด
กฎที่ผมได้จากงานนี้คือ ห้ามใช้ฟังก์ชันล้างชื่อไฟล์ที่ยุบอักขระหลายตัวให้เหลือตัวเดียว กับ URL ที่มีภาษาไทย เพราะมันไม่ได้ล้มเหลวให้เห็น มันเขียนทับเงียบๆ วิธีที่ถูกคือ percent-encode ทั้งท่อน หรือเอา query ไป hash สั้นๆ ต่อท้ายชื่อไฟล์ไว้ แล้วเช็กตอนจบว่าจำนวน URL ที่ดึงสำเร็จเท่ากับจำนวนไฟล์บนดิสก์หรือเปล่า ต่างเมื่อไหร่แปลว่ามีของหายไปแล้ว
โชคดีที่หน้าเนื้อหาจริงเป็น view.aspx?id= เลขล้วน ไม่โดนผลกระทบ ที่หายไปคือหน้ารวมตามแท็ก ซึ่งผมสร้างใหม่จาก catalog ได้อยู่แล้ว เลยไม่ได้ไล่เก็บซ้ำ แต่ถ้าเป็นหน้าเนื้อหาผมคงต้องรันใหม่ทั้งคืน
รูปไม่มีนามสกุล ต้องดมจากไบต์เอง
image.aspx?ID=N คืนมาเป็นสตรีมเปล่าๆ ผมเลยเอานามสกุลจาก Content-Type ก่อน ถ้าเซิร์ฟเวอร์ส่ง application/octet-stream มาก็ดูไบต์แรกแทน
ext = ext_map.get(ctype)
if not ext:
    head = r.content[:16]
    if   head[:3]  == b"\xff\xd8\xff":        ext = ".jpg"
    elif head[:8]  == b"\x89PNG\r\n\x1a\n":   ext = ".png"
    elif head[:6] in (b"GIF87a", b"GIF89a"):  ext = ".gif"
    elif head[:4] == b"RIFF" and head[8:12] == b"WEBP": ext = ".webp"
    else: ext = ".bin"
fname = f"img_{img_id}{ext}"      # ชื่อไฟล์ = เลข id ของเว็บเก่า
บรรทัดสุดท้ายนั่นแหละครับที่ช่วยผมไว้ทั้งงาน ผมตั้งชื่อไฟล์รูปด้วย id เดิมของเว็บเก่าตรงๆ เลย ทำให้ทุกสคริปต์ที่ตามมาไม่ต้องพึ่ง manifest ไม่ต้องพึ่งฐานข้อมูล อยากรู้ว่ารูป id เท่าไหร่อยู่ไหน ก็ glob ชื่อไฟล์เอา ตอนหลัง crawler ตายกลางคันไม่ได้เขียน manifest ออกมา งานก็ยังเดินต่อได้เพราะตรงนี้
ที่ได้มาจริงคือ jpg 2,050 ไฟล์ png 32 ไฟล์ และมี .bin กับไฟล์ขนาด 0 ไบต์ปนมาหยิบมือหนึ่ง พวกนี้ต้องมีขั้นตอนดึงซ้ำ โดยใส่ header Referer ไปด้วย เพราะ handler รูปของเว็บเก่ากันการลิงก์ข้ามเว็บอยู่
แกะเนื้อหาออกจากธีมเก่า แล้วยึด legacy_id เป็นกุญแจ
ธีมเว็บเก่าเป็นเทมเพลตยุค Bootstrap ซึ่งนับว่าโชคดี เพราะมันมี main.content, nav.breadcrumbs, h2.section-title ให้เกาะ ไม่ใช่ id ยาวเหยียดแบบ WebForms ล้วนๆ ผมเลยแกะแบบลบทิ้ง คือเอา main มาทั้งก้อนแล้วค่อยตัดของที่ไม่เอาออก
main = soup.select_one("main.content") or soup.find("main") or soup.body
title_el = soup.select_one("h2.section-title") or soup.select_one("h1.section-title")
title = title_el.get_text(strip=True) if title_el else None
title_el and title_el.extract()                  # กันหัวข้อซ้ำในเนื้อ
for sel in ["script", ".share", ".fb-like", "#fb-root", ".social-share"]:
    for n in main.select(sel):
        n.decompose()
body_html = str(main)
body_text = re.sub(r"\s+", " ", main.get_text(" ", strip=True))
รูปผมเก็บเฉพาะที่อยู่ใน main และเก็บตามลำดับที่ปรากฏจริงในหน้า โลโก้หัวเว็บกับแบนเนอร์ท้ายเว็บเลยไม่มีทางหลุดเข้าแกลเลอรีตั้งแต่ต้นทาง อ้อ ในมาร์กอัปเดิมเขียน id= บ้าง ID= บ้างปนกัน ต้องรับทั้งสองแบบ
ส่วน legacy_id ผมดึงจากชื่อไฟล์ที่เซฟไว้ ไม่ใช่จาก URL เพื่อให้ตัวแกะรันแบบออฟไลน์ได้ และคีย์ตัวนี้คือหัวใจของงานย้ายเว็บทั้งงาน มันเป็นตัวเชื่อมสามทางพร้อมกัน คือหน้าเก่าไปหน้าใหม่ รูปเก่าไปไฟล์ในเครื่อง และการ์ดในหน้ารวมไปหาหน้าเนื้อหา พอมีตัวนี้ การทำ redirect 301 จากลิงก์เก่ากลายเป็นงานเครื่องจักร ไม่ใช่งานจับคู่ด้วยสายตา
{
  "legacy_id": "2000",
  "title": "...",
  "slug": "...",
  "category": "...",
  "breadcrumb": ["...", "..."],
  "cover_image": "images/img_8373.jpg",
  "image_count": 19,
  "images": [
    { "legacy_id": "8373", "file": "images/img_8373.jpg", "shared_with": 1 }
  ],
  "body_preview": "400 ตัวอักษรแรกของเนื้อหา",
  "body_text_len": 5123,
  "source_url": "https://www.example.com/view.aspx?id=2000",
  "source_file": "html/view__id=2000.html"
}
ตัวคัดรูปสามชั้น กันไม่ให้ QR กลายเป็นรูปปก
ปัญหาที่ทำให้ต้องเขียนตัวคัดคือ CMS เก่าแปะรูป QR ของแอปแชทกับปุ่มเชิญชวนไว้ท้ายบทความแทบทุกหน้า และแปะแบบอัปโหลดใหม่ทุกครั้ง รูปเดียวกันเป๊ะเลยได้ id คนละเลข การไล่ตาม id ไม่ช่วยอะไรเลย ต้องดูที่ไบต์
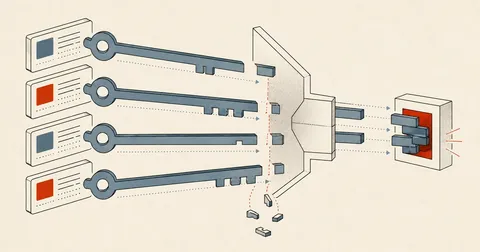
ชั้นแรกคือ SHA-1 ทั้งไฟล์ แล้ว index กลับด้วย hash พอเรียงกลุ่มตามจำนวนสมาชิกปุ๊บ ตัวปัญหาโผล่มาให้เห็นทันที
for f in IMG_DIR.iterdir():
    m = re.match(r"img_(\d+)\.[A-Za-z0-9]+$", f.name)
    if not m:
        continue
    raw = f.read_bytes()
    h = hashlib.sha1(raw).hexdigest()
    with Image.open(f) as im:
        w, hpx = im.size
    data[m.group(1)] = {"file": f.name, "hash": h, "w": w, "h": hpx,
                        "bytes": len(raw)}
    hash_to_ids.setdefault(h, []).append(m.group(1))
กลุ่มใหญ่สุดคือไฟล์ 900x900 ขนาด 65,430 ไบต์ ซ้ำกันเป๊ะทุกไบต์อยู่ 75 รูป นั่นคือ QR ตัวนั้น อีกกลุ่มเป็น QR รุ่นที่สองอีก 3 รูป และมีรูปปุ่มขนาด 97x50 อีกหนึ่ง
ชั้นที่สองคือกันรุ่นลูก เพราะถ้าเขาเซฟ QR ใหม่ด้วยคุณภาพต่างกันนิดเดียว hash จะเปลี่ยนทันที ผมเลยไม่ฮาร์ดโค้ด hash แต่ดูที่ลักษณะของกลุ่มแทน คือจัตุรัสขนาดเท่ากันและซ้ำตั้งแต่สองครั้งขึ้นไป
for h, ids in sorted(hash_to_ids.items(), key=lambda kv: -len(kv[1])):
    sample = data[ids[0]]
    if sample["w"] == 900 and sample["h"] == 900 and len(ids) >= 2:
        qr_dupe_ids.update(ids)

logo_ids = {i for i, d in data.items()
            if 50 <= d["w"] <= 200 and 30 <= d["h"] <= 100
            and d["bytes"] < 20_000 and d["uses"] >= 2}
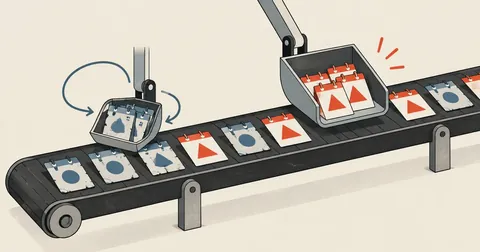
ชั้นที่สามคือนับว่ารูปนั้นถูกใช้ในหน้าเนื้อหากี่หน้า ผมเรียกมันว่า shared_with รูปงานจริงจะอยู่หน้าเดียว ส่วนของประดับเว็บจะโผล่หลายหน้า
usage = {}
for item in items:
    for iid in item.get("image_ids") or []:
        usage[str(iid)] = usage.get(str(iid), 0) + 1
for iid, d in data.items():
    d["uses"] = usage.get(iid, 0)

banner_ids = {i for i, d in data.items()
              if d["uses"] >= 5 and i not in qr_dupe_ids and i not in logo_ids}
cover_skip = qr_dupe_ids | logo_ids | banner_ids
cover_safe = {i for i in data if i not in cover_skip}
ผลจริงคือชั้นหนึ่งกับชั้นสองทำงานเกือบทั้งหมด ส่วนชั้นสามได้ศูนย์ เพราะตัวแกะเนื้อหาตัดของประดับในหัวเว็บท้ายเว็บทิ้งไปตั้งแต่ต้นแล้ว ผมยังเก็บชั้นสามไว้อยู่ดี เพราะเว็บหน้าอาจไม่โชคดีแบบนี้ และมันคือตัวตัดสินตอนเลือกปกในขั้นถัดไป
ใช้ไม่ได้กับ CMS เก่า
ของชิ้นเดียวกันถูกอัปโหลดซ้ำทุกครั้งที่เขียนบทความใหม่ เลยได้ id คนละเลข ชื่อไฟล์คนละชื่อ ถ้าคัดด้วย id หรือชื่อ ก็จะเหลือ QR ค้างอยู่เป็นสิบรูปโดยไม่รู้ตัว
ได้ผลทันที
SHA-1 ทั้งไฟล์จับตัวซ้ำเป๊ะได้หมดในรอบเดียว แล้วค่อยใช้ขนาดภาพกับจำนวนหน้าที่ใช้งานเป็นตัวกรองรุ่นลูกที่ hash ไม่ตรง
ของที่คัดออกผมย้ายไปโฟลเดอร์กักไว้ ไม่ได้ลบ เพราะบางรูปที่หน้าตาเหมือนขยะกลับเป็นรูปที่เจ้าของอยากเก็บ ลบทิ้งแล้วเรียกคืนไม่ได้ แต่ถ้าย้ายออกจากโฟลเดอร์ที่เว็บใหม่เสิร์ฟ มันก็ไม่มีทางหลุดขึ้นหน้าเว็บอยู่ดี
เลือกปกสามชั้น แล้วตรวจงานตัวเอง
ปกผมเลือกแบบมีลำดับ คือถ้าหน้านั้นเคยมี og:image แปลว่ามีคนเลือกให้แล้ว ใช้ตัวนั้นเลย ถ้าไม่มีค่อยหยิบรูปที่ shared_with น้อยที่สุด คือรูปที่เฉพาะเจาะจงกับหน้านั้นที่สุด
cover = None
og_id = og_map.get(str(item["legacy_id"]))
if og_id and og_id not in skip_gallery_ids:
    cover = img_lookup.get(str(og_id))

if cover is None:
    cands = [x for x in image_files if str(x["legacy_id"]) not in skip_cover_ids]
    cands = cands or image_files                      # ทางสุดท้าย
    cands.sort(key=lambda x: (x["shared_with"], int(x["legacy_id"])))
    cover = cands[0]["file"] if cands else None
จากทั้งหมด 226 หน้า มี og:image อยู่ 219 หน้า ที่เหลือ 7 หน้าคือหน้าที่ไม่มีรูปใช้ได้จริงๆ ปล่อยให้ปกเป็น null แล้วให้เว็บใหม่ใช้ปกสำรองไป ดีกว่าไปยัดรูปมั่วให้
ขั้นตรวจงานผมเขียนไว้สามตัว และมันจับของจริงได้ทุกตัว
- นับอักขระไทยในเนื้อหาทุกชิ้น ถ้ามีชิ้นไหนได้ศูนย์แปลว่า encoding พังตั้งแต่ตอนดึง
- เช็กว่าปกซ้ำกันข้ามชิ้นหรือเปล่า ปกซ้ำ = ตัวเลือกปกไปหยิบของประดับมาใช้
- เทียบจำนวนไฟล์ในโฟลเดอร์ต้นทางกับโฟลเดอร์ที่เว็บใหม่เสิร์ฟ ต่างกันเมื่อไหร่แปลว่า mirror ค้าง
ตัวทำ slug ของผมไม่ได้เช็กชื่อซ้ำ 226 ชิ้นเลยได้ slug ไม่ซ้ำจริงแค่ 215 ตัว ชนกัน 7 คู่ ทางแก้คือต่อท้ายด้วย legacy_id เมื่อเจอชนเท่านั้น อีกจุดคือหมวดที่อ่านจาก breadcrumb มันมีทั้งชื่อไทยชื่ออังกฤษของหมวดเดียวกัน และมีชื่อประเทศปนมาเป็นหมวดด้วย ตรงนี้ผมยังต้องใช้ if/elif ไล่ทีละกรณี ไม่มีทางลัด
สรุปเป็นกฎที่เอาไปใช้กับเว็บถัดไปได้
ส่วนตัวผมคิดว่างานย้ายเว็บเก่ามันตัดสินกันที่สองเรื่องเท่านั้นครับ เรื่องแรกคือเลือกคีย์ให้ถูกตั้งแต่วินาทีแรก ผมใช้ legacy_id เป็นทั้งชื่อไฟล์รูปและคีย์ในทุก JSON พอถึงตอนทำ redirect และตอนต่อรูปกลับเข้าบทความ ทุกอย่างเป็นการ lookup ธรรมดา ไม่ต้องเดา ไม่ต้องจับคู่ด้วยชื่อเรื่อง
เรื่องที่สองคือทุกขั้นต้องนับได้ ดึงมากี่ URL เหลือไฟล์กี่ไฟล์ รูปกี่รูป คัดออกกี่รูป เหลือใช้ได้กี่รูป ตัวเลขไม่ตรงเมื่อไหร่คือมีของหายเงียบๆ อยู่ อย่างเคสชื่อไฟล์ทับกัน ถ้าผมไม่ได้เทียบเลข 1,346 กับ 785 ผมคงส่งงานไปแล้วโดยไม่รู้ว่าหน้าแท็กหายไปครึ่งหนึ่ง
ใครกำลังจะรับงานทำเว็บใหม่ให้ลูกค้าที่ของเก่ายังอยู่แต่หลังบ้านหายไปแล้ว ลองไล่ตามลำดับนี้ดูได้ตามสะดวกครับ ที่สำคัญคือขออนุญาตเจ้าของให้เรียบร้อยก่อน แล้วยิงเบาๆ กับเซิร์ฟเวอร์เขา เพราะเว็บตัวนั้นยังต้องเปิดขายของอยู่ระหว่างที่เราทำเว็บใหม่ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย