คิวแปลเว็บขึ้น nothing to send ทั้งที่เหลือเป็นพัน: แคชของที่ล้ม
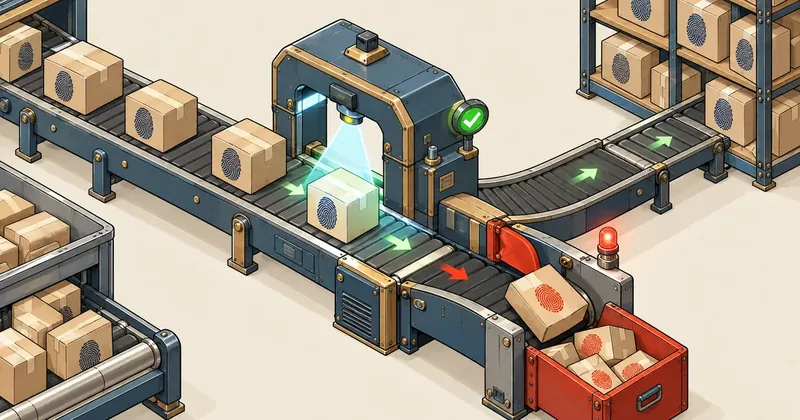
งานแปลหลายล้านตัวอักษรที่ไม่มีใครนั่งตรวจทีละหน้าได้ ต้องมีของสามอย่างที่ไม่ใช่โมเดล คือ hash ที่บอกว่าต้นฉบับเปลี่ยนไหม ด่านโค้ดที่ตรวจผลก่อนบันทึก และสมุดจดว่าฟิลด์ไหนล้มไปแล้วอย่าส่งซ้ำ
สรุปใน 1 นาที
- อาการ/ปัญหา
- แปลเว็บไทยเป็นอังกฤษหลายล้านตัวอักษรโดยไม่มีคนตรวจทีละหน้า
- ใครควรอ่าน
- คนที่ต้องแปลเว็บจำนวนมากด้วย LLM แบบรันเอง
- ทางแก้แบบสั้น
- ใช้ hash ต่อฟิลด์จำว่าแปลแล้ว ใช้โค้ดเจ็ดข้อตรวจผล และจำฟิลด์ที่ล้มสองรอบ แต่ระวังแคชของที่ล้มทำคิวตันจนรันเนอร์ว่าไม่มีอะไรส่ง
พอดีเว็บของลูกค้ารายหนึ่งมีเนื้อหาภาษาไทยเยอะมาก หน้าเนื้อหาหลายชนิด บทความ หน้าบริการ ต้องมีฉบับอังกฤษให้ครบ ปริมาณที่ผ่านระบบอยู่ระดับหลายล้านตัวอักษรไทย กินโทเคนระดับร้อยล้านบนเครื่องยนต์ Claude ตัวเลขนี้ผมเอาไว้ดูลำดับขนาดเฉยๆ ไม่ได้ตั้งใจจะให้ใครไปยึดทศนิยม ส่วนคนตรวจทีละหน้านั้นไม่มีใครไหว ผมเลยเลือกให้ "โค้ด" เป็นด่านตรวจ แทนที่จะเอา AI ตัวที่สองมานั่งตรวจทุกอย่าง แล้วระหว่างทางก็เจอบั๊กคิวตันที่ผมคิดไม่ถึง เลยเอามาเล่าให้ครบ
เรื่องนี้พูดถึงคุณภาพของผลแปลกับการเดินคิวให้ไม่ซ้ำไม่ตก ส่วนเรื่องรันยาวหลายวันบนโควตารายบัญชีของ CLI ผมแยกไปเล่าใน [งานแปลหลายวันบนโควตารายบัญชี](/article/agy-gemini-cli-batch-quota-sleep-until-reset) ชื่อเว็บ ชื่อโดเมน และ token ในบทความเป็นของสมมติทั้งหมด
หนึ่งแถวต่อหนึ่งฟิลด์ แล้วเก็บ hash ของต้นฉบับ
โมเดลข้อมูลที่ผมใช้ง่ายมาก หนึ่งแถวต่อหนึ่ง (type, id, field, locale) เช่น "หน้านี้ ฟิลด์เนื้อหา ภาษาอังกฤษ" แต่ละแถวเก็บค่าที่แปล สถานะ และ source_hash ซึ่งเป็น sha1 ของข้อความไทย ณ ตอนที่แปลจริง สถานะมีสี่ค่า คือ machine (โมเดลแปลแล้ว) reviewed (คนหรือรีวิวเวอร์รับแล้ว) stale (ต้นฉบับเปลี่ยนไปแล้ว) และ needs_human (ให้แอดมินดู)
CREATE TABLE translations (
  type        VARCHAR(32)  NOT NULL,
  id          BIGINT       NOT NULL,
  field       VARCHAR(64)  NOT NULL,
  locale      CHAR(2)      NOT NULL,
  value       MEDIUMTEXT   NOT NULL,
  source_hash CHAR(40)     NOT NULL,
  status      ENUM('machine','reviewed','stale','needs_human') NOT NULL,
  PRIMARY KEY (type, id, field, locale)
);
ฝั่งเซิร์ฟเวอร์มี API สองเส้น เส้นแรก GET /jobs คืนเฉพาะฟิลด์ที่ "ขาด" หรือ "stale" พร้อมข้อความไทย hash และบริบท เส้นที่สอง POST /translations รับผลที่แปลแล้ว แล้วตอบรายตัวว่าเป็นอะไรใน สามอย่างนี้
- ok บันทึกแล้ว
- stale_source ข้อความไทยเปลี่ยนตั้งแต่ตอนดึงงานมา เซิร์ฟเวอร์คำนวณ hash ใหม่เองแล้วเทียบ ไม่ไว้ใจค่าที่รันเนอร์ส่งกลับมา เลยไม่เขียนทับ
- kept_reviewed แถวที่คนหรือรีวิวเวอร์รับแล้วไม่ถูกทับ เว้นแต่สั่ง force
ผลที่ได้คือรันเมื่อไรก็ต่อได้ รันซ้ำก็ไม่ซ้ำงาน และถ้ามีคนแก้ข้อความไทยตรงไหน hash เปลี่ยน แถวนั้นก็เข้าคิวเองโดยผมไม่ต้องจำว่าอะไรถูกแก้บ้าง ส่วนตัวผมคิดว่านี่คือครึ่งหนึ่งของระบบแล้ว ที่เหลืออีกครึ่งคือจะเชื่อผลที่โมเดลคืนมาแค่ไหน
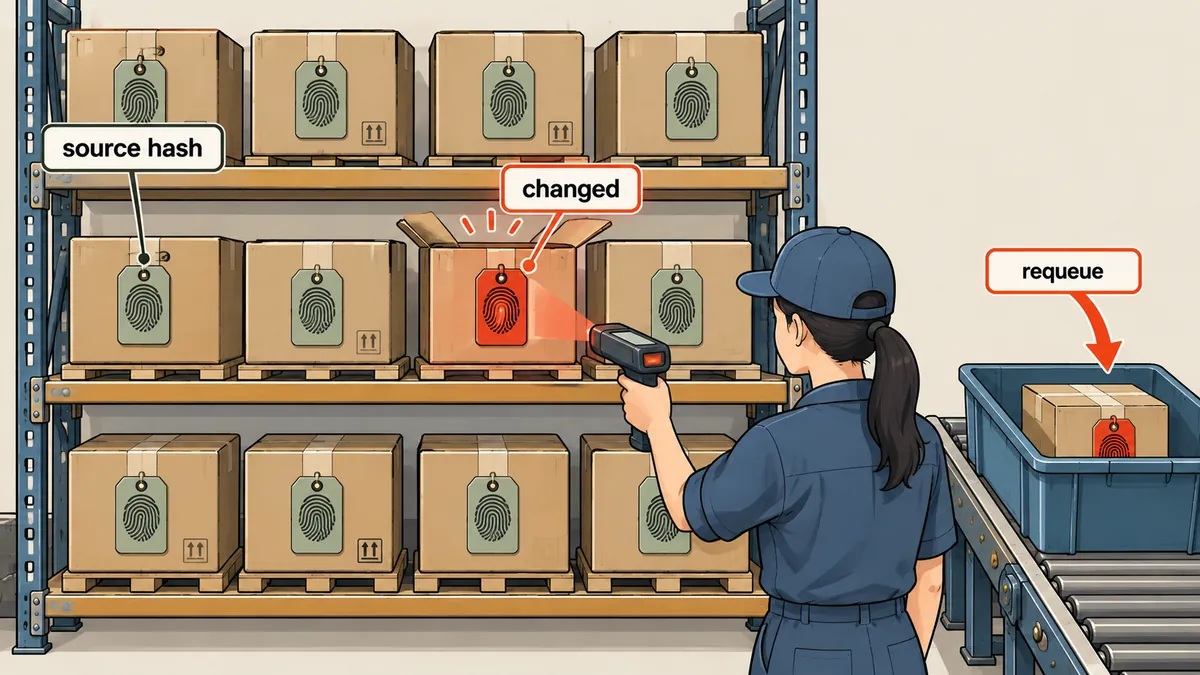
ด่านโค้ดเจ็ดข้อ ไม่ใช้ AI สักตัว
เหตุผลที่ผมให้โค้ดเป็นด่านคือ งานแปลที่พังมักพังแบบมีโครงสร้าง ไม่ใช่พังแบบเนียนๆ แปลผิดความหมายนิดหน่อย ตัวอย่างที่เจอจริงคือ tag ปิดไม่ครบ ตัวเลขหายไปหนึ่งตัว ตอบมาเป็นภาษาผิด หรือตอบมาสั้นกว่าต้นฉบับครึ่งหนึ่งเพราะโมเดลตัดทิ้งเอง ของพวกนี้โค้ดจับได้ถูกกว่าและแม่นกว่าให้ AI อีกตัวมาอ่านซ้ำ ด่านที่ผมใช้มีเจ็ดข้อ
- ไม่ว่าง คำตอบต้องมีเนื้อ
- ลายเซ็น tag ลิงก์ รูป ต้องเท่าต้นฉบับ ทั้งชนิดของ tag และค่า href กับ src
- ตัวเลขทุกตัว ในต้นฉบับต้องอยู่ในผล โดยแปลงเลขไทยเป็นอารบิก ตัด comma คั่นหลักพัน และยอมรูปแบบเขียนต่างกันเล็กน้อย
- รหัสรายการ ที่ขึ้นต้นเป็นแพตเทิร์นต้องอยู่ครบ แต่คำที่ติดเวลาแบบ SKU10:30 ไม่นับเป็นรหัส
- placeholder ต้องครบ
- ห้ามเหลืออักษรไทย ยกเว้นช่วงที่ก๊อปจากต้นฉบับตรงๆ และยาวไม่เกิน 40 ตัว ซึ่งถือเป็นชื่อเฉพาะ ตัวอักษรไทยที่หลุดมาในฉบับอังกฤษจับด้วย regex [-] ยกเว้นฟิลด์ที่เป็นรายชื่อละตินล้วน
- สัดส่วนความยาว 0.5 ถึง 4.0 เทียบกับต้นฉบับไทย เมื่อข้อความต้นฉบับยาวตั้งแต่ 30 ตัว กับเพดานความยาวของฟิลด์ SEO ถ้ามีกำหนดไว้
โค้ดย่อๆ ของด่านพวกนี้หน้าตาประมาณนี้ ผมตัดรายละเอียดออกให้อ่านง่าย แต่โครงเป็นแบบนี้จริง
import re
THAI = r'[-]'
THAI_DIGITS = str.maketrans('๐๑๒๓๔๕๖๗๘๙', '0123456789')
def signature(html):
names = sorted(re.findall(r'</?\s*([a-zA-Z0-9]+)', html))
urls = sorted(re.findall(r'(?:href|src)="([^"]*)"', html))
return names, urls
def numbers(text):
text = text.translate(THAI_DIGITS)
return {n.replace(',', '') for n in re.findall(r'\d+(?:[.,]\d+)*', text)}
def leftover_thai(src, out):
bad = []
for run in re.findall(THAI + r'+(?:\s+' + THAI + r'+)*', out):
if not (run in src and len(run) <= 40): # คัดลอกตรงจากต้นฉบับและสั้น = ชื่อเฉพาะ
bad.append(run[:20])
return bad
def check(src, out, locale, max_len=None):
if not out.strip():
return ['empty']
problems = []
if signature(src) != signature(out):
problems.append('tag/link/image signature differs')
missing = numbers(src) - numbers(out)
if missing:
problems.append('missing numbers: %s' % sorted(missing))
left = leftover_thai(src, out)
if left:
problems.append('thai left over: %s' % left[:3])
if len(src) >= 30:
if not 0.5 <= len(out) / len(src) <= 4.0:
problems.append('length ratio out of range')
if max_len and len(out) > max_len:
problems.append('over seo length cap')
return problems
ข้อที่ผมเสียเวลาปรับมากที่สุดคือข้อสามกับข้อหก ตัวเลขนี่ต้องยืดหยุ่นพอที่ "1,500" ในต้นฉบับกับ "1500" ในผลถือว่าตรงกัน ไม่งั้นด่านปฏิเสธของดีทิ้งเป็นร้อย ส่วนข้อหกเป็นข้อที่เข้มทั้งสองทางหละ เข้มไปคือชื่อเฉพาะภาษาไทยที่ควรคงไว้โดนตีตก หลวมไปคือประโยคไทยหลุดเข้าไปฉบับอังกฤษแล้วคนอ่านเห็นเอง เลยต้องมีกติกา "คัดลอกตรงและไม่ยาวเกิน 40 ตัว" ซึ่งก็เป็นเลขที่ผมตั้งจากของที่เจอ ใครจะปรับตามข้อมูลตัวเองก็ตามสะดวก
มันจับได้เฉพาะของที่พังเชิงโครงสร้าง ตัวเลขหาย หรือภาษาผิด ถ้าโมเดลแปลคำผิดแต่ tag ครบ ตัวเลขครบ ความยาวพอดี ด่านนี้ปล่อยผ่านหมด ความหมายต้องพึ่งโมเดลที่ดีกับ glossary ของชื่อเฉพาะที่แนบไปกับพรอมต์ (รายการจริงผมไม่ลงในบทความ) และถ้ามีคนตรวจก็ให้สุ่มจากแถวที่ผ่านด่านแล้วเท่านั้น ไม่ต้องไล่อ่านทุกแถว
แนวคิดเดียวกันนี้ผมเคยเล่าฝั่งอ่านเอกสารแล้วให้โค้ดเป็นคนคิดเลขไว้ใน ให้ AI อ่านเอกสาร แต่ให้โค้ดเป็นคนคิดเลข ไปอ่านต่อได้ ที่นี่ต่างกันตรงชุดตรวจเฉพาะงานแปลกับการเก็บ hash ต่อฟิลด์
ล้มแล้วลองใหม่หนึ่งครั้ง ถ้ายังล้มก็จดไว้
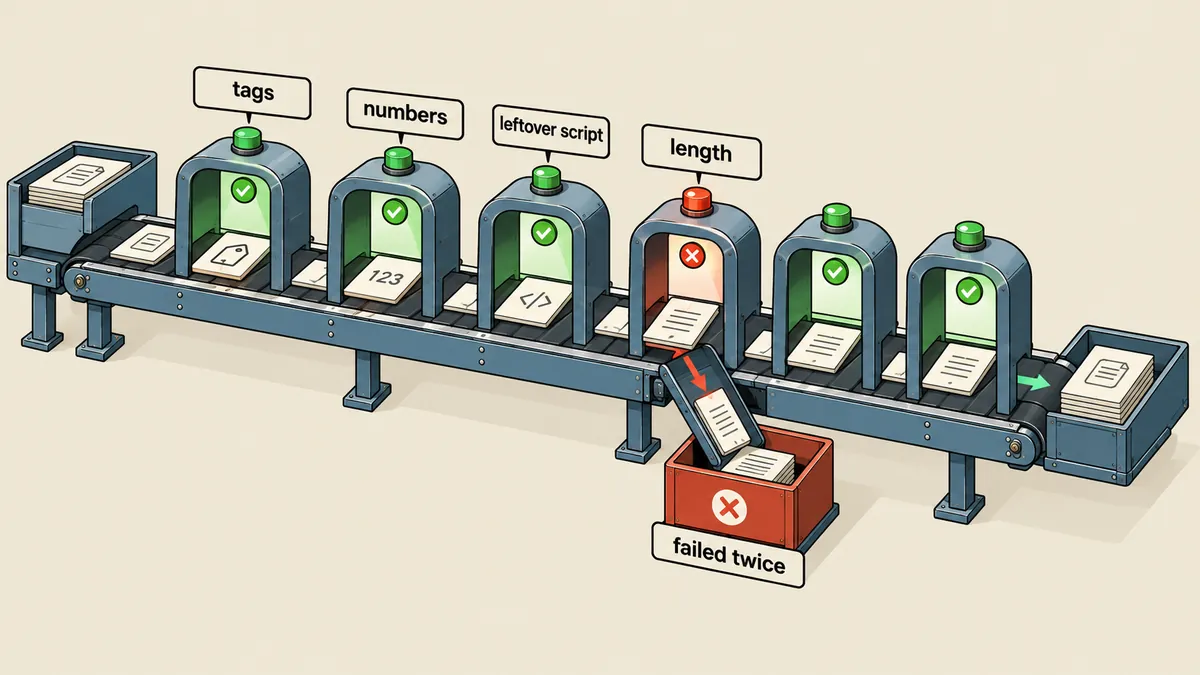
ฟิลด์ที่ไม่ผ่านด่านผมไม่ทิ้งทันที ลองอีกหนึ่งรอบ โดยแนบรายการปัญหาที่ด่านเจอเข้าไปในพรอมต์ เช่น "ตัวเลข 2,500 หายไป" โมเดลมักแก้ได้ในรอบสอง แต่ถ้ายังล้มอีก ผมเก็บไว้ในไฟล์ failed คีย์เป็น type:id:field พร้อม hash ของต้นฉบับ ณ ตอนล้ม กับเหตุผล
import json, pathlib

def translate_field(item, locale, ask, failed):
    key = '%s:%s:%s' % (item['type'], item['id'], item['field'])
    problems = []
    for attempt in (1, 2):
        answer = ask(build_prompt(item, locale, problems))   # รอบสองแนบ problems ไปด้วย
        problems = check(item['th'], answer, locale, item.get('max_len'))
        if not problems:
            return answer
    failed[key] = {'hash': item['hash'], 'why': problems}
    return None

def save_failed(locale, failed):
    pathlib.Path('cache').mkdir(exist_ok=True)
    p = pathlib.Path('cache/failed-%s.json' % locale)
    p.write_text(json.dumps(failed, ensure_ascii=False, indent=1), encoding='utf-8')
เหตุที่ต้องจำ เพราะถ้าไม่จำ ฟิลด์ที่ไม่มีทางผ่าน เช่นต้นฉบับมีข้อความแปลกๆ ที่ตัวเลขไม่ตรงในตัวเอง จะถูกส่งให้โมเดลแปลทุกรอบ เผาโทเคนไปโดยไม่ได้อะไร ผมเลยเก็บ hash ไว้ด้วย ไม่ใช่แค่ชื่อฟิลด์ เพราะถ้าแก้ต้นฉบับไทยแล้ว hash เปลี่ยน ก็ควรได้ลองใหม่ ตรงนี้ดูดีบนกระดาษ แต่พอใช้จริงมันพาผมไปเจอบั๊กตัวถัดไป
บั๊กคิวตัน: nothing to send ทั้งที่เหลืออีกเป็นพัน
อาการคือรันเนอร์ขึ้นว่า "nothing to send" แล้วหยุด แต่พอผมไปนับในตารางยังเหลือฟิลด์ที่ขาดอยู่เป็นหลักพัน ตอนแรกผมเดาว่าฝั่ง API ส่งคิวผิด ไล่เช็ก GET /jobs ก็ปกติ ถัดมาเดาว่าโควตาหมดแล้วรันเนอร์ตีความผิด ก็ไม่ใช่ สุดท้ายต้องย้อนไปอ่านคอมเมนต์ในโค้ดที่ตัวเองเขียนทิ้งไว้ ถึงรู้ว่าสาเหตุอยู่ที่ failed cache นี่แหละ
รันเนอร์ดึงรายการเป็นแบตช์ละ N รายการ จากหัวคิว หัวคิวคือรายการที่ทุกฟิลด์เคยล้มด้วยข้อความไทยเดิมแล้ว รายการพวกนี้ยังถูกดึงมาเติมแบตช์ทุกรอบ พอถึงขั้นส่งไปแปล ทุกฟิลด์โดนข้ามเพราะอยู่ใน failed cache แบตช์เลยว่างเปล่า รันเนอร์สรุปว่าไม่มีอะไรเหลือ ทั้งที่ข้างหลังแถวที่ล้มยังมีฟิลด์ที่ไม่เคยแปลรออยู่เป็นพัน
ทางแก้ที่ผมใช้คือ ก่อนเติมแบตช์ กรองรายการที่ "ทุกฟิลด์มี failed-entry ที่ hash ตรงกับต้นฉบับปัจจุบัน" ออกไป ยกเว้นเมื่อสั่ง --retry-failed หรือรีวิวเวอร์ทิ้งโน้ตไว้ให้ลองใหม่ พอใครแก้ข้อความไทยของรายการนั้น hash เปลี่ยน ก็ไม่ตรงกับที่จดไว้ รายการหลุดจากตัวกรองแล้วถูกลองใหม่เองโดยไม่ต้องมีใครไปล้างไฟล์
def worth_sending(entry, failed, retry_failed=False):
    """False เมื่อทุกฟิลด์ของรายการนี้ล้มมาแล้วด้วยข้อความไทยตัวเดิม"""
    if retry_failed or entry.get('reviewer_note'):
        return True
    for f in entry['fields']:
        rec = failed.get(f['key'])
        if rec is None or rec['hash'] != f['hash']:
            return True          # มีอย่างน้อยหนึ่งฟิลด์ที่ยังไม่เคยล้ม หรือต้นฉบับเปลี่ยนแล้ว
    return False

def fill_batch(queue, failed, size, retry_failed=False):
    batch = []
    for entry in queue:
        if worth_sending(entry, failed, retry_failed):
            batch.append(entry)
            if len(batch) == size:
                break
    return batch
บทเรียนของผมคือ สมุดจดของที่ล้มมีสองหน้าที่ หน้าที่แรกคือกันเผาโทเคนซ้ำ หน้าที่สองที่ลืมคิดคือต้องไม่ไปบังของที่ยังไม่ได้ทำ ใครทำระบบคิวที่มี "ข้ามของที่ล้ม" ให้ทดสอบกรณีที่ของที่ล้มอยู่หัวคิวทั้งแบตช์ด้วย ผมเคยเขียนเรื่องคล้ายกันที่ทุกชั้นรายงานสำเร็จทั้งที่ผลเป็นขยะไว้ใน ทุกชั้นรายงานสำเร็จพร้อมกัน คำว่า "ไม่มีอะไรเหลือ" ก็เป็นข้อความสำเร็จแบบหนึ่งที่ต้องไปนับเทียบกับตารางจริง
Translation memory กับการแบ่งบล็อกยาว
ย่อหน้าซ้ำกันในเว็บเยอะกว่าที่คิด คำเตือน ท้ายหน้า ข้อความปุ่ม ผมเลยเก็บ translation memory ไว้ในไฟล์ SQLite คีย์เป็น sha1 ของบล็อกไทย ต่อฉบับแปล ย่อหน้าซ้ำเลยฟรี ไม่เสียโทเคน ส่วน HTML ยาวผมแบ่งเป็นบล็อกระดับบนสุด ยาวไม่เกินราว 3,000 ตัวอักษร ส่งแปลทีละบล็อก เหตุผลคือถ้าล้มทีเดียวก็ทำใหม่แค่บล็อกเดียว ไม่ต้องทำทั้งหน้า พอแปลครบแล้วประกอบกลับ แล้วตรวจค่าที่ประกอบแล้วด้วยด่านเดิมอีกรอบ เพราะรอยต่อระหว่างบล็อกเป็นจุดที่ tag หลุดได้
CREATE TABLE IF NOT EXISTS tm (
  src_hash CHAR(40) NOT NULL,
  locale   CHAR(2)  NOT NULL,
  value    TEXT     NOT NULL,
  PRIMARY KEY (src_hash, locale)
);
ส่วนเครื่องยนต์แปลผมทำให้เสียบเปลี่ยนได้ผ่าน interface เดียว คือ ask(text) คืน (answer, usage) จะเป็น Claude, Gemini, agy หรือเครดิต API สำรองก็ได้ ด่านโค้ดกับ hash ไม่รู้เรื่องว่าข้างหลังเป็นโมเดลอะไร เลยสลับเครื่องยนต์กลางงานได้โดยไม่ต้องแตะระบบที่เหลือ
ประตูเผยแพร่ทีละหน้า และลูปรีวิวที่ไม่ได้เปิด
อีกเรื่องที่ไม่ใช่เรื่องแปลโดยตรงแต่ขาดไม่ได้ คือคนอ่านไม่ควรเจอหน้าที่แปลครึ่งเดียว ในหน้า en ถ้าหน้านั้นยังแปลไม่ครบทุกบล็อก เว็บจะแสดงเนื้อหาไทยพร้อมแบนเนอร์บอก และใส่ noindex เฉพาะหน้า เฉพาะหน้า "พร้อม" เท่านั้นที่เข้า sitemap และ IndexNow ก็ทิ้ง URL en ที่ไม่อยู่ใน sitemap ผลคือผู้ใช้ไม่เจอหน้าครึ่งๆ กลางๆ และเสิร์ชเอนจินไม่เห็นหน้าเนื้อหาไทยซ้ำอยู่ใต้ URL ของฉบับอังกฤษ ส่วนกลไกส่ง URL เข้า IndexNow ผมแยกไปเล่าใน แจ้ง Bing ทันทีที่แก้หน้า
ระบบรองรับลูปรีวิวด้วย คือให้โมเดลตัวที่สองให้คะแนน 1 ถึง 5 พร้อมโน้ต ใช้ value_hash กันกรณีแถวเปลี่ยนระหว่างที่รีวิวเวอร์อ่านกับตอนเขียนผลกลับ คะแนนต่ำกว่าเกณฑ์เข้าคิวแก้ ตัวแก้คืนเฉพาะคำที่ผิด บันทึกเป็น machine บวก reviewed ไม่เข้าคิวซ้ำ เกินรอบสูงสุดก็เป็น needs_human ให้แอดมินดู แต่เจ้าของงานตัดสินใจว่าโมเดลแบบ Flash ไม่ต้องรีวิวรอบสอง เปิดแค่ด่านโค้ดตลอด ซึ่งส่วนตัวผมก็เห็นด้วยกับต้นทุนที่ประหยัดได้ ตราบใดที่ผลสุ่มตรวจยังไม่มีอะไรน่าห่วง ตามความเห็นของแต่ละที่ก็แล้วกัน
เปิดตลอด ทุกฟิลด์
ถูก เร็ว แม่นกับของที่พังเชิงโครงสร้าง จับ tag หาย เลขหาย ภาษาผิด ความยาวผิดปกติ แต่ไม่รู้เรื่องความหมาย
ปิดไว้ในงานนี้
อ่านความหมายได้ แต่ต้องจ่ายโทเคนเพิ่มอีกรอบกับทุกแถว เจ้าของงานเลือกไม่เปิด และใช้การสุ่มตรวจจากแถวที่ผ่านด่านแล้วแทน
สรุปสิ่งที่ผมจะทำเหมือนเดิม
ถ้าต้องแปลเว็บก้อนใหญ่อีกรอบ ผมจะเก็บของห้าอย่างนี้เหมือนเดิม หนึ่ง hash ของต้นฉบับต่อฟิลด์ เพื่อให้รันต่อได้และแก้ต้นฉบับแล้วเข้าคิวเอง สอง ให้เซิร์ฟเวอร์คำนวณ hash ซ้ำตอนรับผล ไม่เชื่อค่าที่รันเนอร์ส่งมา สาม ด่านโค้ดที่ไม่ใช้ AI ตรวจผลก่อนบันทึกทุกฟิลด์ สี่ ล้มสองรอบแล้วจดไว้พร้อม hash ห้ามส่งซ้ำ แต่ต้องกรองก่อนเติมแบตช์ ไม่ใช่หลังเติม ห้า ประตูเผยแพร่ทีละหน้า ให้คนอ่านและเสิร์ชเอนจินเห็นแต่หน้าที่พร้อมจริง
ส่วนข้อที่ผมไม่ทำคือเชื่อว่าด่านโค้ดทำให้คำแปลถูกต้อง มันทำให้คำแปล "ไม่พัง" เท่านั้น ความถูกต้องของความหมายยังต้องพึ่งโมเดลที่ดี glossary ที่ดี และการสุ่มตรวจโดยคนอยู่ดี ใครจะเอาแนวทางนี้ไปปรับกับงานของตัวเองก็ปรับค่า 0.35 หรือ 40 ตัวตามข้อมูลของตัวเองได้เลย ผมใช้ค่าตามที่เจอจริงกับเว็บเดียวเท่านั้น ที่ตกหล่นตรงไหนหรือเจอเคสที่ด่านตีตกของดี เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย