ย้าย DA สู่ Debian 12 ตอนที่ 2 — เปลี่ยน storage เป็น ZFS mirror
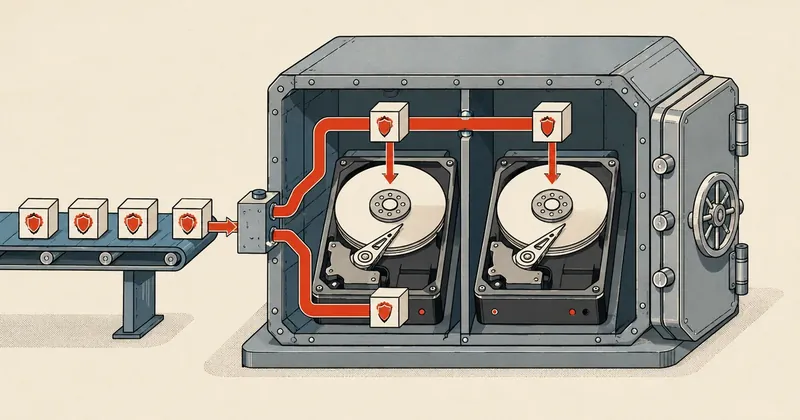
รอบนี้ผมขอเล่าเรื่องชั้น storage ครับ ของเดิมเป็น mdadm RAID1 ซ้อน ext4 ซ้อน qcow2 รวมสามชั้น ในเมื่อจะข้าม distro ทั้งทีผมเลยถือโอกาสรื้อลงมาเหลือชั้นเดียวด้วย ZFS ไปเลย
ตอนแรกผมว่าด้วยเรื่องเตรียม VM กับการ NAT pre-stage ไปแล้ว ใครยังไม่ได้อ่านแนะนำให้ย้อนกลับไปดูตอนที่ 1 ก่อน เพราะตอนนี้จะต่อจากจุดนั้น
ตอนนี้จะมาว่าด้วยชั้น storage โดยเฉพาะ ของผมเดิมเป็น mdadm RAID1 + ext4 + qcow2 ทับกันสามชั้น ซึ่งใช้งานมานานและไม่ได้พังอะไร แต่พอจะข้าม distro ทั้งที ผมตัดสินใจรื้อชั้น storage ใหม่ไปด้วยเลย
ทำไมผมถึงเปลี่ยนมาใช้ ZFS
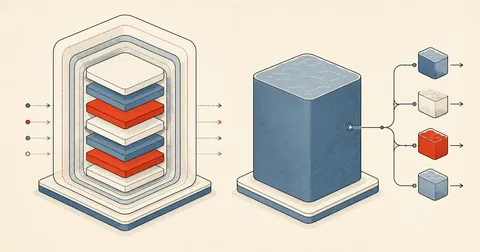
ขอเล่าเหตุผลตามที่ผมเจอกับงานจริง ไม่ใช่ทฤษฎีในหนังสือ การวาง mdadm + ext4 + qcow2 ซ้อนกันสามชั้นมันมีต้นทุนที่มองไม่เห็น พอเขียนทีหนึ่งต้อง fsync ลงไปทุกชั้น เกิดอาการ fsync amplification คือ write จริงบน disk หนักกว่าที่ guest สั่งมาก และเวลาจะทำ snapshot ก็ยุ่ง เพราะ qcow2 snapshot กับ LVM snapshot มันคนละกลไกกัน
พอย้ายมาเป็น ZFS mirror + raw zvol มันเหลือชั้นเดียว snapshot เป็น native ทำได้ทันทีโดยแทบไม่กิน IO ตอนสร้าง นี่คือเหตุผลหลัก ส่วนที่เหลือเป็นของแถมที่ผมได้มาฟรีๆ
mdadm + ext4 + qcow2
- ซ้อนกันสามชั้น
- fsync amplification เยอะ
- snapshot ยุ่ง คนละกลไกกันแต่ละชั้น
- ไม่มี checksum กัน silent corruption
ZFS mirror + raw zvol
- เหลือชั้นเดียว
- native snapshot ทันที
- compression zstd ฟรี
- ARC read cache + scrub/checksum
ไล่เป็นข้อๆ ที่ผมได้จากการเปลี่ยน
- compression zstd ฟรีๆ ratio ดีกว่า lz4 เยอะ เครื่องผม CPU 16 core เลยรับภาระ compress ได้สบาย แลกพื้นที่ disk กลับมาคุ้ม
- ARC cache 4-8GB เป็น read cache บน RAM ลด random IO ของ MariaDB ลงเห็นได้ชัด พวก query ที่อ่านซ้ำๆ แทบไม่แตะ disk เลย
- scrub + checksum กัน silent corruption นี่คือสิ่งที่ mdadm + ext4 ให้ไม่ได้ มันตรวจ checksum ทุกบล็อกที่อ่าน ถ้า bit เพี้ยนมันรู้ทันทีและซ่อมจาก mirror อีกใบให้
เรื่อง silent corruption ผมเจอกับตัวมาแล้วตอนปี 2018 ตอนนั้นยังอยู่บน mdadm มี HDD ทรุดเงียบๆ ไม่มี error ฟ้องเลย ระบบวิ่งต่อจนถึงวันที่ต้อง restore ถึงรู้ว่าไฟล์เสียไปนานแล้ว สุดท้ายเสียลูกค้าไปหนึ่งราย ตั้งแต่นั้นผมเลยให้น้ำหนักกับ checksum-based storage มาตลอด
ใครจะคงอยู่ที่ mdadm + ext4 ก็ตามสะดวกครับ มันยังใช้งานได้ปกติ ไม่ได้เป็นของเสีย แต่ถ้าจะข้าม distro รอบนี้ทั้งที ส่วนตัวผมยอมเสียเวลาเพิ่มอีกวันเปลี่ยน storage layer ไปพร้อมกันเลย คุ้มกว่ามากเมื่อเทียบกับการมาทำทีหลังตอนระบบ online แล้ว
หัวใจของทริค — ทำได้ขณะ VM เก่ายัง online
จุดที่ผมว่ายากและน่าสนใจที่สุดของตอนนี้คือ เราเปลี่ยน storage layer ได้โดยที่ VM เก่ายังให้บริการอยู่ ไม่ต้องดับเครื่องลูกค้า หลักการคือใช้ประโยชน์จากการที่ RAID1 มี disk สองใบที่ข้อมูลเหมือนกัน
แนวคิดคือ degrade RAID ให้เหลือ disk ใบเดียวก่อน แล้วเอา disk อีกใบที่ปลดออกมาไปทำ ZFS pool ใหม่ พอ cutover ย้ายงานข้ามไปฝั่ง ZFS เสร็จเรียบร้อย ค่อยเอา disk เก่ากลับเข้ามา attach เข้า pool ให้ resilver กลายเป็น mirror สมบูรณ์อีกครั้ง
ทั้งหมดนี้แลกมาด้วยช่วงเสี่ยง คือระหว่างที่ degrade แล้ว ระบบเก่าจะวิ่งบน single disk ชั่วคราว ถ้า disk ใบนั้นพังในช่วงนี้คือ data loss เต็มๆ เพราะ mirror ไม่เหลือแล้ว เดี๋ยวจะพูดเรื่อง insurance อีกที
ขั้นตอนที่ 1 — degrade RAID เหลือ disk ใบเดียว
เริ่มจากดูสถานะ md array ก่อนว่าตอนนี้มี disk อะไรอยู่บ้าง
cat /proc/mdstat
# md0 : active raid1 sdc[0] sdb[1]   (กลุ่ม 2 disk)
ในตัวอย่างนี้ md0 เป็น RAID1 มี sdc กับ sdb ผมจะปลด sdc ออกมาทำ ZFS เก็บ sdb ไว้ให้ระบบเก่าวิ่งต่อ การปลดต้อง mark fail ก่อน แล้วค่อย remove จากนั้นสั่ง grow ให้ array ยอมรับว่าตอนนี้มี disk ใบเดียว
mdadm --manage /dev/md0 --fail /dev/sdc
mdadm --manage /dev/md0 --remove /dev/sdc
mdadm /dev/md0 --grow --raid-devices=1 --force
ขั้นต่อมาสำคัญ ต้องลบ mdadm superblock ออกจาก sdc ก่อน ไม่งั้นพอ ZFS หรือ kernel มาสแกนเจอ md metadata ค้างอยู่ มันจะงงและอาจพยายาม assemble array กลับมาเอง
wipefs -a /dev/sdc
cat /proc/mdstat   # md0 ตอนนี้เหลือแค่ sdb
ตั้งแต่ตรงนี้ไปจนกว่าจะ attach disk กลับเข้า pool ระบบเก่าวิ่งอยู่บน single disk (sdb) ใบเดียว ถ้า sdb พังตอนนี้คือ data loss เพราะไม่มี mirror สำรองแล้ว นี่คือช่วง risk สูงสุดของกระบวนการทั้งหมด
Insurance — backup ก่อนเริ่ม ห้ามข้าม
เพราะเป็นช่วงเสี่ยงสูงสุด ผมแนะนำหนักแน่นว่าต้องทำ full backup ลง disk อีกตัวหนึ่ง (HDD ก้อนใหญ่ที่แยกจากคู่ที่กำลังทำงานอยู่) ก่อนลงมือ ถ้าใช้ Proxmox ก็ใช้ vzdump ดึง VM ทั้งก้อนออกมาเป็น snapshot
vzdump <vmid> --dumpdir /mnt/backup --mode snapshot --compress zstd
ใครคิดจะข้าม backup ขั้นนี้ผมไม่แนะนำเลยครับ มันเป็นจุดเดียวในกระบวนการที่ถ้าพลาดแล้วกู้ไม่กลับ เสียเวลา backup เพิ่มไม่กี่สิบนาที แลกกับความสบายใจตลอดช่วงที่วิ่ง single disk คุ้มมาก
ขั้นตอนที่ 2 — สร้าง ZFS pool บน disk ที่ปลดออกมา
ตอนนี้ sdc ว่างและสะอาดแล้ว เอามาสร้าง pool ได้ ผมแนะนำให้อ้างถึง disk ด้วย /dev/disk/by-id/... แทนชื่อ /dev/sdc ตรงๆ เพราะชื่อ sdX เปลี่ยนได้ตามลำดับ enumeration ของ kernel แต่ by-id ยึดติดกับตัว disk จริง ปลอดภัยกว่าเวลามีหลายลูก
zpool create -o ashift=12 -o autotrim=on \
  -O compression=zstd -O atime=off -O xattr=sa -O acltype=posixacl \
  vmdata /dev/disk/by-id/ata-<MODEL>_<SERIAL-A>
ขออธิบายแต่ละ option เพราะมันมีผลตอน production จริง
- ashift=12 บอกขนาด sector เป็น 4KB ซึ่งตรงกับ SSD รุ่นใหม่ ถ้าใช้ HDD จานหมุนรุ่นเก่าที่ยังเป็น 512-byte sector ให้ใส่
ashift=9แทน - autotrim=on เปิด TRIM อัตโนมัติ ช่วยลด wear ของ SSD ในระยะยาว
- compression=zstd ratio ดีกว่า lz4 มาก แลกกับ CPU ที่เหลือเฟืออยู่แล้ว
- atime=off ปิดการอัปเดต access time ทุกครั้งที่อ่านไฟล์ ตัด write IO ที่ไม่จำเป็นทิ้ง
- xattr=sa + acltype=posixacl เปิด POSIX ACL support ตัวนี้ DA ต้องใช้ตอนทำ quota ถ้าไม่ใส่จะเจอปัญหาทีหลัง
จาก ashift ที่เกริ่นไว้ ผมขอย้ำว่ามันคือจุดที่พลาดบ่อยที่สุดของ ZFS ค่านี้ fix ตั้งแต่ตอน create แก้ทีหลังไม่ได้ ถ้าใส่ผิดต้อง destroy pool แล้วสร้างใหม่อย่างเดียว ทำใจไว้ก่อนเลยว่าเลือกให้ถูกตั้งแต่แรกสำคัญมาก SSD ใหม่ใช้ 12 HDD เก่าใช้ 9
ขั้นตอนที่ 3 — จำกัด ARC cache
ARC คือ read cache ของ ZFS ที่อยู่บน RAM โดย default มันจะกินได้ถึงครึ่งหนึ่งของ RAM ทั้งเครื่อง บนเซิร์ฟเวอร์ที่รัน VM เยอะๆ เราไม่อยากให้มันแย่ง RAM ของ guest เลยควร cap ไว้ ผมตั้งไว้ที่ 8GB
ตั้งทั้งค่าที่ใช้ทันที (เขียนลง sysfs) และค่าที่ persist ข้าม reboot (เขียนลง modprobe config) ตัวเลข 8589934592 คือ 8GB ในหน่วย byte
echo 8589934592 > /sys/module/zfs/parameters/zfs_arc_max
echo 'options zfs zfs_arc_max=8589934592' > /etc/modprobe.d/zfs.conf
ขั้นตอนที่ 4 — เพิ่ม ZFS เป็น Proxmox storage
ให้ Proxmox รู้จัก pool ที่เพิ่งสร้าง จะได้สั่งสร้าง VM disk ลงบนนี้ได้ ทำผ่าน CLI ก็ได้
pvesm add zfspool VMDATA --pool vmdata --content rootdir,images
หรือถ้าถนัด web UI ก็ไปที่ Datacenter แล้วเข้า Storage เลือก Add แล้วเลือก ZFS ตั้ง ID เป็น VMDATA แล้ว save ผลเหมือนกัน เลือกตามสะดวก
ขั้นตอนที่ 5 — หลัง cutover แล้ว attach disk เก่ากลับเข้า mirror
พอย้ายงานข้ามมาฝั่ง ZFS เรียบร้อย ทดสอบจน VM ใหม่วิ่งดีแล้ว ก็ถึงเวลาทำลาย VM เก่าและเอา sdb (disk ที่เหลือใน array เดิม) กลับเข้า pool เพื่อให้กลายเป็น mirror สองใบเหมือนเดิม
ก่อนอื่นต้องล้าง md superblock ออกจาก sdb ด้วย เหมือนที่ทำกับ sdc ตอนแรก จากนั้นสั่ง attach เข้า pool โดยระบุ disk ที่อยู่ใน pool อยู่แล้วเป็นตัวอ้างอิง ตามด้วย disk ใหม่ที่จะเพิ่ม
wipefs -a /dev/sdb
zpool attach vmdata \
  /dev/disk/by-id/ata-<MODEL>_<SERIAL-A> \
  /dev/disk/by-id/ata-<MODEL>_<SERIAL-B>
พอ attach เสร็จ ZFS จะเริ่ม resilver อัตโนมัติ คือ copy ข้อมูลจาก disk เดิมไปเติม disk ใหม่ให้ครบ ของผมใช้เวลาราว 2-3 ชั่วโมง ความเร็วขึ้นกับปริมาณข้อมูลและ IO ที่ระบบรับอยู่ขณะนั้น ดู progress ได้ตลอด
zpool status vmdata
รอจน state ขึ้นว่า resilvered เรียบร้อยและ pool เป็น ONLINE ทั้งคู่ ก็ถือว่ากลับมาเป็น mirror เต็มรูปแล้ว ตอนนี้พังไปใบนึงก็ไม่เป็นไรเหมือนเดิม
Maintenance ระยะยาว — scrub ประจำสัปดาห์
ของแถมสำคัญของ ZFS คือ scrub มันจะไล่อ่านทุกบล็อกในpool มาเทียบ checksum เพื่อตรวจจับและซ่อม silent corruption ก่อนที่มันจะลามจนกู้ไม่ได้ ตั้ง cron ให้รันสัปดาห์ละครั้งในช่วงดึกที่โหลดน้อย
echo '0 3 * * 0 root zpool scrub vmdata' > /etc/cron.d/zfs-scrub
อันนี้ตั้งให้รันทุกวันอาทิตย์ตีสาม ปรับเวลาตามช่วงที่เซิร์ฟเวอร์ว่างได้ตามสะดวก สิ่งที่ผมเสียลูกค้าไปเมื่อปี 2018 ก็เพราะไม่มีกลไก scrub แบบนี้คอยตรวจให้นั่นแหละ
สรุปและตอนต่อไป
ทั้งตอนนี้คือการรื้อ storage จากสามชั้นเหลือชั้นเดียว โดยอาศัยจังหวะที่มี disk สองใบใน RAID1 สลับเอามาทำ ZFS ทีละใบ จุดที่ต้องระวังที่สุดมีสองอย่าง คือช่วง single disk ที่ต้อง backup กันไว้ก่อน และการเลือก ashift ให้ถูกตั้งแต่ create เพราะแก้ทีหลังไม่ได้
ตอนหน้าจะต่อเรื่องลง DA กับ CustomBuild stack ทั้งชุดบน staging VM ทั้ง PHP หลาย slot, nginx + ModSec, rspamd, proftpd ไล่กันไป
ตรงไหนผมนึกออกเพิ่มหรือเจอว่าพลาดจะกลับมาแก้ให้ ใครจะคงอยู่ที่ mdadm หรือจะข้ามมา ZFS ก็ตามสะดวกครับ หลักการ degrade-แล้ว-migrate เหมือนกันหมด
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย