time-series เป็น JSON โตวันละ 50 MB ย้ายลงคอลัมน์โดยไม่แก้ dashboard

ตอนเริ่มเก็บข้อมูลผมเลือกเก็บทุกอย่างไว้ก่อนเพราะยังไม่รู้ว่าค่าไหนมีประโยชน์ พอรู้แล้วว่าใช้จริงแค่เจ็ดค่าจากเจ็ดสิบสี่ค่า ตารางก็โตจนดิสก์ใกล้เต็มไปแล้ว
พอดีระบบเก็บค่าจากอุปกรณ์ในโรงงานที่ผมทำไว้มันโตเร็วกว่าที่ประเมินไว้เยอะ ตอนออกแบบผมเก็บทั้งเฟรมที่อ่านมาได้เป็น JSON array ลงคอลัมน์เดียว เหตุผลตอนนั้นคือยังไม่รู้ว่า register ตัวไหนมีความหมายอะไร เก็บไว้ก่อนดีกว่ามาเสียใจทีหลัง ผ่านไปสองสัปดาห์ดิสก์เริ่มบ่น ผมมานั่งนับดูถึงรู้ว่าเก็บวินาทีละแถว แถวละเจ็ดสิบสี่ค่า แต่ที่เอาไปใช้จริงบนหน้าเว็บมีแค่เจ็ดค่า เลยต้องรื้อ schema ใหม่ทั้งระบบทั้งที่ dashboard กับ API ถูกใช้งานอยู่ตลอดเวลา บทความนี้คือวิธีที่ผมย้ายโดยไม่ให้ฝั่งที่เรียกใช้ต้องแก้อะไรเลยสักบรรทัด
ชื่อตาราง ชื่อคอลัมน์ และเลข IP ในบทความเป็นของสมมติทั้งหมด ส่วนตัวเลขขนาดและเวลาที่วัดได้คือของจริงจากงานที่ทำ
อาการ: ดิสก์โตวันละ 50 MB โดยไม่มีใครสังเกต
โครงเดิมหน้าตาแบบนี้ครับ เรียบง่ายมาก อ่านมาได้เท่าไหร่ยัดลงไปทั้งก้อน
-- schema เดิม: เก็บทั้งเฟรมเป็น JSON array 74 ค่า ทุก 1 วินาที
CREATE TABLE raw_dump (
  ts_unix   BIGINT       NOT NULL,
  slave     TINYINT      NOT NULL,
  regs      JSON         NOT NULL,   -- [0,0,152,...] ยาว 74 ช่อง
  frames    TEXT         NULL,       -- hex ดิบของ response ไว้ debug
  PRIMARY KEY (ts_unix, slave)
) ENGINE=InnoDB ROW_FORMAT=DYNAMIC;
ขนาดที่โตขึ้นดูได้จาก information_schema ตรง ๆ ไม่ต้องไปนั่ง du ที่ datadir
-- ดูขนาดจริงรายตาราง ก่อนตัดสินใจอะไร
SELECT TABLE_NAME,
       ROUND((DATA_LENGTH + INDEX_LENGTH)/1024/1024) AS mb,
       TABLE_ROWS
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'edge_db'
ORDER BY (DATA_LENGTH + INDEX_LENGTH) DESC;
ตัวเลขที่ได้ตอนนั้นคือ 183 MB ที่เครื่องปลายทางในโรงงาน และ 625 MB บนเซิร์ฟเวอร์ที่รับ push ต่อ ทั้งคู่เก็บย้อนหลังแค่ 14 วันเท่านั้น ที่ต่างกันเพราะฝั่งเซิร์ฟเวอร์เก็บทั้ง JSON เดิมและคอลัมน์ที่ decode แล้วซ้ำอีกชุดหนึ่ง คือเก็บของเดียวกันสองรอบโดยไม่ได้ตั้งใจ
ปัญหาที่ใหญ่กว่าขนาด คือ JSON_EXTRACT ทำ index ไม่ได้
ขนาดยังพอทนได้ครับ ซื้อดิสก์เพิ่มก็จบ แต่ที่ทนไม่ได้คือความเร็ว query สรุปรายเดือนหน้าตาแบบนี้
-- query เดิม: ทุกแถวต้องถูกอ่านขึ้นมา parse JSON ก่อนถึงจะรู้ว่าเอาหรือไม่เอา
SELECT FLOOR((ts_unix + 25200)/86400) AS d,
       AVG(JSON_EXTRACT(regs, '$[8]')) AS comp_amp
FROM raw_dump
WHERE slave = 20
  AND ts_unix BETWEEN ? AND ?
GROUP BY d;
ถ้าเป็น MariaDB รุ่นใหม่พอจะทำ generated column แล้ว index ทับได้อยู่ครับ แต่พอผมนั่งลิสต์ว่าต้องสร้าง generated column กี่ตัวถึงจะครบที่ใช้ คำตอบคือเจ็ดตัว แล้วแต่ละตัวก็กินที่เพิ่มอีก สรุปว่าเก็บ JSON ไว้ทำไมตั้งแต่แรก ในเมื่อสุดท้ายต้องแตกออกมาเป็นคอลัมน์อยู่ดี
ผมไม่ได้จะบอกว่า JSON ในฐานข้อมูลเป็นของไม่ดีนะครับ มันเหมาะมากกับ payload ที่รูปร่างไม่แน่นอน เช่น config ต่อลูกค้า หรือ metadata ที่แต่ละแถวมีฟิลด์ไม่เหมือนกัน แต่ time-series คือข้อมูลที่รูปร่างเหมือนกันเป๊ะทุกแถว และเรารู้รูปร่างนั้นแน่นอนแล้ว ของแบบนี้เก็บเป็นคอลัมน์ตั้งแต่แรกถูกกว่าทุกทาง
สำรวจก่อนลงมือ: register ตัวไหนมีข้อมูลจริง
ก่อนตัดว่าจะเก็บอะไรทิ้งอะไร ผมนับความหลากหลายของค่าในแต่ละช่องก่อน ช่องไหนที่ทั้งเดือนมีค่าเดียวคือช่องตายที่ไม่ได้ต่อสายอะไรไว้
-- นับ distinct รายช่อง: ช่องที่ distinct = 1 คือช่องตาย ตัดทิ้งได้เลย
SELECT 8  AS reg, COUNT(DISTINCT JSON_EXTRACT(regs,'$[8]'))  AS n FROM raw_dump WHERE slave=20
UNION ALL SELECT 9,  COUNT(DISTINCT JSON_EXTRACT(regs,'$[9]'))  FROM raw_dump WHERE slave=20
UNION ALL SELECT 10, COUNT(DISTINCT JSON_EXTRACT(regs,'$[10]')) FROM raw_dump WHERE slave=20
UNION ALL SELECT 11, COUNT(DISTINCT JSON_EXTRACT(regs,'$[11]')) FROM raw_dump WHERE slave=20
UNION ALL SELECT 24, COUNT(DISTINCT JSON_EXTRACT(regs,'$[24]')) FROM raw_dump WHERE slave=20;
จาก 57,000 sample ผมได้คำตอบชัดเจนว่ามีห้าช่องเท่านั้นที่ขยับ ที่เหลือนิ่งสนิททั้งเดือน บวกกับอีกสองช่องจากอุปกรณ์วัดอุณหภูมิอีกตัว รวมเป็นเจ็ดค่าที่ต้องเก็บต่อ ส่วนคอลัมน์ frames ที่เก็บ hex ดิบไว้ debug ผมเปิดดูครั้งสุดท้ายตั้งแต่ตอนเขียน decoder เสร็จ นั่นคือหกเดือนก่อนหน้านั้น ตัดทิ้งได้สบายใจ
ตัดสินใจข้อสำคัญ: เก็บค่าดิบ ไม่ใช่ค่าที่แปลงแล้ว
ตรงนี้เป็นจุดที่ผมคิดอยู่นานครับ เพราะค่าที่อ่านจากอุปกรณ์เป็นเลขจำนวนเต็มที่ต้องหารสเกลก่อนถึงจะเป็นหน่วยจริง เช่นกระแสต้องหารร้อย อุณหภูมิต้องหารสิบ คำถามคือเก็บเลขดิบหรือเก็บค่าที่หารแล้ว
อ่านง่ายแต่เสี่ยง
SELECT ออกมาแล้วเป็นหน่วยจริงเลย ไม่ต้องจำสเกล แต่ถ้าวันหน้าพบว่าสเกลที่ใช้ผิด ข้อมูลเก่าทั้งหมดที่เก็บไว้จะผิดตามไปด้วยและย้อนกลับไม่ได้ ถ้าใช้ float ยังเจอเรื่องปัดเศษสะสมตอน SUM ยาว ๆ อีก
ตรงกับสิ่งที่อุปกรณ์บอก
ที่เก็บลงตารางคือสิ่งที่สายส่งมาจริง ๆ ไม่มีการตีความ การหารสเกลย้ายไปอยู่ชั้น API ที่แก้ได้ทุกเมื่อและมีผลย้อนหลังทันที ขนาดก็เล็กกว่าเพราะ INT กับ SMALLINT กินน้อยกว่า DECIMAL ผมเลือกทางนี้
กฎที่ผมยึดตั้งแต่นั้นคือชั้นเก็บข้อมูลมีหน้าที่จำ ไม่มีหน้าที่ตีความ การตีความให้ไปอยู่ชั้นที่แก้แล้วมีผลย้อนหลังได้ ซึ่งก็คือ API ไม่ใช่ตาราง อันนี้ช่วยผมไว้จริง ๆ ตอนหลังพบว่าป้ายชื่อ register ตัวหนึ่งที่เคยเข้าใจว่าเป็นอุณหภูมิคอยล์ร้อนนั้นผิด แก้แค่ชั้นแปลงค่าก็จบ ข้อมูลเก่าไม่ต้องแตะเลย
schema ใหม่ กับการย้ายแบบไม่ปิดระบบ
-- schema ใหม่: เก็บเฉพาะ register ที่ใช้จริง เป็นค่าดิบ คงสเกลเดิม
CREATE TABLE raw_dump__new (
  ts_unix BIGINT   NOT NULL,
  slave   TINYINT  NOT NULL,
  comp    INT      NULL,   -- reg 8  กระแสคอมเพรสเซอร์ ดิบ (÷100 ตอนแสดงผล)
  cond    INT      NULL,   -- reg 9
  evap    INT      NULL,   -- reg 10
  heat    INT      NULL,   -- reg 11
  freq    INT      NULL,   -- reg 24
  room    SMALLINT NULL,   -- อุณหภูมิห้อง จากอุปกรณ์อีกตัว (÷10)
  pipe    SMALLINT NULL,
  PRIMARY KEY (ts_unix, slave),
  KEY rd_slave_ts (slave, ts_unix)
) ENGINE=InnoDB ROW_FORMAT=DYNAMIC;
PK เป็น (ts_unix, slave) ตั้งแต่แรกซึ่งช่วยไว้เยอะ เพราะพอมีอุปกรณ์ตัวที่สองเข้ามาบนบัสเดียวกัน ตารางรองรับได้ทันทีโดยไม่ต้องแก้อะไร ส่วน index ตัวที่สองเป็น (slave, ts_unix) ไว้ให้ query ที่กรอง slave ก่อนแล้วไล่ช่วงเวลา ซึ่งเป็นรูปแบบที่หน้าเว็บใช้บ่อยที่สุด
การย้ายข้อมูลเก่าผมทำเป็นก้อนตามช่วงเวลา ไม่ยิงทีเดียวจบ เพราะตารางยังมีคนเขียนเข้ามาทุกวินาที
-- backfill ทีละวัน ไม่ล็อกยาว ; รันวนจากสคริปต์ข้างนอก
INSERT IGNORE INTO raw_dump__new (ts_unix, slave, comp, cond, evap, heat, freq)
SELECT ts_unix, slave,
       JSON_EXTRACT(regs,'$[8]'),  JSON_EXTRACT(regs,'$[9]'),
       JSON_EXTRACT(regs,'$[10]'), JSON_EXTRACT(regs,'$[11]'),
       JSON_EXTRACT(regs,'$[24]')
FROM raw_dump
WHERE slave = 20 AND ts_unix >= ? AND ts_unix < ?;
# วนย้อนหลัง 14 วัน วันละก้อน แล้วหน่วงให้ดิสก์ได้หายใจ
for d in $(seq 14 -1 0); do
  FROM=$(date -d "-$d day 00:00" +%s); TO=$(date -d "-$((d-1)) day 00:00" +%s)
  mariadb edge_db -e "SET @f=$FROM; SET @t=$TO; SOURCE /opt/app/ops/backfill.sql;" || exit 1
  echo "$(date '+%F %T') backfill OK $(date -d @$FROM +%F)"
  sleep 5
done
ตอนสลับผมใช้ RENAME TABLE สองตัวพร้อมกันในคำสั่งเดียวเพื่อให้เป็น atomic แล้วเก็บตารางเก่าไว้เป็น raw_dump__old อีกสามวันก่อนลบจริง เพราะกว่าจะรู้ว่ามีอะไรพลาดมักจะเป็นตอนที่คนเปิดรายงานย้อนหลังในวันจันทร์ ไม่ใช่ตอนที่เรากด RENAME เสร็จ พื้นที่ที่เสียไปสามวันถูกกว่าการกู้ข้อมูลที่ไม่มีให้กู้เยอะ
-- สลับแบบ atomic คำสั่งเดียว ไม่มีช่วงที่ไม่มีตารางชื่อ raw_dump
RENAME TABLE raw_dump TO raw_dump__old, raw_dump__new TO raw_dump;
หัวใจของงาน: ให้ dashboard ไม่รู้ตัวว่า schema เปลี่ยน
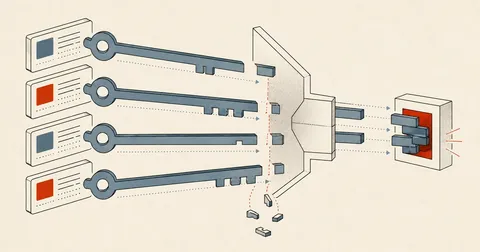
หน้าเว็บเดิมเขียนไว้ว่าอ่าน L.regs[8] L.regs[9] แบบนี้กระจายอยู่หลายสิบจุด ทั้งการ์ด ทั้งกราฟ ทั้งแถบวิ่งด้านบน ถ้าจะไล่แก้ทุกจุดให้อ่านชื่อคอลัมน์ใหม่คือเปิดโอกาสพลาดฟรี ๆ ผมเลยเลือกวิธีที่ตรงข้าม คือให้ API ประกอบ array กลับคืนให้เหมือนเดิมแบบ sparse ใส่ค่าเฉพาะ index ที่มีจริง ที่เหลือปล่อยเป็น null
// API ประกอบ regs[] กลับคืนแบบ sparse ให้ client เดิมใช้ต่อได้ไม่ต้องแก้
function regsFromColumns(object $r): array
{
    $map  = [8 => 'comp', 9 => 'cond', 10 => 'evap', 11 => 'heat', 24 => 'freq'];
    $regs = array_fill(0, 25, null);
    foreach ($map as $i => $col) {
        $regs[$i] = isset($r->$col) ? (int) $r->$col : null;
    }
    return $regs;
}
วิธีนี้ทำให้ผมย้าย schema ได้โดย deploy แค่ฝั่งหลังบ้าน แล้วค่อย ๆ ไล่แก้หน้าเว็บทีหลังตอนว่าง โดยไม่มีเส้นตายบังคับ ส่วนตัวผมถือว่านี่คือข้อดีข้อใหญ่ที่สุดของการมีชั้น API คั่นกลาง ถ้าหน้าเว็บคุยกับฐานข้อมูลตรง ๆ งานนี้จะกลายเป็นงานที่ต้องเปลี่ยนสองฝั่งพร้อมกันในนาทีเดียว ซึ่งเป็นงานที่พลาดง่ายที่สุด
ฝั่งที่ส่งข้อมูลเข้ามาต้องแก้ด้วย และต้องรับของเก่าได้
ตัวอ่านค่าที่เครื่องปลายทางกับตัว push ที่ส่งขึ้นเซิร์ฟเวอร์ต้องเปลี่ยนรูปแบบ payload ตามไปด้วย ตรงนี้มีกับดักคือสองฝั่ง deploy ไม่พร้อมกัน ตัวรับต้องเข้าใจทั้งของใหม่และของเก่าไปสักพัก
# ตัวอ่าน: ส่งค่าดิบเป็นฟิลด์ แทนที่จะส่ง regs ทั้งก้อน
REG_MAP = {"comp": 8, "cond": 9, "evap": 10, "heat": 11, "freq": 24}

def row_from_frame(ts: int, slave: int, regs: list[int]) -> dict:
    row = {"ts_unix": ts, "slave": slave}
    for col, idx in REG_MAP.items():
        row[col] = regs[idx] if idx < len(regs) else None
    return row
// ตัวรับฝั่งเซิร์ฟเวอร์: รองรับทั้ง payload ใหม่และ payload เก่าที่ยังส่ง regs มา
$cols = ['comp' => 8, 'cond' => 9, 'evap' => 10, 'heat' => 11, 'freq' => 24];
$row  = ['ts_unix' => (int) $in['ts_unix'], 'slave' => (int) $in['slave']];

foreach ($cols as $col => $idx) {
    if (array_key_exists($col, $in)) {
        $row[$col] = is_numeric($in[$col]) ? (int) $in[$col] : null;   // payload ใหม่
    } elseif (isset($in['regs'][$idx])) {
        $row[$col] = (int) $in['regs'][$idx];                          // legacy
    } else {
        $row[$col] = null;
    }
}
สคริปต์ช่วยงานที่เขียนไว้ตอน debug ทั้งชุด ตัววิเคราะห์ ตัวเทียบค่า ตัวดูสดรายวินาที ทุกตัวอ่าน regs ทั้งนั้น พอ DROP คอลัมน์ไปมันพังหมดในคราวเดียวโดยไม่มีใครรู้ เพราะไม่มีใครรันมันทุกวัน สิ่งที่ควรทำก่อนแก้ schema คือลิสต์ผู้บริโภคของ schema ให้ครบก่อน ไม่ใช่แค่หน้าเว็บกับ API แต่รวมสคริปต์ cron สคริปต์แจ้งเตือน ตัวเช็คสุขภาพ และเครื่องมือมือที่รันปีละครั้ง grep หาชื่อคอลัมน์เก่าทั้ง repo ใช้เวลาห้านาที ถูกกว่ามานั่งงมทีหลังมาก
# ลิสต์ผู้บริโภคของ schema ก่อนแตะอะไร — ห้ามข้ามขั้นนี้
grep -rn --include='*.py' --include='*.php' --include='*.js' --include='*.sh' \
     -e 'regs' -e 'JSON_EXTRACT' -e 'raw_dump' /opt/app | sort -u
ผลลัพธ์ที่วัดได้ กับชั้น cache ที่ต้องมีคู่กัน
ที่ต้องพูดให้ชัดคือ ตัวเลข 5 วินาทีเหลือ 0.7 วินาทีนั้นไม่ได้มาจากการเปลี่ยน schema อย่างเดียวครับ มันมาจากการทำตาราง cache รายวันเพิ่มด้วย คือสรุปยอดรายวันไว้ล่วงหน้าแล้วให้หน้ารายเดือนอ่านจากตารางนั้นแทนการไล่คำนวณจากแถวดิบทุกครั้ง การเปลี่ยน schema ทำให้ตัวสรุปรายวันทำงานเร็วขึ้นมาก และทำให้เขียน SQL สรุปได้ตรงไปตรงมาโดยไม่ต้องมี JSON_EXTRACT
-- ตาราง cache รายวัน: สรุปไว้ล่วงหน้า หน้ารายเดือนอ่านจากตรงนี้
CREATE TABLE energy_day (
  d_epoch   INT     NOT NULL,  -- day-epoch ตามเวลาไทย
  slave     TINYINT NOT NULL,
  kwh_peak  DECIMAL(12,4) NOT NULL DEFAULT 0,
  kwh_off   DECIMAL(12,4) NOT NULL DEFAULT 0,
  PRIMARY KEY (d_epoch, slave)
) ENGINE=InnoDB;
ส่วน retention ผมตั้งไว้ว่าเก็บแถวดิบสามวันพอ ก่อนลบต้องยิง backfill ตาราง cache ให้เรียบร้อยก่อนเสมอ ลำดับนี้ผิดไม่ได้
# retention: backfill cache ให้ครบ แล้วค่อยลบแถวดิบ — ลำดับสำคัญมาก
curl -fsS "http://127.0.0.1/internal/api?q=energy&days=7" >/dev/null || exit 1
mariadb edge_db -e "DELETE FROM raw_dump WHERE ts_unix < UNIX_TIMESTAMP() - 3*86400;"
mariadb edge_db -e "SELECT COUNT(*) FROM raw_dump;"
ขั้นตอนย่อสำหรับคนที่จะทำตาม
- วัดขนาดจริงจาก information_schema ก่อน อย่าเดาจากความรู้สึกว่าตารางใหญ่หรือไม่ใหญ่
- นับ distinct รายช่องเพื่อหาว่าอะไรเป็นข้อมูลจริง อะไรเป็นช่องตายที่ไม่เคยขยับ
- ตัดสินใจให้ชัดว่าจะเก็บค่าดิบหรือค่าที่แปลงแล้ว ผมแนะนำค่าดิบ แล้วย้ายการตีความไปไว้ที่ API
- grep หาผู้บริโภคของ schema ให้ครบทั้ง repo รวมสคริปต์ cron และเครื่องมือ debug ที่นาน ๆ ใช้ที
- สร้างตารางใหม่ backfill ทีละวัน แล้ว RENAME สลับแบบ atomic เก็บของเก่าไว้อีกสามวัน
- ให้ API ประกอบรูปแบบเดิมคืนให้ client เพื่อให้ย้ายหลังบ้านได้โดยไม่ต้องแตะหน้าเว็บพร้อมกัน
- ทำ cache ชั้นสรุปคู่ไปด้วย แล้วค่อยตั้ง retention ลบแถวดิบ โดยยิง backfill ก่อนลบทุกครั้ง
ที่อยากฝากไว้คือข้อสาม ตอนเริ่มโปรเจกต์การเก็บทุกอย่างไว้ก่อนเป็นการตัดสินใจที่ถูกนะครับ เพราะตอนนั้นเรายังไม่รู้อะไรเลย ที่ผิดคือการปล่อยให้มันเก็บทุกอย่างต่อไปหลังจากที่รู้แล้วว่าใช้อะไรบ้าง ส่วนตัวผมตั้งไว้เลยว่าพอระบบเก็บข้อมูลเดินครบหนึ่งเดือนเมื่อไหร่ ต้องกลับมานั่งดูรอบหนึ่งว่าที่เก็บอยู่กับที่ใช้จริงมันห่างกันแค่ไหน ใครทำระบบแนวนี้อยู่แล้วมีวิธีอื่นที่ดีกว่าเอามาเล่าให้ฟังได้ ผมอยากรู้เหมือนกันว่ามีใครใช้ฐานข้อมูลสาย time-series โดยเฉพาะแล้วคุ้มกว่าไหม ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย