charset ไม่ตรง ทำ index ตายเงียบ ตอน JOIN ข้ามฐาน — mirror utf8mb4

index ยังอยู่ครบทุกตัว SHOW INDEX ก็เห็น แต่ไม่มีตัวไหนถูกใช้เลย เพราะสองฐานที่คุยกันอยู่พูดกันคนละ charset และ MariaDB ไม่เตือนอะไรสักคำ
พอดีระบบงานลูกค้าที่ผมดูแลมีฐานเก่าที่ยังเป็น tis620 ทั้งฐาน ส่วนแอปใหม่ที่เขียนขึ้นมาใช้ utf8mb4 พอต้องดึงข้อมูลมารวมกันด้วยการ JOIN ข้าม database ผลคือหน้าเว็บช้าผิดปกติทั้งที่คอลัมน์ที่ join มี index ครบทั้งสองฝั่ง ไม่มี error ไม่มี warning อะไรออกมาเลยสักบรรทัด กว่าจะรู้ว่าเป็นเรื่อง charset ก็เสียเวลาไปหลายวัน ผมเลยเขียนเก็บไว้ทั้งวิธีพิสูจน์และวิธีแก้แบบที่ใช้อยู่จริงตอนนี้
ชื่อฐานข้อมูลและชื่อตารางในบทความเป็นชื่อสมมติ ส่วนคำสั่ง สคริปต์ และตัวเลข benchmark คือของจริง
อาการ: JOIN ช้า ทั้งที่ index ครบ
เริ่มจากดูก่อนว่าฝั่งไหนยังไม่ใช่ utf8mb4 บ้าง คำสั่งนี้ตอบได้ทั้งฐานภายในวินาทีเดียว
-- คอลัมน์ไหนในฐาน mirror ที่ยังไม่ใช่ utf8mb4
SELECT TABLE_SCHEMA, TABLE_NAME, COLUMN_NAME, CHARACTER_SET_NAME, COLLATION_NAME
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA IN ('mirror_db','mirror_db2','app_db')
  AND CHARACTER_SET_NAME IS NOT NULL
  AND CHARACTER_SET_NAME <> 'utf8mb4'
ORDER BY TABLE_SCHEMA, TABLE_NAME;
ดูระดับ database ด้วยอีกที เพราะบางทีตารางถูกแปลงแล้วแต่ค่า default ของฐานยังเป็นของเก่า ตารางที่สร้างใหม่ก็จะกลับไปเป็น tis620 อีก
-- charset ระดับ database
SELECT SCHEMA_NAME, DEFAULT_CHARACTER_SET_NAME, DEFAULT_COLLATION_NAME
FROM information_schema.SCHEMATA;
ตัวชี้ขาดคือ EXPLAIN ครับ ก่อนแปลง query ที่ join ข้าม charset จะขึ้น type=ALL และ key=NULL คือ full scan ทั้งตาราง ทั้งที่คอลัมน์ ref_no มี index อยู่ชัด ๆ
-- ก่อนแปลง: join ข้าม charset -> type=ALL, key=NULL, rows=ทั้งตาราง
EXPLAIN
SELECT c.ref_no, r.amount
FROM app_db.job_register c
JOIN mirror_db2.submit_log r ON r.ref_no = c.ref_no
WHERE c.doc_date BETWEEN '2025-10-01' AND '2025-10-31';
ถ้าอยาก isolate ให้ชัดว่าเป็นเรื่อง collation จริง ลองบังคับ collation ให้ตรงที่ฝั่งค่าคงที่ดู แล้วดูว่า plan เปลี่ยนไหม
-- ทดสอบเปรียบเทียบแบบ isolate: บังคับ collation ให้ตรง แล้วดูว่า plan เปลี่ยนไหม
EXPLAIN
SELECT * FROM mirror_db2.submit_log
WHERE ref_no = CONVERT('680000002' USING utf8mb4) COLLATE utf8mb4_unicode_ci;
บางเคสโชคดีกว่านั้น คือได้ error ออกมาตรง ๆ เลยว่า Illegal mix of collations (tis620_thai_ci,IMPLICIT) and (utf8mb4_unicode_ci,IMPLICIT) for operation '=' อันนี้ผมถือว่าโชคดีนะครับ เพราะอย่างน้อยมันบอกเรา ที่อันตรายกว่าคือแบบที่ไม่บอกอะไรเลย แค่ช้าลงร้อยเท่าเงียบ ๆ
กลไก: ทำไม charset ไม่ตรงถึงฆ่า index ได้
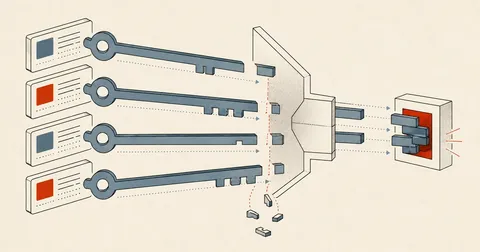
อธิบายเป็นคำพูดคือ เวลา MariaDB เทียบสองค่าที่ charset หรือ collation ต่างกัน มันจะ coerce ฝั่งที่ priority ต่ำกว่าให้เป็นอีกฝั่งตามกฎ collation coercibility ปัญหาอยู่ตรงที่ถ้าฝั่งที่ถูกแปลงคือคอลัมน์ ไม่ใช่ค่าคงที่ ทุกแถวต้องถูกอ่านขึ้นมาแปลงก่อนเทียบ ซึ่งเท่ากับเราเอาฟังก์ชันไปครอบคอลัมน์นั้นเอง index บนคอลัมน์นั้นเลยใช้ไม่ได้ทันที
index ยังอยู่ครบ SHOW INDEX ก็เห็น แต่ optimizer เลือกไม่ใช้ ไม่มี warning ไม่มี error อะไรเลย ระบบยังให้คำตอบถูกต้องทุกอย่าง แค่ช้าลง 100-1000 เท่า และจะเห็นผลก็ต่อเมื่อข้อมูลโตพอเท่านั้น ของผมจบลงด้วย full scan ยาว ๆ บนตาราง MyISAM จนลามเป็น ทั้งเว็บ 504 ทุกหน้า ซึ่งผมแยกไปเล่าอีกบทความหนึ่ง
ทางเลือกที่มี แล้วผมเลือกทางไหน
เร็วแต่เปราะ
ใส่ COLLATE ใน ON/WHERE ทีละจุด ทำได้เลยไม่ต้องแตะฐาน แต่ต้องไล่แก้ทุก query ที่มีอยู่และที่จะเขียนใหม่ ที่แย่กว่านั้นคือถ้าเผลอใส่ COLLATE ฝั่งคอลัมน์ที่มี index จะยิ่งฆ่า index ซ้ำเข้าไปอีก ต้องใส่ฝั่ง literal เท่านั้น
ช้ากว่าแต่จบ
ดึงข้อมูลจากต้นทางมาแปลงเป็น utf8mb4 เก็บไว้ในเครื่องเดียวกับแอป ไม่ต้องแตะฐาน production เลย แล้วทั้งระบบใหม่คุยกันด้วย charset เดียวตลอด ผมเลือกทางนี้
ทางที่สามคือแปลงฐานต้นทางเลย อันนั้นผมตัดทิ้งตั้งแต่แรกครับ เพราะเป็นฐาน production ของระบบเดิมที่มีคนใช้อยู่ ไปแตะแล้วมีอะไรผิดพลาดขึ้นมาคือกระทบงานจริงทันที ส่วนตัวผมถือเป็นกฎว่าอย่าไปแปลง charset ฐานที่ระบบอื่นยังใช้งานอยู่ ถ้ายังมีทางเลือกอื่น
หัวใจของการแปลง: ทำตอน dump ไม่ใช่ iconv ทีหลัง
mariadb-dump -h 10.0.0.21 -u<user> -p<password> \
  --single-transaction --no-tablespaces --skip-lock-tables \
  --default-character-set=utf8mb4 \
  --where="doc_date >= date_sub(curdate(), interval 4 year)" \
  mirror_db doc_head
ตัวเปลี่ยนเกมคือ --default-character-set=utf8mb4 ครับ มันบอก server ว่า connection นี้เป็น utf8mb4 แล้ว server จะ transcode ข้อมูล tis620 ให้เองตอนส่งออก ใช้ mapping ของ server เอง ถูกต้องกว่าและไม่ต้องมานั่งเดา encoding ทีหลังด้วย iconv
ส่วน flag อื่นที่ต้องมีคู่กัน --single-transaction ให้ snapshot ที่ consistent สำหรับ InnoDB, --skip-lock-tables จำเป็นมากเพราะต้นทางมีตาราง MyISAM ที่ --single-transaction ไม่ครอบ ถ้าไม่ใส่ dump จะไปล็อกฐาน production, --no-tablespaces ช่วยให้ไม่ต้องขอสิทธิ์ PROCESS บนต้นทาง และผมดึงจากเครื่อง slave ไม่ใช่ master เสมอ เพื่อไม่ให้ไปกินแรง production
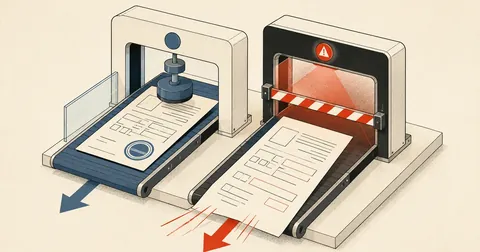
ข้อมูลที่ออกมาเป็น utf8mb4 แล้วก็จริง แต่บรรทัด CREATE TABLE ยังพิมพ์ว่า DEFAULT CHARSET=tis620 ตามของจริงในต้นทาง ถ้าโหลดเข้าไปตรง ๆ จะได้ตารางที่ประกาศว่าเป็น tis620 แต่ข้างในเป็น byte ของ utf8mb4 คือข้อมูลเพี้ยนทันที สองอย่างนี้ต้องทำคู่กันเสมอ transcode ตอน dump แล้ว rewrite schema ด้วย sed
sed แก้หัว SQL — ห้าบรรทัดที่ต้องครบ
# sed แก้ "หัว SQL" (CREATE TABLE) จาก tis620 -> utf8mb4 ; data เป็น utf8mb4 อยู่แล้วจาก dump ข้างบน
FIXCS='s/CHARSET=tis620/CHARSET=utf8mb4/g; s/CHARACTER SET tis620/CHARACTER SET utf8mb4/g; s/tis620_thai_ci/utf8mb4_unicode_ci/g; s/tis620_bin/utf8mb4_bin/g; s/ENGINE=InnoDB /ENGINE=InnoDB ROW_FORMAT=DYNAMIC /g'
ห้า rule นี้ทำคนละหน้าที่กันครับ อันแรกแก้ charset ระดับตาราง อันที่สองแก้ระดับคอลัมน์ ซึ่งเป็นข้อที่คนลืมบ่อยที่สุด บางคอลัมน์ override ตารางไว้ ถ้าลืมข้อนี้จะได้ตารางที่ประกาศว่า utf8mb4 แต่มี tis620 ซ่อนอยู่ระดับคอลัมน์ index ก็ยังตายอยู่ดี แถมหายากกว่าเดิม อันที่สามกับสี่แก้ collation ทั้งแบบ case-insensitive และ binary
ข้อห้าเป็นเรื่อง ROW_FORMAT=DYNAMIC ที่จำเป็นเพราะ tis620 ใช้ 1 ไบต์ต่อตัวอักษร ส่วน utf8mb4 ใช้สูงสุด 4 ไบต์ คอลัมน์ varchar(255) ที่เคยกินแค่ 255 ไบต์กลายเป็น 1,020 ไบต์ ขณะที่ index prefix limit ของ InnoDB แบบ COMPACT อยู่ที่ 767 ไบต์เท่านั้น ต้องเป็น DYNAMIC ถึงจะได้ 3,072 ไบต์ ไม่งั้นสร้าง index ไม่ผ่าน
ผมแนะนำให้เพิ่มอีกหนึ่ง rule ไปเลยตอนนี้ คือฆ่า MyISAM ทิ้งไปพร้อมกัน เพราะปัญหา charset กับปัญหา lock มันมาคู่กันเสมอ
FIXCS="$FIXCS"'; s/ENGINE=MyISAM/ENGINE=InnoDB ROW_FORMAT=DYNAMIC/g'
กับดักตัวเอ้: sed เปลี่ยนชื่อตารางต้องมี keyword นำหน้า
ตอนทำ staging table ผมต้องเปลี่ยนชื่อตารางในไฟล์ dump จาก doc_head เป็น doc_head__new ก่อนโหลดเข้า วิธีที่ถูกคือ anchor ด้วย keyword แล้วอ้าง backreference
# ถูก: anchor ด้วย keyword แล้วอ้าง backreference \1
sed -E "s/(DROP TABLE IF EXISTS|CREATE TABLE|INSERT INTO|ALTER TABLE|LOCK TABLES) \`$t\`/\1 \`${t}__new\`/g"
# ผิด (เวอร์ชันแรกที่ทำพัง): แทนทุก `ชื่อตาราง` ที่เจอ
sed -E "s/\`$t\`/\`${t}__new\`/g"
ในฐานเก่ามีตารางที่คอลัมน์ชื่อเดียวกับตารางอยู่หลายตัว เช่นตาราง type_ref มีคอลัมน์ชื่อ type_ref และตาราง amount ก็มีคอลัมน์ชื่อ amount พอ sed แบบไม่ anchor มันจะไปเปลี่ยนชื่อคอลัมน์ใน CREATE TABLE และในรายการคอลัมน์ของ INSERT INTO ด้วย ผลคือได้ staging table ที่คอลัมน์ชื่อเพี้ยน หรือ SQL error กลางทาง แล้ว rename ทับตารางดีไปเรียบร้อย อันนี้เสียเวลาผมมากที่สุดในงานนี้
ทำให้เป็น pipeline จริง
โครงสคริปต์ที่ใช้อยู่หน้าตาประมาณนี้ครับ มีสองโหมดหลัก คือ reload ที่แปลงทั้งโครงสร้าง กับ upsert ที่ดึงเฉพาะแถวใหม่
mirror.sh <mode>
  |- flock /tmp/app-mirror.lock          กัน cron รอบซ้อน (exit 75 ถ้าซ้อน)
  |- SRC / DUMPOPT / FIXCS               config ด้านบนสุด
  |- table_exists()                      guard ก่อน rename
  |- reload(db, table, [where])          dump -> sed rename -> sed charset -> load -> RENAME swap
  |- upsert(db, table, where)            dump --no-create-info --replace (ไม่ drop ตาราง)
  |- กลุ่มตารางตามงาน
  `- case $MODE: full | daily | hourly
ตัว upsert() ใช้กับตารางใหญ่ที่ reload เต็มไม่ไหว ดึงย้อนหลังแค่ 14-30 วัน
# upsert เฉพาะแถวล่าสุด (ไม่ drop) — REPLACE INTO ตารางเดิม
upsert(){ # db table where
  db=$1; t=$2; where=$3
  mariadb-dump $SRC --no-create-info --replace --skip-lock-tables --default-character-set=utf8mb4 --where="$where" "$db" "$t" 2>>"$LOG" \
    | mariadb "$db" 2>>"$LOG" \
    && echo "$(ts) upsert OK   $db.$t ($where)" >>"$LOG" || echo "$(ts) upsert FAIL $db.$t" >>"$LOG"
}
เพราะ --no-create-info แปลว่าไม่มี CREATE TABLE ออกมาให้ sed แก้เลย ตารางไหนที่ sync ด้วย upsert อย่างเดียวจะค้างเป็น tis620 ตลอดกาล มันจะแปลงก็ต่อเมื่อโดน reload รอบ hourly/daily/full เท่านั้น ตอนตรวจงานต้องไล่ดูเป็นรายตารางว่าตัวไหนเคยผ่าน reload แล้วบ้าง
guard สองตัวที่ต้องมาคู่กันเสมอ คือเช็คว่า staging table เกิดจริงก่อน rename กับ flock กันรอบซ้อน
table_exists(){ # db table
  mariadb "$1" -N -e "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema=DATABASE() AND table_name='$2'" 2>>"$LOG"
}
ฝั่งแอปต้อง utf8mb4 ตั้งแต่เกิด
// config/database.php ของ Laravel
'charset'   => 'utf8mb4',
'collation' => 'utf8mb4_unicode_ci',
ถ้าเผลอสร้างฐานหรือตารางเป็น latin1 ไปแล้ว จะ insert ภาษาไทยไม่เข้า เจอ error 1366 Incorrect string value แก้ย้อนหลังได้ด้วยสองคำสั่งนี้
-- ถ้าเผลอสร้างเป็น latin1 มาแล้ว
ALTER DATABASE `app_db` CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
ALTER TABLE `app_db`.`job_register` CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
อีกเรื่องที่โผล่มาหลังย้ายมา utf8mb4 คือ substr() ของ PHP ครับ มันตัดกลางตัวอักษรไทยแล้วแสดงผลเป็นเครื่องหมายคำถาม ต้องไล่เปลี่ยนเป็น mb_substr() ให้หมดทุกที่ อันนี้ผมโดนหลังบ้านหลายจุดกว่าจะครบ
วัดผลหลังแปลง
ตัวเลข 55 ms เทียบกับ 772 ms มาจากการย้ายสูตรที่เคยคำนวณสด ๆ ใน WHERE ไปเก็บเป็นคอลัมน์แล้วทำ index ทับ ได้ผลลัพธ์เท่ากันเป๊ะ 23,076 แถว แต่เร็วขึ้นราว 14 เท่า
-- ตัวอย่างการเพิ่ม index บนคอลัมน์ที่คำนวณไว้ล่วงหน้า แทนการคิดสูตรใน WHERE ตอน query
ALTER TABLE expected_lines
  ADD COLUMN expected_diff_amount DECIMAL(14,2) NULL,
  ADD INDEX el_paidst_amount_case_idx (paid_status, amount_group, case_key),
  ADD INDEX el_paidst_expdiff_case_idx (paid_status, expected_diff_amount, case_key);
ตรวจงานตอนจบด้วยสองคำสั่งนี้ ตัวแรกต้องได้เลข 0 เท่านั้น ตัวที่สองไว้ดูว่า reload ครบทุกตารางไหม
# นับตารางที่ยังไม่ utf8mb4 — ต้องได้ 0
mariadb -N -e "
SELECT COUNT(*) FROM information_schema.TABLES
WHERE TABLE_SCHEMA IN ('mirror_db','mirror_db2')
  AND TABLE_COLLATION NOT LIKE 'utf8mb4%';"

grep -c 'reload OK'   /var/www/app/storage/logs/mirror.log
grep    'reload FAIL' /var/www/app/storage/logs/mirror.log
แล้วสุ่มเช็คภาษาไทยด้วยตาอีกรอบ ดู HEX ประกอบจะชัวร์กว่าดูตัวอักษรอย่างเดียว เพราะบางที mojibake มันเนียนมาก
-- สุ่มเช็คภาษาไทยว่าไม่เพี้ยน (mojibake) หลัง transcode
SELECT name, HEX(LEFT(name,3)) FROM mirror_db.type_ref LIMIT 5;
ขั้นตอนย่อสำหรับคนที่จะเริ่มทำ
- สำรวจก่อนว่าคอลัมน์ไหนยังไม่ utf8mb4 ด้วย information_schema.COLUMNS แล้วเก็บรายการไว้เทียบตอนจบ
- ยืนยันอาการด้วย EXPLAIN ให้เห็น type=ALL ก่อน จะได้รู้ว่าแก้แล้วดีขึ้นจริง
- ตั้ง mirror ดึงจาก slave ด้วย mariadb-dump พร้อม --default-character-set=utf8mb4 และ --skip-lock-tables
- ใส่ sed FIXCS ให้ครบทั้งห้า rule บวก rule ฆ่า MyISAM แล้วอย่าลืม anchor keyword ตอน rename ตาราง
- โหลดเข้า staging table แล้วค่อย RENAME swap โดยมี table_exists guard และ flock กันรอบซ้อน
- เติม index บนคีย์ที่ join จริง แล้ว EXPLAIN ซ้ำให้ได้ ref หรือ eq_ref ไม่ใช่ ALL
- ตั้ง freshness check เทียบ max(date) กับวันนี้ เพราะถ้า slave หยุด replicate mirror จะยังทำงานปกติแต่ข้อมูลค้าง
ข้อสุดท้ายผมเจ็บมาแล้วครับ mirror นิ่งแบบเงียบ ๆ คือ cron ยังเขียน reload OK ทุกชั่วโมง log สวยงามมาก แต่ข้อมูลค้างอยู่ที่เมื่อวานเพราะต้นทางหยุด replicate ไปแล้ว ตอนนี้ผมเลยเพิ่ม cron แยกเช็ค Slave_IO_Running กับ Seconds_Behind_Master โดยตั้ง threshold ไว้ที่ 1,800 วินาที เกินแล้วเด้งแถบเตือนสีแดงบนหัวเว็บให้คนเห็นเลย
ใครกำลังเจอฐานเก่า tis620 ที่ต้องอยู่ร่วมกับระบบใหม่ ผมว่าโครงนี้เอาไปปรับใช้ได้เลย เปลี่ยนแค่ชื่อฐานกับรายชื่อตาราง ส่วนใครมีวิธีที่ดีกว่านี้โดยไม่ต้องทำ mirror ก็เอามาเล่าให้ฟังได้ ผมอยากรู้เหมือนกันว่ามีทางไหนที่จบกว่านี้ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย