#systemd

ระบบเฝ้าระวังที่ยิงถี่เกิน จนล้มอุปกรณ์ทั้งฟาร์มเอง
ลูปเฝ้าระวังทุก 30 วินาทีที่สั่งกู้อุปกรณ์ทุกตัวที่ ping ไม่ผ่าน ฟังดูเหมือนของดี จนวันที่อุปกรณ์ตัวเดียวค้างแล้วโดนกระแทกซ้ำจนล้มทั้งบัส บทความนี้ไล่ตั้งแต่ตัดสมมติฐานฮาร์ดแวร์ ทำตัวจับว่าใครแตะอุปกรณ์บ้าง ไปจนถึงค่าที่แก้แล้วหาย
บริการยังรันอยู่ แต่ตายไปแล้ว — systemd restart ช่วยไม่ได้
เน็ตหลุดยาว DNS ใช้ไม่ได้ เดมอนที่ถือ session กับ API ภายนอกวนล็อกอินไม่สำเร็จ 194 รอบ แล้วค้างกลางขั้นตอน ไม่ exit ระบบเลยไม่ restart ให้ — ว่าด้วยการเลิกวัดว่า process ยังอยู่ไหม แล้วหันมาวัดความสดของข้อมูลแทน
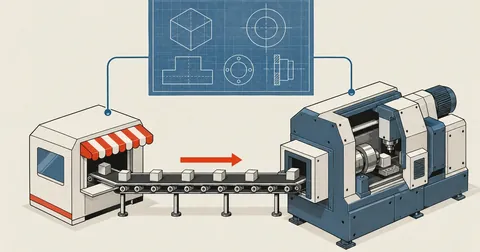
โค้ดชุดเดียวสองบทบาท เว็บอยู่โฮสต์ worker อยู่เครื่องที่บ้าน
ระบบทั้งตัวเคยวิ่งอยู่บนเครื่องเดียวหลังเน็ตบ้าน เครื่องดับทีเดียวทีมใช้อะไรไม่ได้เลย ผมเลยแยกเป็นสองบทบาทด้วยโค้ดชุดเดิม — เว็บอยู่โฮสต์ที่เปิดตลอด งานหนักอยู่เครื่องที่บ้านแล้ววิ่งมาดึงงานเอง พร้อมตาราง claim แบบ atomic และแผนสลับ 18 ขั้นที่มีทางถอย
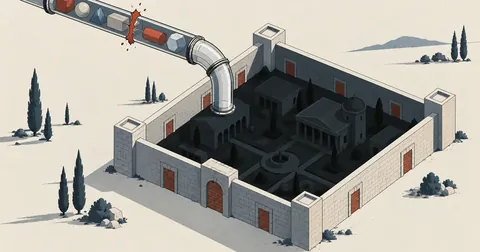
อุโมงค์เส้นเดียวคือทางเข้าเดียว และเป็นจุดตายเดียวด้วย
เครื่องทำงานอยู่หลัง NAT ไม่มีพอร์ตเปิดจากอินเทอร์เน็ตเลยสักพอร์ต ทุกทางเข้าวิ่งผ่าน cloudflared เส้นเดียว — ทั้งเว็บ ทั้ง SSH ทั้งรีโมตเดสก์ท็อป บทความนี้เล่า ingress ทั้งสี่เส้นที่ผมวางไว้ วิธีอ่านสัญญาณตอนมันล่ม และกับดักที่ทำให้อุโมงค์ไม่ขึ้นตอนบูต
แยกลิงก์พังออกจาก ISP ล่ม ก่อนสั่งรีสตาร์ตอะไรบนเครื่อง
watchdog ที่เขียนกันทั่วไปคือ ping ไม่ผ่านแล้ว restart NetworkManager ซึ่งผิดครึ่งหนึ่งของเวลา เพราะเน็ตไม่ออกอาจแปลว่า ISP ล่ม ไม่ใช่การ์ดพัง บทความนี้แยกสามสถานะออกจากกันด้วย nmcli แล้วไต่บันไดจากเบาไปหนักถึงขั้น PCI remove และ rescan โดยไม่รีบูตเครื่อง
มี backup ครบทุกไฟล์ แต่สร้างเครื่องใหม่ไม่ได้
dump ฐานข้อมูลครบ tar โค้ดครบ ไฟล์ความลับครบ แต่พอเอาไปวางบนเครื่องเปล่าแล้วเว็บไม่ขึ้น เพราะของที่ทำให้เครื่องทำงานได้จริงไม่เคยอยู่ในไฟล์ backup เลย บทความนี้คือรายการของที่หายไปกับเครื่อง และลำดับกู้ที่ผมเขียนไว้ให้ตัวเองในอนาคต
คิวงาน Laravel บน shared host — อย่าเอาคิวไว้ Redis ตัวเดียวกับ cache
จะเปิด queue ให้ Laravel บน shared host แล้วคิดจะแยก REDIS_DB ให้คิวอยู่คนละเบอร์กับ cache — ไม่ช่วยครับ เพราะ maxmemory กับ eviction เป็นของทั้ง instance ไม่ใช่ของราย DB บทความนี้เล่าเหตุผลที่ผมเลือก database driver แทน พร้อม systemd unit เต็ม ๆ ที่ใช้แทน Supervisor
Redis แยกต่อ user บน shared hosting — และบั๊ก maxmemory ที่ทำเว็บค้าง
ออกแบบ Redis หนึ่ง instance ต่อหนึ่ง user บน shared hosting ด้วย systemd template + cgroup — และบทเรียนบั๊ก maxmemory ที่ตั้งเกินเพดาน cgroup แล้วทำเว็บ WooCommerce ค้างเป็นพักๆ พร้อมกฎ 80% และ guard script กันเกิดซ้ำ