user 9 รายไม่เคยถูก backup เลย เพราะรายชื่อใน cron ไม่เคยถูกแก้
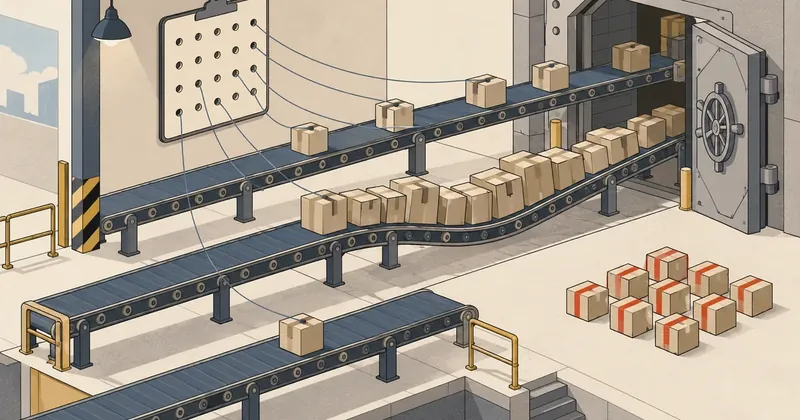
ระบบ backup ที่รันสำเร็จทุกคืนตอบได้แค่ว่างานที่สั่งไว้ทำเสร็จ มันไม่ได้ตอบว่าสิ่งที่สั่งไว้ยังตรงกับของที่มีอยู่บนเครื่องหรือเปล่า และรายชื่อที่เขียนไว้เมื่อสี่เดือนก่อนไม่มีทางรู้จัก user ที่เพิ่งเกิดเมื่อเดือนที่แล้ว
สรุปใน 1 นาที
- อาการ/ปัญหา
- user 9 รายไม่เคยถูก backup เพราะรายชื่อใน cron ไม่เคยถูกแก้ ทั้งที่ health check ผ่านตลอด
- ใครควรอ่าน
- คนดูแล DirectAdmin ที่ตั้ง backup cron เป็นรายชื่อ user
- ทางแก้แบบสั้น
- เขียนสคริปต์ audit เทียบ user จริงกับ select ใน backup_crons.list จัดกลุ่มใหม่แบบ greedy และเสนอตัวตรวจ user กำพร้ารายวัน
พอดีเจ้าของเครื่องถามผมมาประโยคเดียวว่า ตอนแรกให้เฉลี่ยกลุ่ม backup ไว้ แต่ตอนนี้มีโดเมนเพิ่มขึ้น list น่าจะเปลี่ยนไปแล้ว ผมเลยทำ audit แบบอ่านอย่างเดียวบนเครื่อง DirectAdmin ตัวนั้น ตั้งใจจะดูแค่ว่ากลุ่มยังสมดุลอยู่ไหม แต่ผลที่ได้หนักกว่าที่คิด มี user 9 รายที่ไม่อยู่ใน cron ตัวไหนเลย แปลว่าตั้งแต่สร้างมายังไม่เคยถูก backup สักครั้ง ในนั้นมีระบบ billing ตัวใหม่กับเว็บ production ที่เพิ่งทำเสร็จรวมอยู่ด้วย
ชื่อ user ชื่อโฮสต์ และ path ในบทความนี้เปลี่ยนเป็นค่าตัวอย่างทั้งหมด ตัวเลขขนาด จำนวน user และโครงสร้างไฟล์เป็นของจริง
ระบบที่ออกแบบไว้ กับคำถามที่ไม่มีใครถามมาสี่เดือน
Admin Backup ของ DirectAdmin บนเครื่องนี้เขียน tarball ราย user (.tar.zst) ลง NFS ของโฮสต์สำรอง แยกโฟลเดอร์ตามชื่อวัน ตอนย้ายเครื่องผมออกแบบไว้ว่าแบ่ง user เป็น 3 กลุ่มขนาดใกล้กัน รันวันจันทร์ พุธ ศุกร์ ตอน 01:00 เว้นวันอาทิตย์ไว้ให้ snapshot ทั้ง VM และยังมี cron เก่าอีกตัวที่ยิงวันอังคาร พฤหัส เสาร์ ค้างอยู่จากระบบเดิม วิธีวางโครงนี้ผมเขียนไว้แล้วใน วางระบบ Backup DirectAdmin ใหม่ด้วย NFS และ POSIX ACL
รายชื่อ user ของแต่ละกลุ่มไม่ได้อยู่ใน crontab ของ root แต่อยู่ในไฟล์ของ DA เอง
ls -l --time-style=long-iso /usr/local/directadmin/data/admin/backup_crons.list
# -rw------- 1 diradmin diradmin ... 05-21 ... backup_crons.list
เจ้าของต้องเป็น diradmin สิทธิ์ต้องเป็น 600 แต่ละบรรทัดคือ cron หนึ่งตัว หน้าตาเป็น <id>=action=backup&hour=1&minute=0&dayofweek=1&...&select0=userA&select1=userB... แบบ URL-encoded โดย dayofweek 1 คือจันทร์ไล่ไปถึง 6 คือเสาร์ รายละเอียดการเขียนไฟล์นี้อยู่ใน ตั้ง DirectAdmin Admin Backup cron จาก CLI รอบนี้ผมสนใจเรื่องเดียวคือบรรทัดวันที่ ไฟล์ถูกแก้ครั้งสุดท้ายวันที่ 21 พฤษภาคม แล้วไม่เคยถูกแตะอีกเลยเกือบ 4 เดือน ทั้งที่ช่วงนั้นมี user เกิดใหม่เรื่อย ๆ
health check ที่มีอยู่บนเครื่องนี้ตรวจสองอย่างคือ backup รันไหม กับ ACL ของปลายทางยังเขียนได้ไหม ทั้งสองข้อผ่านทุกวันตลอดสี่เดือน เพราะ cron ทำงานกับรายชื่อที่มันมีอยู่ได้ครบถ้วนจริง ไม่มีข้อไหนถามว่า user ทุกรายบนเครื่องอยู่ในรายชื่อหรือยัง
สคริปต์ audit: เทียบ user จริงกับ select ในทุก cron
ผมเขียนสคริปต์ Python สั้น ๆ อ่านอย่างเดียว ทำสามอย่าง แกะทุกบรรทัดของ backup_crons.list เอาค่า selectN ออกมา เทียบกับรายชื่อ user จริงของ DA ทุก reseller แล้วติดขนาด home ของแต่ละรายเข้าไป
#!/usr/bin/env python3
# /root/audit_backup_cover.py -- อ่านอย่างเดียว ไม่แก้ไฟล์ใด
import os, re, subprocess, sys
from urllib.parse import parse_qsl

CRONS = '/usr/local/directadmin/data/admin/backup_crons.list'
USERS = '/usr/local/directadmin/data/users'      # หนึ่งโฟลเดอร์ต่อหนึ่ง user ทุก reseller

def cron_groups():
    groups = {}
    with open(CRONS, encoding='utf-8') as f:
        for line in f:
            line = line.strip()
            if '=' not in line:
                continue
            cid, qs = line.split('=', 1)
            kv = parse_qsl(qs, keep_blank_values=True)      # ถอด URL-encode ให้เสร็จ
            dow = dict(kv).get('dayofweek', '*')
            runs = 7 if dow == '*' else len(dow.split(','))  # จำนวนรอบต่อสัปดาห์
            sel = [v for k, v in kv if re.fullmatch(r'select\d+', k)]
            groups[cid] = {'dow': dow, 'runs': runs, 'users': sel}
    return groups

def home_gb(user):
    r = subprocess.run(['du', '-sb', f'/home/{user}'], capture_output=True, text=True)
    return int(r.stdout.split()[0]) / 1e9 if r.stdout else 0.0

real = sorted(os.listdir(USERS))
size = {u: home_gb(u) for u in real}
groups = cron_groups()

covered, weekly = {}, 0.0
for cid, g in groups.items():
    gb = sum(size.get(u, 0.0) for u in g['users'])
    weekly += gb * g['runs']
    print(f"cron {cid}: dow={g['dow']:<6} users={len(g['users']):>3} {gb:7.1f} GB/รอบ")
    for u in g['users']:
        covered[u] = covered.get(u, 0) + g['runs']

orphans = [u for u in real if u not in covered]
print(f"\nuser จริง {len(real)} ราย ข้อมูล {sum(size.values()):.1f} GB ส่งต่อสัปดาห์ {weekly:.1f} GB")
print(f"ไม่อยู่ใน cron ใดเลย {len(orphans)} ราย รวม {sum(size[u] for u in orphans):.2f} GB")
for u in orphans:
    print(f"   [ORPHAN] {u:<12} {size[u]:6.2f} GB")
print("ถูก backup มากกว่า 1 รอบต่อสัปดาห์:",
      sum(1 for n in covered.values() if n > 1), "ราย")
sys.exit(1 if orphans else 0)
สคริปต์นี้มีบทเรียนของมันเองด้วยครับ รอบแรกผมอัปมันขึ้นไปวางที่ /tmp ของเครื่อง เจ้าของสั่งให้ย้ายทันที เพราะเครื่องนี้เป็น shared host /tmp เป็นที่ที่ user คนอื่นบนเครื่องมองเห็นได้ และผลลัพธ์ของสคริปต์คือรายชื่อ user ทั้งเครื่องพร้อมขนาด ผมเลยย้ายไปไว้ใต้ /root แล้วตั้งสิทธิ์ 700
install -m 700 -o root -g root audit_backup_cover.py /root/audit_backup_cover.py
rm -f /tmp/audit_backup_cover.py
/root/audit_backup_cover.py | tee /root/backup-cover.log && chmod 600 /root/backup-cover.log
ผลที่ได้: สามเรื่องในไฟล์เดียว
เรื่องแรกคือ user กำพร้า 9 ราย รวม 1.91 GB ทุกรายถูกสร้างหลังวันที่ 21 พฤษภาคม ซึ่งเป็นวันที่ไฟล์ถูกแก้ครั้งสุดท้ายพอดี ขนาดรวมไม่ถึง 2 GB เลยไม่มีทางสังเกตจากพื้นที่ปลายทางได้ แต่ของที่อยู่ในนั้นคือระบบ billing ตัวใหม่กับเว็บ production ถ้าเครื่องล่มในช่วงสี่เดือนนั้น ของกลุ่มนี้ไม่มีสำเนาที่ไหนเลย
เรื่องที่สองคือกลุ่มไม่สมดุลแล้ว ตอนออกแบบสามกลุ่มขนาดใกล้กัน แต่เว็บโตไม่เท่ากัน ตอนตรวจได้แบบนี้
| cron | จำนวน user | ขนาดต่อรอบ | รอบต่อสัปดาห์ |
|---|---|---|---|
| จันทร์ | 26 | 126.8 GB | 1 |
| พุธ | 23 | 70.8 GB | 1 |
| ศุกร์ | 22 | 64.0 GB | 1 |
| cron เก่า อังคาร พฤหัส เสาร์ | 42 | 165.3 GB | 3 |
เรื่องที่สามคือความซ้ำซ้อน user จำนวนมากอยู่ทั้งในกลุ่มวันของตัวเองและใน cron เก่า บางรายเลยถูก backup ถึง 5 ครั้งต่อสัปดาห์ ข้อมูลจริงบนเครื่องมี 205.7 GB แต่ปริมาณที่ถูกส่งข้าม NFS ต่อสัปดาห์คือ 757.5 GB (126.8 + 70.8 + 64.0 บวกกับ 165.3 คูณ 3)
ภาพรวมเลยเป็นระบบที่ทำงานหนักเกินจำเป็นราว 3.7 เท่าเมื่อเทียบกับข้อมูลจริง และไม่ทำงานเลยกับ user 9 รายที่ใหม่ที่สุด ซึ่งสองอย่างนี้เกิดจากต้นเหตุเดียวกัน คือรายชื่อถูกเขียนครั้งเดียวแล้วไม่มีใครกลับมาดู
drift ทางเดียว: ลบแล้วถอดให้เอง สร้างแล้วไม่เพิ่มให้
ระหว่างทำงานนี้ผมเจอข้อเท็จจริงของ DA ที่อธิบายว่าทำไมไฟล์ถึงเพี้ยนไปทางเดียว ตอนที่มีการลบ user รายหนึ่งผ่าน DA (CMD_API_SELECT_USERS แบบ delete) ผมเตรียมสคริปต์ไว้ไล่ถอดชื่อนั้นออกจาก backup_crons.list แต่ยังไม่ทันได้รัน ไฟล์ก็สั้นลงไปเองแล้ว DA ถอดชื่อ user ที่ถูกลบออกจากทุก cron ให้เอง ตัวเลขความครอบคลุมกลับมาตรงกันที่ 76/76 โดยที่ผมไม่ต้องทำอะไร
แต่ขาสร้างไม่เป็นแบบนั้น ไม่ว่าจะสร้าง user ตรง ๆ ใน DA หรือให้ระบบบิลลิ่ง provision ให้ ก็ไม่มีขั้นตอนไหนเพิ่มชื่อเข้า cron ของ backup เลย และพอไล่ดูที่มาของ 9 รายนั้น 8 รายถูกสร้างตรงใน DA ข้ามระบบบิลลิ่งไป และไม่มีขั้นตอนไหนบังคับว่าสร้างแล้วต้องเพิ่มเข้า backup
ผลของความไม่สมมาตรนี้คือรายชื่อใน cron หดได้อย่างเดียว ไม่มีวันโตตามเครื่อง ยิ่งเวลาผ่านไป ช่องว่างระหว่าง user จริงกับ user ที่ถูก backup ก็มีแต่กว้างขึ้น และ user ที่ตกหล่นคือรายใหม่เสมอ ซึ่งมักเป็นงานที่เจ้าของกำลังให้ความสำคัญที่สุดในตอนนั้น
สิ่งที่ทำทันที และเรื่องสิทธิ์ไฟล์ที่เจอระหว่างทาง
เรื่องความครอบคลุมรอไม่ได้ ผมเลยแยกทำก่อนเรื่องจัดสมดุล คือเพิ่ม user กำพร้าทั้ง 9 ราย กับบัญชีลูกค้าใหม่อีก 1 ราย เข้ากลุ่มวันศุกร์ซึ่งเบาที่สุด แล้วรัน audit ซ้ำ ได้ความครอบคลุม 77/77
L=/usr/local/directadmin/data/admin/backup_crons.list
B=/root/backup_crons.list.$(date +%F-%H%M)
cp -p "$L" "$B" && chmod 600 "$B"          # สำรองก่อนแก้ และห้ามให้ใครอ่านได้
stat -c '%a %U:%G %n' "$L" /root/backup_crons.list.*

# หลังแก้บรรทัดของกลุ่มวันศุกร์ (ต่อ selectN ท้ายบรรทัด ไล่เลขต่อจากตัวสุดท้าย)
chown diradmin:diradmin "$L" && chmod 600 "$L"
/root/audit_backup_cover.py | tail -5
ตรงคำสั่ง stat นี่แหละที่เจออีกเรื่อง ไฟล์สำรองตัวหนึ่งที่ทำไว้ก่อนหน้านี้มีสิทธิ์เป็น 644 แปลว่า user คนไหนบนเครื่องก็อ่านได้ และข้างในคือรายชื่อ user ทั้งเครื่อง ผมแก้เป็น 600 ทันที
cp โดยไม่ใส่ -p จะสร้างไฟล์ใหม่ตาม umask ของคนรัน ซึ่งมักได้ 644 ต้นฉบับเป็น 600 แต่สำเนาที่วางอยู่ข้างกันกลับเปิดอ่านได้ทั้งเครื่อง บน shared host เรื่องนี้รวมถึงสคริปต์ ผลลัพธ์ และ log ของงาน audit ด้วย ที่ที่ควรวางคือ /root ไม่ใช่ /tmp
จัดกลุ่มใหม่แบบ greedy กับราคาที่ต้องจ่าย
พอความครอบคลุมครบแล้วค่อยมาดูเรื่องสมดุล ผมใช้วิธีที่ง่ายที่สุดที่ให้ผลใช้ได้ คือ greedy bin-pack เรียง user จากใหญ่ไปเล็ก แล้วหยอดแต่ละรายลงกลุ่มที่เบาที่สุดในขณะนั้น
def pack(size, k=3):
    """size: {user: GB}  ->  k กลุ่มที่ขนาดรวมใกล้กันที่สุดเท่าที่วิธี greedy ทำได้"""
    bins = [{'gb': 0.0, 'users': []} for _ in range(k)]
    for user, gb in sorted(size.items(), key=lambda x: -x[1]):   # ใหญ่ไปเล็ก
        lightest = min(bins, key=lambda b: b['gb'])              # กลุ่มที่เบาที่สุดตอนนี้
        lightest['gb'] += gb
        lightest['users'].append(user)
    return bins

for i, b in enumerate(pack(size, 3), 1):
    print(f"กลุ่ม {i}: {len(b['users']):>3} users {b['gb']:6.1f} GB")
กับข้อมูลของเครื่องนี้ได้กลุ่มละประมาณ 68.6 GB ถ้าเลิก cron เก่าไปด้วย ปริมาณที่ส่งต่อสัปดาห์จะลดจาก 757.5 GB เหลือ 205.7 GB คือลดลง 73% ตัวเลขสวยมาก แต่ผมไม่ได้ apply เอง เพราะมันมีราคาที่ไม่ได้อยู่ในหน่วย GB
ซ้ำซ้อน แต่ restore point เยอะ
user ที่อยู่ทั้งกลุ่มวันและ cron เก่ามีจุดย้อนกลับสูงสุด 4-5 จุดต่อสัปดาห์ ไฟล์พังวันพุธยังมีสำเนาของวันอังคารให้หยิบ แลกกับการส่งข้อมูล 757.5 GB ต่อสัปดาห์และกลุ่มวันจันทร์ที่หนักเกือบสองเท่าของวันศุกร์
เบาลง 73% แต่เหลือจุดเดียว
ทุก user ถูก backup สัปดาห์ละ 1 ครั้ง กลุ่มละประมาณ 68.6 GB ถ้าไฟล์เสียหลังวัน backup ไปหนึ่งวัน สำเนาที่ใกล้ที่สุดคือของสัปดาห์ก่อน ข้อมูลที่เปลี่ยนในช่วงนั้นหายได้สูงสุดเกือบ 7 วัน
ผมเลยส่งตัวเลขทั้งสองฝั่งพร้อมทางเลือกให้เจ้าของตัดสิน ทางเลือกที่เสนอมีสองแบบคือ 3 กลุ่มเหมือนเดิม หรือ 6 กลุ่มกระจายจันทร์ถึงเสาร์ ณ วันที่ผมเขียนบันทึกนี้ยังไม่ได้ apply ทางไหน สิ่งที่ทำไปแล้วมีแค่เรื่องความครอบคลุม ส่วนตัวผมมองว่าเรื่องนี้ไม่ควรให้คนดูแลเครื่องตัดสินเองคนเดียว จำนวน restore point คือข้อตกลงกับคนที่เป็นเจ้าของข้อมูล ไม่ใช่ค่าปรับแต่งประสิทธิภาพ
ข้อเสนอ: ตัวตรวจ user กำพร้ารายวัน
ส่วนนี้เป็นข้อเสนอ ยังไม่ได้ติดตั้งจริงบนเครื่องนะครับ แต่เป็นสิ่งที่ผมคิดว่าต้องมี เพราะตราบใดที่การสร้าง user ไม่เพิ่มชื่อเข้า cron ให้เอง ปัญหาเดิมจะกลับมาใหม่ทุกครั้งที่มีบัญชีใหม่ สคริปต์ audit ข้างบนคืน exit code 1 เมื่อเจอ user กำพร้าอยู่แล้ว เลยผูกกับ cron รายวันได้ตรง ๆ
# /etc/cron.d/backup-coverage  (ข้อเสนอ ยังไม่ได้ติดตั้งจริง)
# 07:15 ทุกวัน ถ้ามี user ที่ไม่อยู่ใน backup cron ใดเลย ให้ส่งเมลเตือนพร้อมรายชื่อ
MAILTO=""
15 7 * * * root /root/audit_backup_cover.py > /root/backup-cover.log 2>&1 || grep ORPHAN /root/backup-cover.log | mail -s "[WARN] backup coverage drift" [email protected]
ลำดับที่ผมจะใช้กับเครื่อง DirectAdmin ทุกตัวที่ดูแลหลังจากนี้
- ดูวันที่แก้ล่าสุดของ
backup_crons.listเทียบกับวันที่สร้าง user รายล่าสุด ถ้าไฟล์เก่ากว่า แปลว่ามี user ตกหล่นแน่นอน - รันสคริปต์ audit แบบอ่านอย่างเดียว วางสคริปต์และผลลัพธ์ใต้
/rootสิทธิ์ 700 กับ 600 ไม่ใช่/tmp - เพิ่ม user กำพร้าเข้ากลุ่มที่เบาที่สุดก่อน เรื่องความครอบคลุมไม่ต้องรอการตัดสินใจเรื่องสมดุล
- สำรองไฟล์ด้วย
cp -pแล้วตรวจสิทธิ์ของไฟล์สำรองทุกตัวที่วางอยู่ ต้องเป็น 600 - คำนวณกลุ่มใหม่ด้วย greedy แล้วส่งตัวเลขสองฝั่งให้เจ้าของข้อมูลเลือก ทั้งปริมาณที่ลดและจำนวน restore point ที่หาย
- ผูกตัวตรวจ user กำพร้าไว้กับ cron รายวัน และเพิ่มข้อ "เพิ่มเข้า backup" ลงในขั้นตอนสร้าง user ทั้งทาง DA และทางบิลลิ่ง
สรุปคือของที่พังในงานนี้ไม่ใช่ตัว backup มันทำตามรายชื่อที่ได้รับอย่างซื่อสัตย์มาตลอด ที่พังคือรายชื่อนั้นไม่มีเจ้าของ DA ช่วยดูแลให้ครึ่งเดียวคือขาลบ ส่วนขาสร้างต้องมีคนหรือสคริปต์ทำเอง และ health check ที่ตรวจว่างานรันสำเร็จก็ไม่มีวันเห็นของที่ไม่เคยถูกสั่งให้ทำ ส่วนเรื่องของนอกเครื่องอัปไม่ขึ้นทั้งที่ job รายงานว่าสำเร็จ เป็นอีกชั้นหนึ่งที่ผมเล่าไว้ใน backup รันสำเร็จทุกคืน แต่ของนอกเครื่องไม่มีเลย 3 สัปดาห์ ใครจะเอาสคริปต์ audit ไปปรับ path ให้เข้ากับเครื่องตัวเองก็ตามสะดวกครับ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย