Demucs + Whisper ทีละไฟล์บนเครื่อง GPU แล้วดึงผลกลับตรวจ SHA-256
งานบนเครื่อง GPU ที่ใช้เวลาหลายนาทีควรรันได้ครั้งเดียวจบ และรันซ้ำได้โดยไม่เสียเวลาซ้ำ ผมเลยบังคับให้ทุกขั้นข้ามได้เมื่อมีผลแล้ว และทุกไฟล์ที่ดึงกลับต้องพิสูจน์ได้ว่าตรงกับต้นทางทุกไบต์
สรุปใน 1 นาที
- อาการ/ปัญหา
- สคริปต์เดิมวนทั้งคลังเพลงและเสี่ยงรันของเก่าซ้ำ ทั้งที่ต้องการแค่ไฟล์เดียว
- ใครควรอ่าน
- คนที่รัน Demucs กับ Whisper บนเครื่อง GPU ระยะไกล
- ทางแก้แบบสั้น
- ทำเป็นงานเดี่ยว ตรวจ SHA-256 ก่อนใช้ GPU ข้ามขั้นที่มีผลแล้ว แล้วดึงผลกลับเฉพาะ 7 ไฟล์ พร้อมเทียบขนาดและ SHA-256 กับต้นทาง
พอดีผมมีเพลงทดลองเพลงหนึ่งยาว 280.85 วินาที (4 นาที 41 วินาที) ต้องการรู้เวลาเริ่มและจบของวลีร้อง กับจังหวะคร่าว ๆ เพื่อเอาไปวางแผนตัดต่อ เครื่องหลักของผมไม่มี GPU พอสำหรับงานถอดเสียง เลยส่งไปรันที่เครื่อง GPU แยกอีกเครื่อง ปัญหาคือสคริปต์เดิมที่ผมมีอยู่เขียนให้วนทุกเพลงในคลัง ถ้ารันตรง ๆ มันจะประมวลผลของเก่าทั้งหมดซ้ำ ทั้งที่ผมต้องการแค่ไฟล์เดียว
บทความนี้เล่าวิธีดัดสคริปต์วนคลังให้เป็น "งานเดี่ยว" และวิธีส่งผลกลับให้ตรวจพิสูจน์ได้ ไม่ได้เล่าเรื่องการตั้งค่าเครื่องหรือการรันงานยาวผ่าน SSH ซึ่งมีเล่นไว้แล้วใน สั่งงานอัตโนมัติบนเครื่อง Windows ระยะไกลผ่าน SSH + Task Scheduler ชื่อเครื่อง ชื่อไฟล์เสียง และพาธบนเครื่อง GPU ผมเปลี่ยนเป็นชื่อกลางหมด ข้อความที่ถอดได้จากเสียงก็ไม่นำมาลงเลย เพราะสิ่งที่ผมสนใจคือ "เวลา" ไม่ใช่เนื้อหา
ปัญหา: สคริปต์วนคลังกับงานที่ต้องการแค่ไฟล์เดียว
สคริปต์วนคลังเป็นของที่เขียนง่ายและใช้สะดวกตอนมีหลายไฟล์ แต่มีสองความเสี่ยงที่ผมไม่อยากเจอ ข้อแรกคือเปลืองเวลา GPU ไปกับของที่เคยทำเสร็จแล้ว ข้อสองคือถ้ามีไฟล์ใดไฟล์หนึ่งในคลังถูกแก้หรือเสียหายระหว่างโอน ผลลัพธ์ที่ได้จะปนกันโดยไม่มีใครรู้
ผมเลยตั้งกติกาสามข้อสำหรับงานเดี่ยว
- ชี้ไปที่โฟลเดอร์งาน 1 โฟลเดอร์ และไฟล์ต้นทางไฟล์เดียวเท่านั้น
- ตรวจ SHA-256 ของต้นทางก่อนแตะ GPU
- ทุกขั้นข้ามได้ถ้ามีไฟล์ผลลัพธ์ของขั้นนั้นอยู่แล้ว
ขั้น 0: ตรวจ SHA-256 ก่อนใช้ GPU
ลำดับสำคัญที่สุดในสคริปต์คือ ตรวจก่อน แล้วค่อยใช้ GPU ถ้าไฟล์ที่ส่งไปเสียหายระหว่างโอนหรือเผลอส่งผิดไฟล์ การวิ่ง Demucs กับ Whisper ไปจนจบโดยไม่รู้เลยคือการเสียเวลาที่แพงที่สุด ค่าที่คาดไว้ผมคำนวณจากเครื่องต้นทางแล้วส่งไปพร้อมงาน
# job_single.py — งานเดี่ยว 1 โฟลเดอร์ 1 ไฟล์ (เวอร์ชันย่อ)
import hashlib, json, subprocess, sys, time
from pathlib import Path

def sha256(path, chunk=1 << 20):
    h = hashlib.sha256()
    with open(path, 'rb') as f:
        while block := f.read(chunk):
            h.update(block)
    return h.hexdigest()

def log(msg):
    print(time.strftime('%H:%M:%S'), msg, flush=True)

job = Path(sys.argv[1])               # โฟลเดอร์งานเดียว
expected = sys.argv[2].lower()        # SHA-256 ที่คาดไว้ ส่งมาจากเครื่องต้นทาง
src = job / 'source.mp3'

actual = sha256(src)
if actual != expected:
    sys.exit(f'[ERR] SHA-256 ของต้นทางไม่ตรง ไม่แตะ GPU: {actual} != {expected}')
log('[OK] source sha256 ตรง')
ขั้น 1: แยกเสียงร้องด้วย Demucs
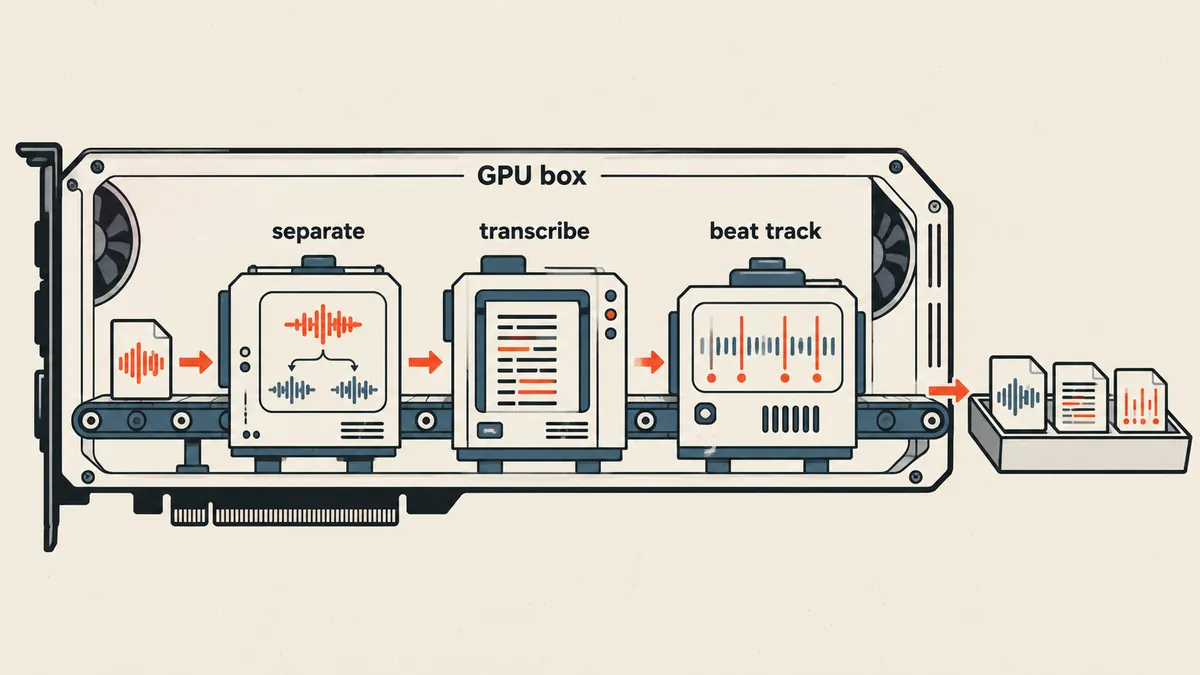
ใช้ --two-stems vocals เพราะผมต้องการแค่เสียงร้องกับส่วนที่เหลือ ไม่ต้องแยกสี่ชิ้น และโมเดล htdemucs ให้ผลดีพอสำหรับงานหาเวลา ขั้นนี้ข้ามถ้ามี vocals.wav อยู่แล้ว
sep_dir = job / 'sep'
vocals = sep_dir / 'htdemucs' / src.stem / 'vocals.wav'

if vocals.exists():
    log(f'Using existing {vocals.name}')
else:
    log('Demucs start')
    subprocess.run(
        [sys.executable, '-m', 'demucs', '--two-stems', 'vocals',
         '-n', 'htdemucs', '-o', str(sep_dir), str(src)],
        check=True)
    assert vocals.exists(), 'Demucs ไม่สร้าง vocals.wav'
ขั้น 2: ลดเป็น 16 kHz แล้วถอดคำด้วย Whisper large-v3
Whisper รับสัญญาณ mono 16 kHz เลยต้องลดจากสเตอริโอ 44.1 หรือ 48 kHz ก่อน แล้วโหลดโมเดลบน CUDA ผมตั้ง word_timestamps=True เพื่อให้ได้เวลาระดับคำ และตั้ง condition_on_previous_text=False เพื่อลดการวนซ้ำข้อความเดิม ซึ่งเป็นอาการที่ Whisper ชอบเป็นกับเสียงที่ซ้ำ ๆ ส่วน del model กับ empty_cache ตอนท้ายเพื่อคืน VRAM ก่อนไปขั้นถัดไป
words_json = job / 'words.json'

if words_json.exists():
    log(f'Using existing {words_json.name}')
else:
    import numpy as np, soundfile as sf, librosa, torch, whisper
    log('Whisper start')
    y, sr = sf.read(vocals, dtype='float32')
    if y.ndim > 1:
        y = y.mean(axis=1)                              # เฉลี่ยเป็น mono
    y = librosa.resample(y, orig_sr=sr, target_sr=16000).astype('float32')

    model = whisper.load_model('large-v3', device='cuda')
    res = model.transcribe(y, language='th', word_timestamps=True,
                           condition_on_previous_text=False, fp16=True)
    words = [{'start': w['start'], 'end': w['end'], 'word': w['word']}
             for seg in res['segments'] for w in seg.get('words', [])]
    words_json.write_text(json.dumps(words, ensure_ascii=False), encoding='utf-8')

    del model
    torch.cuda.empty_cache()                            # คืน VRAM
ผมไม่ได้เอาเนื้อของ words.json มาแสดง และไม่เอาไปใช้เป็นข้อความจริง ข้อความจาก ASR ผมถือเป็น หลักฐานเวลา เท่านั้น ไม่ใช่ตัวหนังสือที่ถูกต้อง เรื่องความผิดเพี้ยนของผลลัพธ์ที่ไปเจอจริงผมแยกเล่นไว้ใน Whisper ถอดเสียงฮัมเป็นคำ และได้เวลาผิด
ในรายงานผมเขียนเสมอว่า human_listening_verified = false และหมายเหตุว่า ASR เป็นหลักฐานเวลา ไม่ใช่ข้อความจริง คำที่ถูกต้องคือ "ประมวลผลอัตโนมัติ" ไม่ใช่ "AI ฟังแล้ว" เพราะยังไม่มีมนุษย์ฟังยืนยัน ค่าธงนี้จะเปลี่ยนก็ต่อเมื่อมีคนฟังจริง
ขั้น 3: จังหวะด้วย librosa และระดับเสียงร้อง
ขั้นสุดท้ายใช้ librosa.beat.beat_track ประมาณจังหวะ แล้วแบ่ง RMS ของสเต็มเสียงร้องเป็น 700 ช่องเพื่อดูว่าตรงไหนมีเสียงร้อง ค่าที่ได้เป็นการประมาณทั้งคู่ ผมใส่หมายเหตุในไฟล์ไว้เสมอ
beats_json = job / 'beats.json'
act_json = job / 'vocal-activity.json'

if beats_json.exists() and act_json.exists():
    log('Using existing beats / vocal-activity')
else:
    import numpy as np, librosa
    y, sr = librosa.load(src, sr=22050)
    tempo, beat_frames = librosa.beat.beat_track(y=y, sr=sr)
    beats_json.write_text(json.dumps({
        'estimated_bpm': float(np.atleast_1d(tempo)[0]),
        'beat_times': librosa.frames_to_time(beat_frames, sr=sr).round(3).tolist(),
        'note': 'ค่าประมาณ ไม่ใช่ downbeat ที่ตรวจด้วยหู',
    }, ensure_ascii=False), encoding='utf-8')

    v, vsr = librosa.load(vocals, sr=22050)
    rms = librosa.feature.rms(y=v)[0]
    bins = np.array([c.mean() for c in np.array_split(rms, 700)])
    bins = bins / (bins.max() + 1e-9)                   # ปรับเป็น 0-1
    act_json.write_text(json.dumps({
        'bins': bins.round(4).tolist(),
        'note': 'มีเสียงเครื่องดนตรีรั่วปนในสเต็มเสียงร้อง',
    }, ensure_ascii=False), encoding='utf-8')
จังหวะที่ librosa ประมาณได้ราว 129.2 BPM ส่วนตัวเลขที่ติดมากับชื่อไฟล์ต้นทางเขียนว่า 126 ซึ่งผมก็ไม่ได้ตรวจด้วยหูเหมือนกัน สองค่าไม่ตรงกัน ผมเก็บไว้เป็นเครื่องเตือนใจว่าตัวประมาณจังหวะไม่ใช่ความจริง ใช้เป็นแนวทางได้ แต่ห้ามใช้ตัดสินจุดตัดต่อโดยไม่ฟัง
จบด้วยรายงานและรายการผลลัพธ์พร้อมค่า hash
ท้ายงาน สคริปต์เขียน report.json ที่มี SHA-256 ของอินพุต วิธีที่ใช้ ชื่อ GPU (การ์ด 16 GB ซึ่ง nvidia-smi รายงาน 16311 MiB) เวลาที่ใช้ ธง human_listening_verified และคัดลอกโค้ดที่ใช้ไว้ในโฟลเดอร์ผลลัพธ์ จากนั้นเขียน verification.json ที่ลิสต์ขนาดกับ SHA-256 ของทุกไฟล์ผลลัพธ์
out_files = ['words.json', 'beats.json', 'vocal-activity.json',
             'vocals-preview.mp3', 'report.json', 'run.log', 'used-source-code.py']

subprocess.run(['ffmpeg', '-y', '-v', 'error', '-i', str(vocals),
                '-b:a', '160k', str(job / 'vocals-preview.mp3')], check=True)

(job / 'used-source-code.py').write_text(Path(__file__).read_text(encoding='utf-8'),
                                         encoding='utf-8')
(job / 'report.json').write_text(json.dumps({
    'input_sha256': actual,
    'method': 'demucs htdemucs two-stems -> whisper large-v3 -> librosa beat_track',
    'human_listening_verified': False,
    'note': 'ASR เป็นหลักฐานเวลา ไม่ใช่ข้อความจริง',
}, ensure_ascii=False, indent=2), encoding='utf-8')

log('[OK] job done')            # พิมพ์ข้อความสุดท้ายก่อน run.log จะถูกคิดค่า hash

# ขั้นสุดท้ายจริง ๆ: หลังจากนี้ห้ามมีอะไรเขียนลงไฟล์ผลลัพธ์อีก
verify = {f: {'bytes': (job / f).stat().st_size, 'sha256': sha256(job / f)}
          for f in out_files}
(job / 'verification.json').write_text(json.dumps(verify, indent=2), encoding='utf-8')
ลำดับสำคัญคือ verification.json ต้องถูกเขียนเป็นขั้นสุดท้ายจริง ๆ หลังจากไม่มีอะไรเขียนลงไฟล์ผลลัพธ์อีกแล้ว ไม่งั้นค่า hash ของ run.log จะไม่ตรงกับไฟล์ที่ถูกดึงกลับ (ตัวนี้เป็นโค้ดที่เขียนใหม่ให้อ่านง่าย ไม่ใช่สคริปต์จริง) ถัดไปคือขั้นดึงกลับ
ผลที่วัดได้จากล็อก
เวลาจริงในล็อกของรอบนั้นคือ Demucs เริ่ม 06:46:57 แล้ว Whisper เริ่ม 06:47:11 ห่างกัน 14 วินาที ซึ่งรวมโหลดโมเดลแล้ว จากนั้นขั้นจังหวะเริ่ม 06:51:31 แปลว่า Whisper ใช้ราว 4 นาที 20 วินาทีรวมโหลดโมเดล เวลาของขั้น librosa ไม่ได้บันทึกแยกเลยผมไม่เดา
การรันซ้ำอีกครั้งตอน 06:53:16 ขึ้นข้อความ Using existing ในทั้งสองขั้นแรกและจบภายใน 3.91 วินาที นี่คือหลักฐานว่าระบบ resume ทำงานจริง ไม่ใช่แค่เขียนไว้ในโค้ด
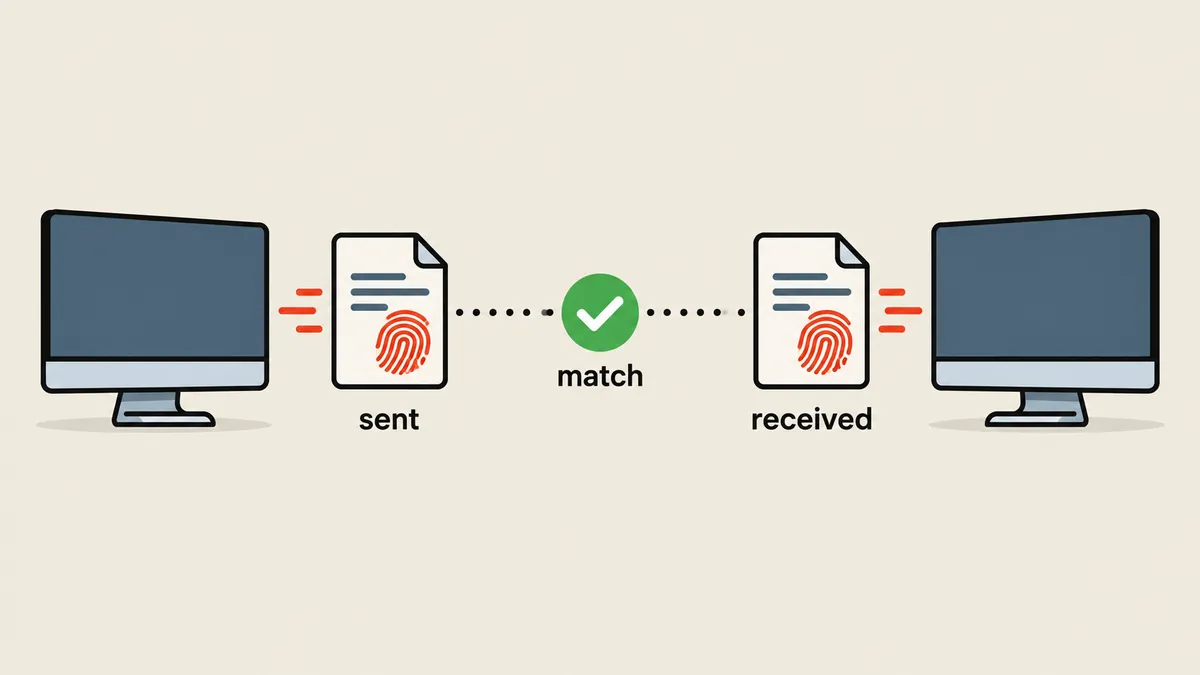
ดึงผลกลับเฉพาะ 7 ไฟล์ แล้วเทียบขนาดกับ SHA-256
กฎของผมคือดึงกลับเฉพาะผลที่ตรวจได้ ไม่ดึงต้นฉบับ โมเดล หรือแคชซึ่งหนักและไม่มีประโยชน์ที่เครื่องหลัก ที่สำคัญคือ ห้ามรันขั้นที่เสร็จแล้วซ้ำเพียงเพื่อจะดึงไฟล์ ไฟล์ที่ดึงกลับมีเจ็ดไฟล์ คือ words.json, beats.json, vocal-activity.json, vocals-preview.mp3, report.json, run.log และ used-source-code.py
# บนเครื่องหลัก: ดึงกลับเฉพาะผลลัพธ์ที่ตรวจได้ (host-gpu คือ alias ของเครื่อง GPU)
mkdir -p results/job-a
for f in words.json beats.json vocal-activity.json vocals-preview.mp3 \
         report.json run.log used-source-code.py; do
  scp "host-gpu:C:/jobs/job-a/$f" "results/job-a/$f"
done
# รายการ hash ฝั่ง GPU ใช้เป็นเกณฑ์เทียบ ไม่นับเป็นหนึ่งในเจ็ดไฟล์ผลลัพธ์
scp "host-gpu:C:/jobs/job-a/verification.json" results/verification.remote.json
python verify_transfer.py results/job-a results/verification.remote.json
# verify_transfer.py — เทียบขนาดและ SHA-256 ของไฟล์ที่ดึงกลับกับที่เครื่อง GPU รายงาน
import hashlib, json, sys
from pathlib import Path

def sha256(p):
    h = hashlib.sha256()
    with open(p, 'rb') as f:
        for b in iter(lambda: f.read(1 << 20), b''):
            h.update(b)
    return h.hexdigest()

local = Path(sys.argv[1])                       # results/job-a
remote = json.loads(Path(sys.argv[2]).read_text(encoding='utf-8'))   # hash ฝั่ง GPU

ok = True
for name, want in remote.items():
    p = local / name
    got = {'bytes': p.stat().st_size, 'sha256': sha256(p)} if p.exists() else None
    same = got == want
    ok &= same
    print(f'[{"OK" if same else "ERR"}] {name}')

(local / 'transfer-verification.json').write_text(
    json.dumps({'all_verified': ok}, indent=2), encoding='utf-8')
print('all_verified =', ok)
sys.exit(0 if ok else 1)
ผลของรอบนั้นได้ all_verified = true ครบ 7 ไฟล์ ไฟล์ต้นฉบับบนเครื่อง GPU ไม่ถูกแตะเลย โมเดลกับแคชก็ยังอยู่ที่เดิม
ทำไมต้องออกแบบให้ข้ามได้ทุกขั้น
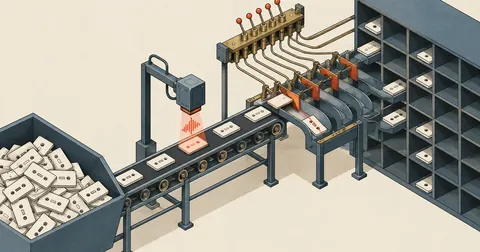
เหตุผลหลักของ "ข้ามถ้ามีผลแล้ว" ไม่ใช่การประหยัดเวลาอย่างเดียว แต่คือการทำให้สคริปต์เป็นงานที่รันซ้ำได้โดยไม่เปลี่ยนผลลัพธ์ ถ้าเครือข่ายหลุดกลางทาง หรือผมเผลอรันซ้ำ หรือต้องการแค่ขั้นสุดท้ายใหม่ ผมสั่งรันคำสั่งเดิมได้เลยโดยไม่ต้องจำว่าขั้นไหนเสร็จแล้ว ไฟล์ผลลัพธ์ของแต่ละขั้นคือบันทึกสถานะ ไม่ต้องมีไฟล์สถานะแยก ตอนรันซ้ำจริงล็อกขึ้นข้อความ Using existing ครบทั้งสองขั้นแรกและงานจบใน 3.91 วินาที ผมถือว่านั่นคือการทดสอบที่ตอบคำถามได้ชัดที่สุดว่าระบบ resume ทำงานจริง
ข้อแลกเปลี่ยนที่ต้องรู้คือ ถ้าไฟล์ผลลัพธ์ของขั้นใดเสียหายแต่ยังมีชื่ออยู่ สคริปต์จะข้ามขั้นนั้นไปเลยและส่งไฟล์เสียต่อให้ขั้นถัดไป ทางลดความเสี่ยงที่ผมแนะนำคือเขียนไฟล์ผลลัพธ์เป็นการกระทำสุดท้ายของแต่ละขั้น (ในโค้ดย่อข้างบนยังไม่ได้เขียนแบบเขียนไฟล์ชั่วคราวแล้วเปลี่ยนชื่อ) และถ้าสงสัยว่าขั้นไหนเสีย วิธีที่ปลอดภัยคือลบไฟล์ผลลัพธ์ของขั้นนั้นทิ้งแล้วรันใหม่ ไม่ใช่แก้ไฟล์ด้วยมือ
อีกเรื่องที่ควรระวังคือหน่วยความจำของการ์ด ผมสั่ง del model กับ torch.cuda.empty_cache() หลังขั้น Whisper ทุกครั้ง เพราะโมเดลขนาดใหญ่ยึด VRAM ไว้จนกว่ากระบวนการจะจบ ถ้าอนาคตเพิ่มขั้นที่ใช้ GPU ต่อท้าย ขั้นนั้นจะไม่ต้องแย่งหน่วยความจำกับโมเดลที่ใช้เสร็จแล้ว ในงานนี้ขั้น librosa รันบน CPU เลยไม่ได้ผลต่างที่มองเห็น แต่ผมยังคงสั่งคืนไว้เป็นนิสัย
และสุดท้าย สิ่งที่สคริปต์นี้ไม่ได้ทำก็ต้องบอกให้ชัด มันไม่ได้ตรวจว่าคำที่ถอดได้ถูกต้องหรือไม่ ไม่ได้ตรวจว่าจังหวะที่ประมาณได้ตรงกับที่หูได้ยินหรือไม่ และไม่ได้วัดเวลาของขั้น librosa แยกต่างหาก สิ่งที่มันรับประกันมีเพียงสองอย่าง คือไฟล์ต้นทางที่เข้ามาถูกไฟล์ และไฟล์ผลลัพธ์ที่ออกไปมาถึงเครื่องหลักครบทุกไบต์
ลำดับที่ผมใช้กับงานเดี่ยวทุกครั้ง
- สร้างโฟลเดอร์งานใหม่ 1 โฟลเดอร์ วางไฟล์ต้นทางไฟล์เดียว คำนวณ SHA-256 ที่เครื่องต้นทางส่งไปพร้อมงาน
- ที่เครื่อง GPU สคริปต์ตรวจ SHA-256 ก่อน ถ้าไม่ตรงให้หยุดทันที ห้ามแตะ GPU
- รัน Demucs, Whisper, librosa ตามลำดับ แต่ละขั้นข้ามถ้ามีไฟล์ผลลัพธ์ของขั้นนั้นอยู่แล้ว
- ปล่อย VRAM หลังขั้น Whisper ทุกครั้ง ก่อนไปขั้นที่ต้องการหน่วยความจำ
- เขียน report.json พร้อม human_listening_verified เป็น false และ verification.json พร้อม hash ของทุกไฟล์ผลลัพธ์
- ดึงกลับเฉพาะเจ็ดไฟล์ รัน verify_transfer.py ต้องได้ all_verified = true ถึงถือว่างานเสร็จ
รันทั้งคลังทุกครั้ง
- ประมวลผลของเก่าซ้ำ
- ไม่ตรวจไฟล์ก่อนใช้ GPU
- ผลของหลายไฟล์ปนกันได้
1 โฟลเดอร์ 1 ไฟล์
- ตรวจ SHA-256 ก่อนทุกครั้ง
- ข้ามขั้นที่มีผลแล้ว
- ส่งกลับ 7 ไฟล์พร้อมพิสูจน์ hash
เวลาเป็นวินาทีและนาทีในบทความมาจากเพลงเดียวบนเครื่องเดียว อย่านำไปเป็นเกณฑ์ ตัวสคริปต์ย่อด้านบนผมเขียนใหม่ให้อ่านง่าย ไม่ใช่ไฟล์จริงที่รัน และชื่อโมเดลกับพารามิเตอร์ควรตรวจกับรุ่นของไลบรารีที่ติดตั้งอยู่ของคุณก่อนเสมอ
บทเรียนที่ผมเก็บไว้คือ ถ้าต้องทำงานหนักบนเครื่องอื่นให้ทำให้มันรันซ้ำได้โดยไม่เสียของ และให้ทุกอย่างที่ส่งกลับมีหลักฐานติดมาด้วย ความรู้สึกว่า "น่าจะโอนมาถูกแล้ว" ใช้เป็นหลักฐานไม่ได้ ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย