ทำ Redis แบบ per-user บน DirectAdmin โดยไม่ต้องซื้อ pro_pack
หลัง migrate มา Debian 12 มี WordPress ของลูกค้ารายหนึ่งทำ TTFB ปาเข้าไป 6-8 วินาที ลูกค้าบ่นช้า ผมไล่ดู query log แล้วลงเอยที่ Redis object cache แบบแยกต่อ user เลยมาเล่าให้ฟังตั้งแต่ต้นจนจบ
สรุปใน 1 นาที
- อาการ/ปัญหา
- WordPress ของลูกค้า TTFB 6-8 วินาที หลัง migrate มา Debian 12
- ใครควรอ่าน
- ผู้ดูแล DirectAdmin shared hosting ที่อยากได้ Redis object cache แยกต่อ user
- ทางแก้แบบสั้น
- เขียน provisioning script เองด้วย systemd template กับ unix socket และ cgroup limit แทน DA panel ที่ต้องใช้ pro_pack แล้วเชื่อมกับ WordPress, Flarum และ Laravel
หลังจาก migrate ระบบมา Debian 12 มี WordPress site หนึ่งของลูกค้าที่ทำ TTFB อยู่ราว 6-8 วินาที ลูกค้าบ่นว่าช้า ผมเปิด MariaDB query log ดูแล้วเห็นชัดว่า WordPress ยิง query ราว 30-100 ครั้งต่อ request ส่วนใหญ่เป็นการอ่าน options table กับ transient lookup เดิมๆ ซ้ำไปซ้ำมาทุก request
ผมลองหลายทางอยู่พักหนึ่ง สุดท้ายมาลงตัวที่ Redis object cache บทความนี้ผมจะเล่าตั้งแต่เหตุผลที่เลือกออกแบบแบบนี้ ไปจนถึงสคริปต์และการเชื่อมต่อกับแต่ละแอป
เรื่องนี้ต่อยอดมาจากซีรีส์ migration DA จาก CentOS 7 มา Debian 12 บน Proxmox ที่ผมเขียนไว้ก่อนหน้า ถ้าใครยังไม่ได้อ่านพื้นฐานการวางเครื่องไว้ แนะนำให้ไล่ซีรีส์นั้นก่อนจะเห็นภาพรวมชัดขึ้น
ทำไมต้อง per-user ไม่ใช่ shared Redis
ปัญหาเริ่มจากตัว DirectAdmin เอง ถ้าเราตั้ง php_redis=yes ใน CustomBuild มันก็แค่ install PHP extension ให้ ไม่ได้ enable Redis instance ให้ใครเลย ส่วน DA panel มีหน้า Redis UI อยู่ก็จริง แต่ต้องใช้ pro_pack license เครื่องของผมเป็น Legacy license (pro_pack=0) พอกด Enable ใน panel มันไม่ทำอะไรเลย เงียบสนิท
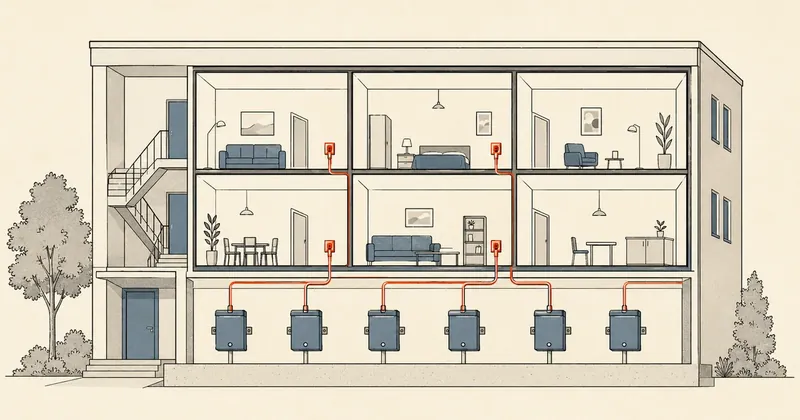
ผมเลยตัดสินใจเขียน script เอง เพื่อ replicate สิ่งที่ DA panel ควรจะสร้างให้ นั่นคือ per-user systemd instance + per-user config + DA flag
เมื่อจะทำเองแล้ว คำถามต่อมาคือทำแบบ shared instance เดียวให้ทุกคนใช้ หรือแยก instance ต่อ user ผมเทียบสองทางนี้ให้ดู
instance เดียวทุก user
- Setup: 1 service พอร์ต <port>
- Isolation: user A อ่าน key ของ user B ได้
- Key collision: ต้อง prefix แยกทุก user เอง
- Limit: แชร์ memory pool ก้อนเดียว
- Lifecycle: ลบ user แล้ว cleanup key ยาก
- Overhead: รวมราว 5 MB
instance ต่อ user
- Setup: service per user ผ่าน systemd template
- Isolation: unix socket mode 770 ใน /home
- Key collision: ไม่มีโอกาสชนกันเลย
- Limit: maxmemory ต่อ instance
- Lifecycle: ลบ user ก็ลบ instance ตรงๆ
- Overhead: ราว 5-10 MB ต่อ user
สำหรับงาน shared hosting ผมถือว่า isolation มาก่อนเสมอ เลยเลือก per-user ยอมเสีย RAM ไปนิดหน่อยต่อ user แต่ได้ความปลอดภัยและ cleanup ที่ง่ายมากกลับมา คุ้มกว่ากันเยอะในสภาพแวดล้อมที่มีลูกค้าหลายรายปนกัน
ทำไม unix socket ไม่ใช่ TCP
เมื่อตัดสินใจว่าแยก instance ต่อ user แล้ว ขั้นต่อมาคือจะให้แอปคุยกับ Redis ผ่านอะไร ระหว่าง TCP port กับ unix socket
ถ้าใช้ TCP port <port> เราจะต้องตั้ง requirepass มี network overhead ของ TCP stack และต้อง expose port ออกมา ซึ่งหมายความว่าต้องไปจัดการ rule ใน CSF เพิ่มอีก เพิ่ม attack surface โดยไม่จำเป็น
ถ้าใช้ unix socket ที่ /home/<user>/.redis/redis.sock เราได้ filesystem permission คุมแทน (ตั้ง mode 770) ไม่มี network เข้ามาเกี่ยว และที่สำคัญคือเร็วกว่าราว 2-3 เท่าเพราะไม่ต้องผ่าน TCP stack
ผมเลือก unix socket เป็นคำตอบสุดท้าย ทั้งเร็วกว่าและปลอดภัยกว่าในบริบทที่ Redis อยู่บนเครื่องเดียวกับแอปอยู่แล้ว
Provisioning script — redis-enable
ในเมื่อ DA panel ใช้ไม่ได้ ผมก็เขียน script มาแทนทั้งกระบวนการ วางไว้ที่ /usr/local/sbin/redis-enable ใช้งานแบบนี้
redis-enable <username> [S|M|L]

# ตัวอย่าง
redis-enable <user-a> M    # WordPress + WooCommerce
redis-enable <user-b> M    # Flarum forum
redis-enable <user-c> L    # Laravel app ที่กิน resource หนัก
ตัว script ทำงาน 4 ขั้นตอน และออกแบบให้ idempotent คือรันซ้ำกี่ครั้งก็ปลอดภัย ไม่พังของเดิม
ขั้นตอนทั้งสี่คือ:
- ตั้ง DA flag
redis=ONใน/usr/local/directadmin/data/users/<USER>/user.conf - เขียน per-user
redis.confที่/usr/local/directadmin/data/users/<USER>/redis.confซึ่งเป็นไฟล์ที่ systemd template ของ DA จะ--includeเข้ามา - สร้าง systemd dropin ที่
/etc/systemd/system/redis@<USER>.service.d/limit.confเพื่อกำหนด cgroupMemoryMaxกับMemoryHigh systemctl enable --now redis@<USER>แล้ว verify ด้วยคำสั่ง PING
redis.conf ที่ script เขียนออกมา
maxmemory <tier-value>
maxmemory-policy allkeys-lru
maxclients <tier-clients>
loglevel notice
rename-command FLUSHALL ""
rename-command CONFIG ""
rename-command DEBUG ""
rename-command SHUTDOWN ""
Security hardening ที่ใส่ทุก tier
ส่วนที่ผมให้ความสำคัญคือบรรทัด rename-command สี่บรรทัดท้าย เพราะ user ที่ได้ Redis ไปเป็นลูกค้า shared hosting ผมไม่อยากให้เขาทำอะไรที่กระทบเครื่องส่วนรวมได้
rename-command FLUSHALL ""— ปิด bulk delete ลูกค้าจะ destroy ทั้ง cache ไม่ได้rename-command CONFIG ""— ปิดการแก้ config ตอน runtime ลูกค้าจะเปลี่ยนmaxmemoryเองไม่ได้ ต้องผ่านredis-enableเท่านั้นrename-command DEBUG ""— ปิดคำสั่ง debugrename-command SHUTDOWN ""— ปิด instance ได้ทางเดียวคือผ่านsystemctl
การ rename-command เป็นการปิดจากฝั่งลูกค้า ไม่ได้ปิดจากฝั่งผม root/admin ยังจัดการทุกอย่างได้ผ่านการแก้ไฟล์ config ตรงๆ บวกกับ systemctl ตามปกติ
Tier system — S / M / L
ผมแบ่ง instance ออกเป็นสาม tier ตามขนาดงาน ไม่ได้จ่าย RAM เท่ากันให้ทุกคน
| Tier | maxmemory | maxclients | MemoryMax (hard) | MemoryHigh (soft) | Use case |
|---|---|---|---|---|---|
| S | 50 MB | 30 | 75 MB | 50 MB | WordPress เบา / blog / portfolio |
| M | 150 MB | 100 | 225 MB | 150 MB | WP + WooCommerce / Laravel เล็ก / Flarum forum |
| L | 500 MB | 300 | 750 MB | 500 MB | Laravel หนัก / multi-site WP / forum traffic สูง |
สองค่าใน cgroup ทำหน้าที่ต่างกัน:
MemoryMaxคือ hard cap kernel จะ kill instance ตัวนั้นก่อนที่เครื่องจะถึงจุด global OOM ไม่ให้ลาม instance เดียวมาฆ่าทั้งเครื่องMemoryHighคือ soft cap พอแตะค่านี้ kernel จะเริ่มสร้าง memory reclaim pressure ดึง memory คืนก่อนจะถึง hard cap
WordPress integration — 5 constants ที่ห้ามขาด
มาถึงฝั่งแอป เริ่มที่ WordPress ก่อน เพราะเป็นเคสที่ผมเริ่มเรื่องตอนต้น
plugin Redis Object Cache ตั้ง scheme เริ่มต้นเป็น TCP ถ้าเราตั้งแค่ WP_REDIS_PATH โดยไม่ตั้ง WP_REDIS_SCHEME=unix ตัว plugin จะพยายาม connect TCP ไปที่ localhost พอร์ตที่เราไม่ได้เปิด แล้วได้ Connection refused กลับมา
5 constants ที่ต้องใส่ใน wp-config.php และต้องอยู่ ก่อน บรรทัด /* That's all, stop editing! */
define('WP_REDIS_PATH',     '/home/<USER>/.redis/redis.sock');
define('WP_REDIS_SCHEME',   'unix');           // ห้ามขาด
define('WP_REDIS_CLIENT',   'phpredis');       // ใช้ phpredis ไม่ใช่ predis เพราะเร็วกว่า
define('WP_REDIS_DATABASE', 0);
define('WP_REDIS_TIMEOUT',  1);
ขั้นตอนเปิด Redis ให้ WordPress site
- ฝั่ง server (root) —
redis-enable <user> M - login เป็น user แล้ว
cd ~/domains/<domain>/public_html - install plugin —
wp plugin install redis-cache --activate - แก้
wp-config.phpใส่ 5 constants ก่อนบรรทัด/* That's all */ - enable drop-in —
wp redis enable - verify —
wp redis statusควรเห็นStatus: Connected
ถ้าวาง constants ไว้ใต้บรรทัด /* That's all */ WordPress จะไม่อ่านมันเลย ต้องอยู่เหนือบรรทัดนั้นเท่านั้น ผมโดนมาแล้วหนึ่ง site เสียเวลานั่งหาเป็นชั่วโมง
site ที่ใช้ plugin เก่ามากๆ เช่นพวกที่เขียน syntax PHP 5 แบบ $str{0} จะทำให้ wp-cli ที่รันบน PHP 8.2 default เกิด parse error ต้องสั่งผ่าน PHP 7.4 แทน เช่น /usr/local/php74/bin/php wp ...
Flarum — ต้องใช้ fof/redis ไม่มี native
จุดนี้สำคัญ Flarum 1.x ไม่รองรับ Redis native ถ้าเราใส่ cache_driver, session_driver หรือ redis keys ลงไปใน config.php เฉยๆ Flarum จะ silently ignore ทิ้งหมดทุกตัว ไม่มี error ไม่มีอะไรเตือน คิดว่าทำงานแล้วแต่จริงๆ ไม่ได้ใช้
ยืนยันได้จาก source code เลย
grep -r "'cache_driver'" vendor/flarum/core/ # 0 matches
ทางที่ถูกคือต้องติด extension จาก FriendsOfFlarum ก่อน
su - <user>
cd ~/domains/<domain>/public_html

/usr/local/php82/bin/php composer.phar require fof/redis
/usr/local/php82/bin/php flarum extension:enable fof-redis
แล้วค่อยตั้งใน config.php
return [
    // ... existing keys ...
    'cache_driver'   => 'redis',
    'session_driver' => 'redis',
    'redis' => [
        'scheme'   => 'unix',
        'path'     => '/home/<USER>/.redis/redis.sock',
        'password' => null,
        'database' => 0,
    ],
];
Flarum ใช้ db1-4 ไม่ใช่ db0
อีกจุดที่ต้องระวังคือ Flarum + fof/redis จะกระจาย data ลง database 1 ถึง 4 ไม่ได้ใช้ db0
| Database | เนื้อหา |
|---|---|
| db0 | default (ว่าง) |
| db1 | sessions |
| db2 | cache |
| db3 | locale / settings |
| db4 | other |
เวลาเขียน monitor command ต้องนับ key ของทุก db ด้วย INFO keyspace ไม่ใช่ดูแค่ DBSIZE เพราะ DBSIZE คืนค่าเฉพาะ db0 ซึ่ง Flarum ไม่ได้ใช้ จะเห็นเป็น 0 ตลอดทั้งที่จริงมี key เพียบ
Laravel — native phpredis ใช้ได้เลย
ฝั่ง Laravel สบายที่สุด เพราะ DA + CustomBuild ติด phpredis ให้ทุก PHP version อยู่แล้ว (ยกเว้น 5.6) และ Laravel 8 ขึ้นไปมี native Redis support ในตัว ไม่ต้องลง plugin หรือ composer package เพิ่ม
ตั้งใน .env
REDIS_CLIENT=phpredis
REDIS_HOST=/home/<USER>/.redis/redis.sock    # path เริ่มด้วย "/" = unix socket
REDIS_PORT=0                                  # 0 = ไม่ใช้ TCP
REDIS_PASSWORD=null
REDIS_DB=0
REDIS_CACHE_DB=1

CACHE_DRIVER=redis
SESSION_DRIVER=redis
QUEUE_CONNECTION=redis
apply แล้ว verify
cd ~/domains/<domain>/public_html
/usr/local/php82/bin/php artisan config:clear
/usr/local/php82/bin/php artisan cache:clear
/usr/local/php82/bin/php artisan tinker

>>> Cache::put('test', 'hello', 60); Cache::get('test')
# ควรได้: "hello"
Laravel ฉลาดพอที่จะ detect prefix / ใน HOST แล้วปรับเป็น unix socket ให้อัตโนมัติ จุดนี้ดูได้จาก framework source code มี logic รองรับตรงนี้อยู่ ไม่ต้องไปตั้งอะไรเพิ่ม
ผลลัพธ์ด้าน performance
กลับมาที่ WP site ของลูกค้าที่ผมเริ่มเรื่องตอนต้น ซึ่งเป็นเคส heavy ของจริง
| Scenario | TTFB | MySQL queries |
|---|---|---|
| ก่อน Redis (cold) | 6-8 วินาที | 80-120 queries/request |
| หลัง Redis (warm cache) | 1.3-1.7 วินาที | 3-8 queries/request |
สรุปคร่าวๆ คือเร็วขึ้นราว 5 เท่า และลด DB load ลงราว 15 เท่า
ส่วน MySQL load บนเครื่องโดยรวมก็เปลี่ยนชัด:
- ก่อนเปิด Redis peak อยู่ราว 80% CPU บน mysqld ในช่วงเวลาทำการ
- หลัง deploy ครบราว 9 user peak ลดเหลือราว 30-40% CPU เป็นตัวเลขจริงที่วัดได้
ผลพลอยได้คือ free CPU คืนมาให้ user รายอื่นๆ ที่ไม่ได้ใช้ Redis ด้วย ทั้งเครื่องเบาขึ้น
Self-heal — กัน DA panel strip flag redis=ON
มีจุดที่ต้องระวังเรื่อง DA panel เวลา admin กด save form ของ user ตัว panel อาจ rewrite user.conf ทับ flag custom ของเราหายไป ผมเลยใส่ cron daily ไว้ตรวจและซ่อมให้เอง
#!/bin/bash
# /etc/cron.daily/redis-flag-check

for unit in $(systemctl list-units --type=service --no-legend 'redis@*' --state=active | awk '{print $1}'); do
    user=$(echo "$unit" | sed 's/redis@//;s/.service//')
    uc=/usr/local/directadmin/data/users/$user/user.conf
    [ -f "$uc" ] || continue
    if ! grep -q '^redis=ON' "$uc"; then
        sed -i '/^redis=/d' "$uc"
        echo 'redis=ON' >> "$uc"
        logger -t redis-flag-check "restored redis=ON for $user"
    fi
done
อันนี้คือการเอาแนวคิด DA Update Survival Strategy มาใช้เฉพาะกับกรณี Redis ของเรา คือไม่ฝากความหวังไว้กับ panel แล้วมี cron คอยซ่อม flag ที่ถูก rewrite
Pilot selection — ไม่เปิดให้ทุก user
ผมไม่ได้เปิด Redis แบบ shotgun ให้ทุกคน เลือกเฉพาะ user ที่ได้ประโยชน์จริง เพราะแต่ละ instance กิน RAM เพิ่ม
เกณฑ์ที่ผมใช้:
- stack รองรับ Redis — WordPress ≥ 5.4, Flarum + fof/redis, Laravel 8+
- มี database queries จริง ไม่ใช่ static HTML
- มี traffic / bandwidth พอสมควรจนคุ้มกับ RAM ที่จ่ายไป
ตัวอย่าง user ที่ผม ไม่ เปิดให้:
- static HTML site — อันนี้ใช้ CDN กับ gzip พอ ไม่เกี่ยวกับ Redis
- site ที่ไม่มี PHP runtime — ไม่มี query ให้ cache ตั้งแต่แรก
- WordPress เก่ามากๆ (เช่น 4.0, 4.7) — plugin ต้องการ WP ≥ 5.4 ลูกค้าต้อง upgrade WP ก่อนถึงจะเปิดได้
Monitoring commands
ชุดคำสั่งที่ผมใช้ตรวจสุขภาพ instance ต่อ user
# Health check
sudo -u <user> redis-cli -s /home/<user>/.redis/redis.sock PING

# Memory + tier
sudo -u <user> redis-cli -s /home/<user>/.redis/redis.sock INFO memory \
    | grep -E 'used_memory_human|maxmemory_human'

# Hit/miss ratio
sudo -u <user> redis-cli -s /home/<user>/.redis/redis.sock INFO stats \
    | grep -E 'keyspace_hits|keyspace_misses'

# Keys ต่อ database
sudo -u <user> redis-cli -s /home/<user>/.redis/redis.sock INFO keyspace

# Slow queries
sudo -u <user> redis-cli -s /home/<user>/.redis/redis.sock SLOWLOG GET 5
ไฟล์ทั้งหมดที่เกี่ยวข้อง
สรุปไฟล์ทั้งหมดในระบบนี้ว่าตัวไหนใหม่ ตัวไหนแก้ และตัวไหนเป็น runtime
NEW       /usr/local/sbin/redis-enable                              (provisioning)
NEW       /usr/local/sbin/redis-disable                             (cleanup)
NEW       /etc/cron.daily/redis-flag-check                          (self-heal)
NEW       /usr/local/directadmin/data/users/<USER>/redis.conf       (instance config per user)
NEW       /etc/systemd/system/redis@<USER>.service.d/limit.conf     (cgroup limits per user)
runtime   /home/<USER>/.redis/redis.sock                            (unix socket)
runtime   /home/<USER>/.redis/db/                                   (RDB/AOF data)
MODIFIED  /usr/local/directadmin/data/users/<USER>/user.conf        (เพิ่ม redis=ON)
Known limitation + งานที่ยังเหลือ
ของจริงไม่มีอะไรสมบูรณ์ ผมจดข้อจำกัดที่รู้อยู่ไว้ตามนี้:
- WP เก่าต้อง upgrade ก่อน — plugin Redis Object Cache ต้องการ WP ≥ 5.4
- ปิด persistence ไว้ — ไม่เปิด AOF/RDB เพราะใช้เป็น cache ล้วน data หายตอน reboot ไม่เป็นไร แต่ถ้าวันไหนเอา Laravel queue มาวางบน Redis ก้อนนี้ ต้องกลับมา adjust ตอนนั้น
- ใกล้เต็ม tier ต้อง upgrade — แค่ rerun
redis-enable <user> Lก็ขยับขึ้น tier ได้ - DA Redis UI ยัง broken — จะใช้ผ่าน panel เต็มรูปแบบต้องซื้อ pro_pack license ซึ่งมีค่าใช้จ่ายเพิ่ม ตอนนี้ workaround ผ่าน script ใช้ได้ดีพอ
- onboarding ต่อ site ยัง manual — เปิด Redis ฝั่ง server แล้ว ยังต้องไปตั้ง config ใน WP/Flarum/Laravel ของแต่ละ site เอง
ปิดท้าย
ใครที่เครื่อง DA เป็น legacy license แล้วมี WP site ลูกค้าช้า ลอง pattern นี้ดู ใช้ workaround ผ่าน script โดยไม่ต้องอัพเป็น pro_pack ก็ทำงานได้เต็มที่
อีกเรื่องที่อยากฝากไว้คือ ลองพิจารณาเปิด ZFS ก่อน Redis ด้วย เพราะ storage layer ก็ทำให้เครื่องเร็วขึ้นได้โดยไม่ต้องพึ่ง cache ทั้งหมด สองอย่างนี้เสริมกันได้ ผมเขียนเรื่อง ZFS mirror ไว้ในซีรีส์ migration ตอนถอด RAID อยู่แล้ว ไปไล่ดูได้
จะเริ่มจาก storage layer หรือ cache layer ก่อนก็ตามสะดวก หลักการเหมือนกันหมด คือลด work ที่ซ้ำซากออกจาก path ของทุก request เท่านั้นเอง
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย