allow-list บอทจาก config ไฟล์เดียว ทำไม Cloudflare ต้องอยู่ csf.ignore
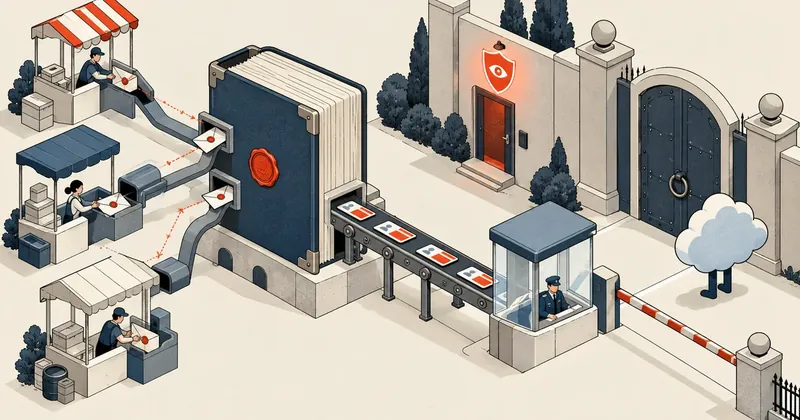
รายการอนุญาตที่ไม่มีเหตุผลกำกับทุกบรรทัดคือรายการที่สักวันจะมีคนแปลกหน้าอยู่ข้างใน บทความนี้เล่าวิธียุบให้เหลือไฟล์เดียว และเหตุผลที่ edge ของ CDN ต้องเป็น ignore ไม่ใช่ allow
สรุปใน 1 นาที
- อาการ/ปัญหา
- รายการบอทที่ไม่ควรโดนแบนกระจายอยู่หลายที่ และ Cloudflare Workers เปิด TCP ไปพอร์ตไหนก็ได้
- ใครควรอ่าน
- ผู้ดูแลเซิร์ฟเวอร์ที่ใช้ CSF และต้องกันบอทดีกับ Cloudflare ไม่ให้โดนแบน
- ทางแก้แบบสั้น
- เก็บรายการบอทในไฟล์ config ไฟล์เดียวพร้อมตัวกันพัง min=N ให้สคริปต์รายวันเขียนเข้า csf.ignore กับ csf.rignore และวาง Cloudflare ใน csf.ignore ไม่ใช่ csf.allow
พอดีมีเว็บหลายเว็บบนเซิร์ฟเวอร์เดียวกันที่พึ่งทราฟฟิกจากการค้นหา ผู้ดูแลอยากให้บอตที่สำคัญ ทั้งเสิร์ชเอนจิน ตัวช่วย AI ที่ค้นเว็บ เครื่องมือ SEO และตัวสร้างพรีวิวลิงก์ ไม่โดนไฟร์วอลล์แบนกลางทาง รอบแรกผมทำเป็นสคริปต์ตัวเดียวที่ฝังแหล่ง IP ไว้ในโค้ด (เรื่อง Googlebot ที่เคยโดนแบนถาวร เล่าไว้แล้ว) ใช้ได้ แต่ทุกครั้งที่ต้องเพิ่มหรือเอาเจ้าไหนออก ผมต้องไปแก้โค้ด และรายการที่ฝังอยู่ในโค้ดไม่มีที่ให้เขียนว่าทำไมเจ้านั้นถึงไม่อยู่ในรายการ
บทความนี้เลยเป็นรอบสอง รายการอยู่ในไฟล์ config ไฟล์เดียว สคริปต์รายวันอ่านแล้วเขียนเข้าไฟร์วอลล์ และผมให้น้ำหนักกับสิ่งที่จงใจไม่ใส่เท่ากับสิ่งที่ใส่ เนื้อหาในบทความนี้ผมใช้ชื่อกลางๆ กับตัวอย่างไอพีสำหรับเอกสาร เพราะรายการจริงของเซิร์ฟเวอร์เป็นเรื่องที่ไม่ควรเปิดเผย
ไฟล์ config ไฟล์เดียว
หนึ่งบรรทัดคือหนึ่งแหล่ง รูปแบบ name kind args [min=N] [noda] บรรทัดที่ขึ้นต้นด้วย # คือปิดอยู่ และคอมเมนต์เหนือบรรทัดเป็นที่เขียนเหตุผล ซึ่งผมถือว่าสำคัญที่สุดของไฟล์นี้
# sources.conf  (ตัวอย่างกลางๆ ไม่ใช่รายการจริง)
# name      kind    args                                         options
search-a    json    https://vendor-a.example/ranges.json         min=5
search-b    text    https://vendor-b.example/cidr.txt            min=3
tool-c      static  198.51.100.0/25
social-d    asn     AS64500                                      min=5
nolist-e    rdns    .crawl.vendor-e.example
edge-f      text    https://cdn-f.example/v4.txt https://cdn-f.example/v6.txt  min=10 noda

# ปิดไว้ตั้งใจ: crawler ที่ใช้ฝึกโมเดลอย่างเดียว
#train-g    json    https://vendor-g.example/ranges.json         min=5
ความหมายของ kind ที่ผมใช้ห้าแบบ
jsonไฟล์รายการ prefix ของผู้ให้บริการเอง ในรูป{"prefixes":[{"ipv4Prefix":"..."}]}ซึ่งเสิร์ชเอนจินหลายเจ้าใช้รูปแบบนี้textไฟล์ข้อความ CIDR บรรทัดละหนึ่งช่วงstaticเขียนช่วง IP ไว้ในไฟล์เลย สำหรับเจ้าที่เผยแพร่แค่ subnet เดียวasnเลข AS ของเครือข่ายที่เป็นของผู้ให้บริการเอง ดึงช่วงที่ AS นั้นประกาศใน BGP จริงrdnsต่อท้ายชื่อโฮสต์ สำหรับบอตที่ไม่มีรายการ IP แต่ตรวจกลับด้วย DNS ได้ เขียนลงcsf.rignoreให้ lfd ตรวจแบบ forward-confirmed reverse DNS
ตัวเลือก min=N กับ noda ผมอธิบายในหัวข้อต่อไป ส่วนวิธีใช้คือ แก้ไฟล์ ไม่แก้สคริปต์ แล้วรันสคริปต์ด้วย --dry-run ดูก่อนทุกครั้ง
แต่ละแบบดึงมายังไง และตัวกันพัง min=N
ถ้าแหล่งใดแหล่งหนึ่งเปลี่ยนรูปแบบ JSON หรือเซิร์ฟเวอร์ของเขาล่มตอนที่สคริปต์รัน ผลที่น่ากลัวที่สุดไม่ใช่ error แต่คือรายการว่างที่ถูกเขียนทับของเมื่อวาน แล้วบอตทั้งเจ้าถูกแบนในคืนเดียว ผมเลยมีกฎข้อเดียวคือ ดึงล้มหรือได้ช่วง IP น้อยกว่า min ให้ถือว่าการดึงเสีย แล้วใช้ cache ของเมื่อวานต่อ
def load_source(src, cache):
    try:
        ranges = FETCHERS[src.kind](src)          # json / text / static / asn
    except Exception as e:
        log.warning("%s: fetch failed (%s) -> keep yesterday", src.name, e)
        return cache.read(src.name)

    if len(ranges) < src.min:
        log.warning("%s: %d ranges < min=%d -> keep yesterday", src.name, len(ranges), src.min)
        return cache.read(src.name)

    cache.write(src.name, ranges)                 # ผ่านด่านแล้วค่อยทับ cache
    return ranges
ผมตั้ง min ให้ต่ำกว่าจำนวนจริงพอสมควร แต่ไม่ใช่ศูนย์ ถ้าตั้งสูงเกินไปเจ้าที่ลดช่วง IP ลงตามธรรมชาติจะถูกมองเป็นพัง และถ้าตั้งต่ำเกินไปก็ไม่ช่วยอะไร ส่วนค่าที่เหมาะต้องดูจากจำนวนที่แต่ละเจ้าประกาศจริงของเขา
เรื่อง asn ผมเลือกดึงจากข้อมูลช่วงที่ AS ประกาศใน BGP จริง (บริการของ RIPEstat) ไม่ใช้วัตถุ IRR เด็ดขาด เหตุผลคือ IRR เป็นข้อมูลที่ใครก็ลงทะเบียนเองได้ ถ้ารับมาเป็นแหล่งที่เชื่อถือ ก็เท่ากับยอมให้คนแปลกหน้าเขียนรายการอนุญาตของเรา ส่วน noda ใช้กับแหล่งที่ต้องการให้เขียนแค่ csf.ignore ไม่ต้องเข้าไวต์ลิสต์ของแผงควบคุม
ผลลัพธ์เขียนเป็นบล็อกที่มีเครื่องหมายต้นปลายในไฟล์ปลายทาง สคริปต์แตะเฉพาะข้างในบล็อกนั้น บรรทัดที่คนเพิ่มไว้เองนอกบล็อกไม่หาย และ restart ตัว lfd เมื่อไฟล์ ignore หรือ rignore เปลี่ยนจริงเท่านั้น ตั้งเวลาให้รันวันละครั้งตอนเช้ามืด หน้าตาของไฟล์ปลายทางหลังสคริปต์เขียนแล้วเป็นแบบนี้ ส่วนที่คนเขียนเองอยู่เหนือบล็อก ส่วนที่สคริปต์เขียนอยู่ในบล็อก
# /etc/csf/csf.ignore  (ตัวอย่างกลางๆ)
127.0.0.1
# BEGIN bot-allowlist (managed) -- อย่าแก้ในบล็อกนี้ ไปแก้ที่ sources.conf
198.51.100.0/25      # tool-c
203.0.113.0/24       # search-a
# END bot-allowlist (managed)
import re

BEGIN = "# BEGIN bot-allowlist (managed)"
END   = "# END bot-allowlist (managed)"

def replace_block(text: str, lines: list[str]) -> str:
    block = BEGIN + "\n" + "\n".join(lines) + "\n" + END
    pat = re.compile(re.escape(BEGIN) + r".*?" + re.escape(END), re.S)
    return pat.sub(lambda m: block, text) if pat.search(text) else text.rstrip("\n") + "\n" + block + "\n"
# crontab ของ root  (ใช้พาธเต็มทั้งหมด)
20 4 * * * /usr/local/sbin/allowlist-sync.py >> /var/log/allowlist-sync.log 2>&1
มีเรื่องหนึ่งที่ผมเจอระหว่างทำรอบนี้ ตัวสคริปต์รุ่นแรกเรียก csf แบบไม่มีพาธเต็ม ซึ่งใน cron ไม่เจอเพราะ PATH ของ cron ไม่มี /usr/sbin ขั้นสแกน temp ban กับขั้น unban เลยล้มเงียบทุกวัน เหลือแค่บรรทัด WARN ในล็อก แก้ด้วยการใช้พาธเต็ม เรื่อง PATH ของ cron ผมเขียนไว้แล้วใน cron ที่ล้มเงียบเพราะ redirect ล็อก ตรงนี้เลยพูดแค่ประโยคเดียว
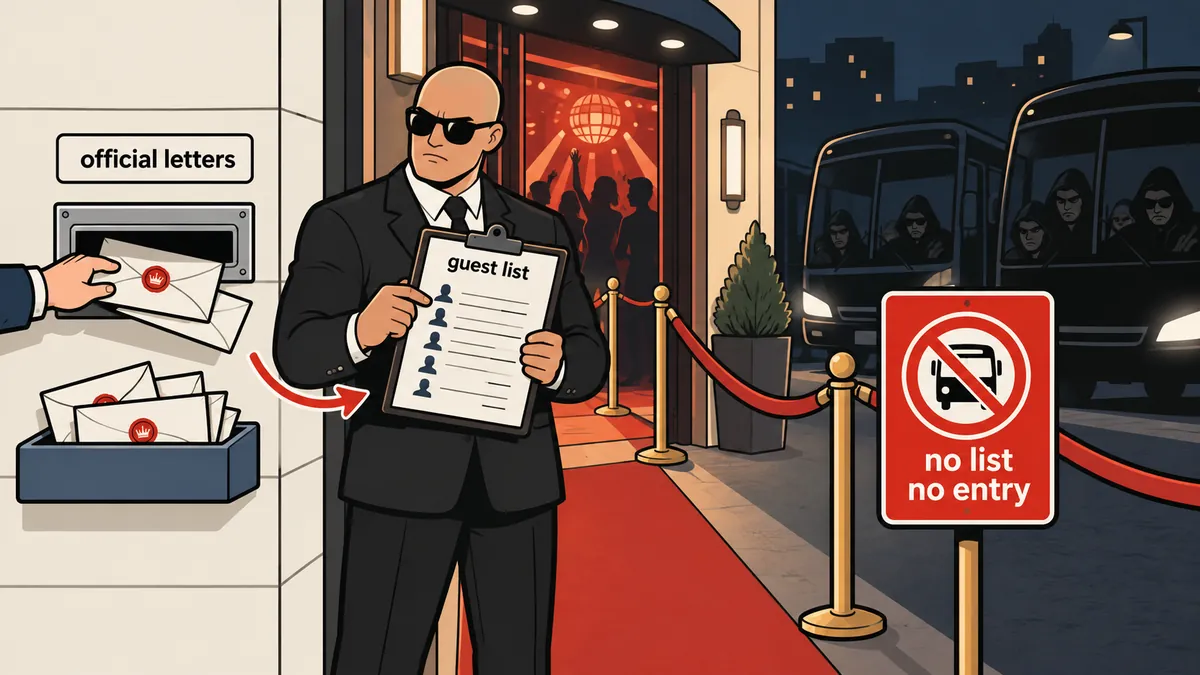
ที่ไม่ใส่ สำคัญเท่ากับที่ใส่
รายการอนุญาตที่ยาวขึ้นเรื่อยๆ โดยไม่มีใครถามว่า "ทำไมต้องใส่" คือรายการที่สักวันจะมีคนแปลกหน้าอยู่ข้างใน ผมเลยเขียนกฎเลือกไว้ในคอมเมนต์ของไฟล์ และตัวเองยึดตามนั้นทุกครั้งที่จะเพิ่มบรรทัด
ส่วนตัวผมยึดสามข้อ ข้อแรก ใส่เฉพาะเจ้าที่เผยแพร่รายการทางการเอง หรือเป็นเครือข่ายของเขาเอง ข้อสอง ถ้าช่วง IP นั้นเป็นของแพลตฟอร์มคลาวด์ที่ลูกค้าทุกคนรันโค้ดได้ ไม่ใส่ เพราะการอนุญาตทั้งช่วงคือการอนุญาตคนแปลกหน้า ตัวอย่างที่ชัดคือ fetcher ที่รันบนแพลตฟอร์มแอปของคลาวด์เจ้าใหญ่ซึ่งใครก็เช่าได้ ข้อสาม เจ้าที่ไม่มีทั้งรายการ IP ไม่มี rDNS ให้ตรวจ ไม่ใส่ จะเสียดายแค่ไหนก็ตาม
ส่วน crawler ที่เก็บข้อมูลไปฝึกโมเดลอย่างเดียว ผมปิดบรรทัดไว้ตั้งใจ แต่เก็บบรรทัดไว้ในไฟล์ในรูปคอมเมนต์ เพื่อวันหน้าถ้าเปลี่ยนใจแค่เอา # ออก ตามใจเจ้าของเว็บเลยว่าจะเปิดหรือปิด ผมแค่ไม่อยากให้เป็นการเปิดโดยไม่ได้ตัดสินใจ
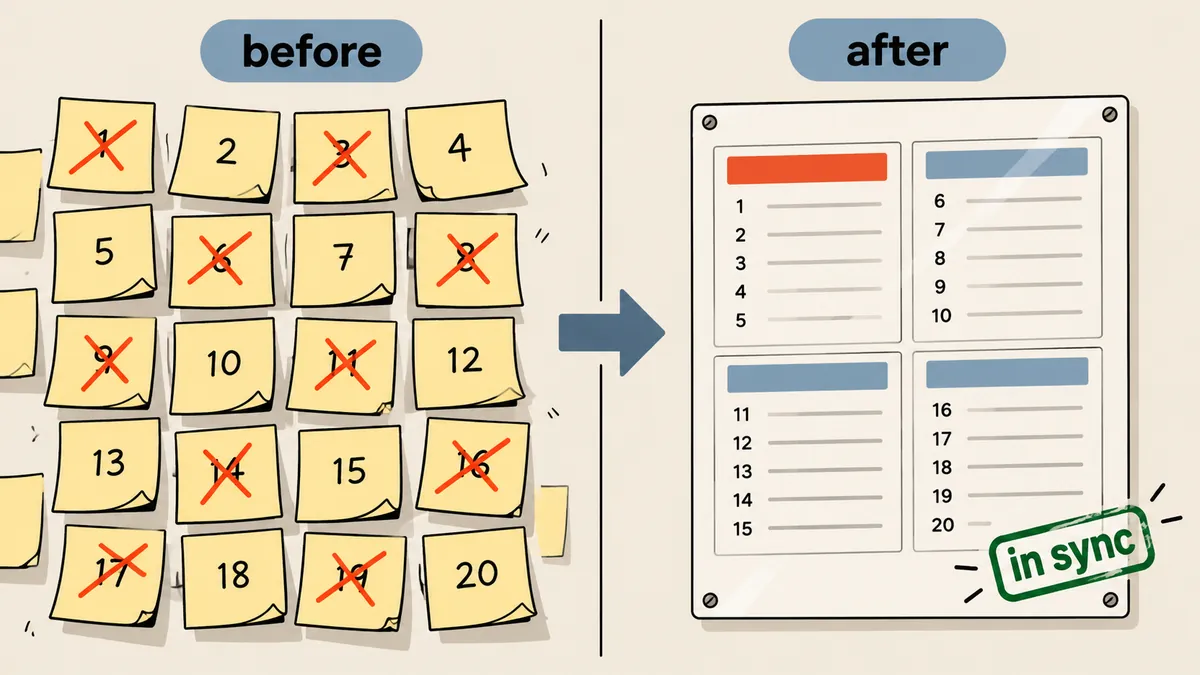
Cloudflare ต้องอยู่ csf.ignore ไม่ใช่ csf.allow
นี่คือข้อที่ผมอยากให้คนจำไปที่สุด ทั้งสองไฟล์ดูเหมือนทำสิ่งเดียวกันคือ "อย่าแบน IP นี้" แต่ความหมายต่างกันมาก
แค่ไม่แบน
lfd จะไม่บล็อก IP นี้เวลาเจอพฤติกรรมน่าสงสัย แต่ไฟร์วอลล์ยังใช้กฎเดิม พอร์ตที่ปิดอยู่ก็ยังปิดสำหรับ IP นี้
เปิดทุกพอร์ต
ไฟร์วอลล์ปล่อย IP นี้เข้าได้ทุกพอร์ต รวมถึง SSH และพอร์ตจัดการอื่นๆ
# /etc/csf/csf.ignore   lfd ไม่แบน แต่พอร์ตยังเป็นไปตามกฎเดิม
203.0.113.0/24

# /etc/csf/csf.allow    เปิดทุกพอร์ตให้ IP นี้  <-- ห้ามใส่ edge ของ CDN ที่นี่
# 203.0.113.0/24
เหตุผลที่ edge ของ Cloudflare ต้องอยู่ฝั่ง ignore คือ Cloudflare Workers เปิดการเชื่อมต่อ TCP ขาออกไปที่โฮสต์และพอร์ตไหนก็ได้ ถ้าใส่ช่วง IP ของ Cloudflare ไว้ใน csf.allow ก็เท่ากับว่าใครก็ตามที่เขียน Worker แล้วเชื่อมต่อออกมา จะต่อเข้าพอร์ต SSH ของเซิร์ฟเวอร์เราได้จากที่อยู่ที่ไฟร์วอลล์ไว้ใจ ส่วน csf.ignore ที่ไม่เปิดพอร์ตอะไรเพิ่มปลอดภัยกว่าเป็นคนละเรื่อง ผมเลยทำให้เป็นกฎในไฟล์ config ว่าแหล่งชนิดนี้ไปได้ทางเดียว
ถ้ารายการ IP ที่ไว้ใจมาจากเครือข่ายที่คนทั่วไปเช่าใช้ได้ เช่น CDN แพลตฟอร์มคลาวด์ หรือบริการ serverless อย่าใส่ใน csf.allow เด็ดขาด ใช้ csf.ignore เท่านั้น แล้วอย่าลืมว่าไฟล์นี้เป็นนโยบายของเซิร์ฟเวอร์หนึ่งเครื่อง ก่อนนำไปใช้กับเครื่องอื่นต้องอ่านเอกสารของ CSF และทดสอบให้เข้าใจพฤติกรรมก่อน
อีกเรื่องที่ควรรู้ ผู้ใช้ VPN สำหรับผู้บริโภคบางเจ้าออกอินเทอร์เน็ตผ่านที่อยู่ของ Cloudflare เหมือนกัน ผมเคยเห็น temp ban บนที่อยู่ที่ดูเป็นของ Cloudflare ตรวจแล้วเป็นผู้ใช้ VPN ที่ยิง xmlrpc รัวจนโดนกฎกันฟลัด ซึ่งก็ถูกต้องแล้ว ผมเลยปล่อยให้แบนต่อ ไม่ไปขุดออก การไม่แบน IP ของ edge เลยไม่ได้แปลว่าไม่แบนคนข้างหลัง edge ทั้งหมด
ซิงก์รายการ real_ip ของ nginx ให้ตรงกับของจริง
อีกขั้นที่รันรายวันคู่กันคือรายการช่วง IP ของ Cloudflare ที่ nginx ใช้ตั้ง set_real_ip_from เพื่อให้เห็น IP ของผู้เยี่ยมชมจริง ไฟล์นี้ปกติเขียนโดยระบบ build ของแผงควบคุมและจะถูกเขียนใหม่ทุกครั้งที่ build ถ้า Cloudflare ประกาศช่วงใหม่ ไฟล์ก็ตกรุ่นโดยไม่มีใครรู้ ผมเลยเขียนสคริปต์เล็กที่เทียบช่วงที่ประกาศอยู่กับไฟล์ ถ้าไม่ต่างก็พิมพ์ว่า in sync แล้วจบ ถ้าต่างถึงเขียนไฟล์ใหม่ แล้วต้องผ่าน nginx -t ถึงจะ reload ไม่ผ่านก็คืนไฟล์เดิมทันที
#!/bin/bash
# sync-realip.sh  (ตัวอย่างกลางๆ) เขียนไฟล์ใหม่เฉพาะเมื่อชุดช่วง IP เปลี่ยนจริง
set -euo pipefail
CONF=/etc/nginx/realip-edge.conf
NEW=$(mktemp)

{ curl -fsS https://cdn-f.example/v4.txt; echo; curl -fsS https://cdn-f.example/v6.txt; echo; } \
  | grep -E '^[0-9a-f:.]+/[0-9]+$' | sort -u | sed 's/^/set_real_ip_from /; s/$/;/' > "$NEW"

[ "$(wc -l < "$NEW")" -ge 10 ] || { echo "too few ranges, abort"; exit 1; }

if diff -q <(sort "$CONF") <(sort "$NEW") >/dev/null; then echo "in sync"; exit 0; fi

cp -a "$CONF" "$CONF.bak"
install -m 644 "$NEW" "$CONF"
if nginx -t 2>/dev/null; then systemctl reload nginx; echo "updated"
else cp -a "$CONF.bak" "$CONF"; echo "nginx -t failed, restored"; exit 1; fi
สังเกตว่าด่านจำนวนขั้นต่ำเป็นหลักการเดียวกับ min=N ข้างบน คือแหล่งที่ดึงมาเสียต้องไม่ถูกเขียนทับของที่ใช้ได้ ผมใช้หลักนี้ซ้ำกับทุกสคริปต์ที่แก้ค่าของเครื่องจริง
ผลตรวจวันแรกหลังเปิดใช้
หลังเปิดใช้ผมสุ่มดู log ทั้งวันเพื่อเช็กว่ารายการใหม่ไม่ได้เปิดช่องให้ใครโดยไม่ตั้งใจ เจอสิ่งที่น่าสนใจสองข้อ
- มีคำขอจำนวนหนึ่งต่อวันที่อ้างตัวเป็น Googlebot แล้วถูก ModSecurity ตอบ 406 ทั้งหมด พอไล่ดูต้นทางเป็นช่วง IP ของ VM บนคลาวด์ที่กวาดหาไฟล์
.envกับ.htpasswdซึ่งถูกบล็อกถูกต้องแล้ว ส่วน Googlebot ตัวจริงโดน ModSecurity แค่ครั้งเดียว และ sitemap ตอบ 200 - ไวต์ลิสต์หยุดแค่การแบนด้วย IP เท่านั้น ModSecurity ยังตรวจทุกคำขออยู่เหมือนเดิม ซึ่งเป็นสิ่งที่ผมต้องการ
- แก้ไฟล์
sources.confเพิ่มหรือคอมเมนต์บรรทัด พร้อมเขียนเหตุผลไว้ในคอมเมนต์เหนือบรรทัด - รันสคริปต์ด้วย
--dry-runดูว่าจำนวนช่วง IP ต่อแหล่งสมเหตุสมผล - ตรวจว่าไม่มีแหล่งไหนถูกรายงานว่า keep yesterday โดยไม่คาดคิด
- รันจริงหนึ่งรอบ แล้วดูว่า lfd restart เฉพาะเมื่อไฟล์เปลี่ยนจริง
- เปิดล็อกวันถัดไป ดูคำขอที่อ้างตัวเป็นบอตแต่โดน 406 ว่ามาจากช่วง IP ที่เราตั้งใจไม่ไว้ใจหรือเปล่า
ถ้าเทียบกับ ไวต์ลิสต์ของเมล ที่ผมเขียนไว้ก่อนหน้า อันนั้นเป็นอีกเรื่อง คือยอมให้ผู้ส่งเมลที่ถูกต้องผ่าน ส่วนบทความนี้พูดถึงเฉพาะบอตเว็บ
สรุปแบบสั้นที่สุด ผมว่ารายการอนุญาตที่ดีต้องมีสามอย่างครับ คือเขียนที่เดียว มีเหตุผลกำกับทุกบรรทัด และมีกฎชัดว่าอะไรไม่อนุญาต ส่วนวิธีแบ่งหมวดหรือตั้ง min เท่าไหร่ ตามความเหมาะสมของแต่ละเครื่องได้เลย เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย