ต่อคลิป 33 ช่วงให้ได้ 5,784 เฟรมพอดี ภาพไม่เลื่อนจากเสียง
ภาพที่เลื่อนจากเสียงทีละนิดไม่ได้เกิดจาก encoder แต่เกิดจากการปัดเศษความยาวทีละท่อนแล้วปล่อยให้มันสะสม ถ้าปัดที่ขอบสะสมแทน ผลรวมจะเท่ากับจำนวนเฟรมที่ควรเป็นเสมอ
สรุปใน 1 นาที
- อาการ/ปัญหา
- ต่อคลิป 33 ท่อนที่ 30 fps แล้วภาพเลื่อนจากเสียงสะสมทีละนิด
- ใครควรอ่าน
- คนตัดต่อวิดีโอด้วย ffmpeg แบบสคริปต์
- ทางแก้แบบสั้น
- ปัดขอบตัดเป็นเฟรมก่อน encode ทีละท่อนด้วย -frames:v ต่อแบบ concat copy ผสมเสียงด้วย amix normalize=0 และ assert ทุกขั้น
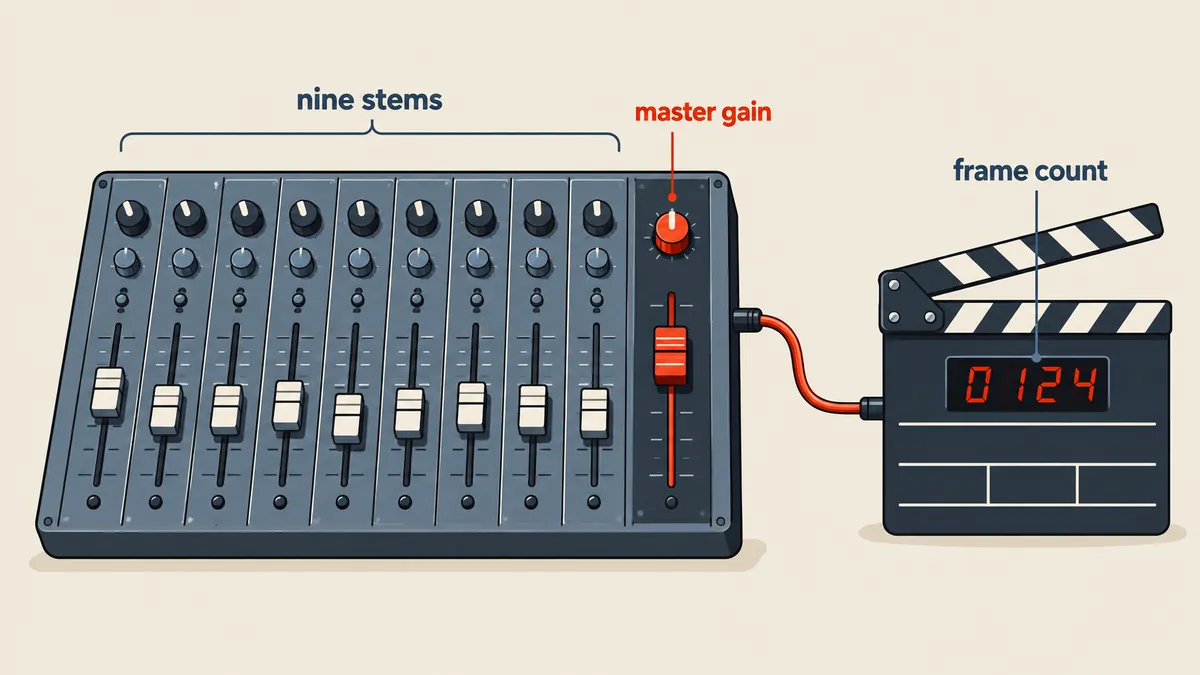
พอดีผมต้องต่อวิดีโอพรีวิวของเพลงตัวอย่างหนึ่งเพลง ความยาว 192.800 วินาที ที่ 30 fps คือ 5,784 เฟรมพอดี แบ่งเป็น 33 ท่อนตามแผนตัด แล้ววางเสียงที่ผสมจากสเต็ม 9 ชิ้นทับ งานแบบนี้ถ้าทำตามสัญชาตญาณคือ ตัดทีละท่อนตามความยาวทศนิยม ใส่ -t แล้วค่อยต่อกัน วิธีนี้คลาดสะสมได้ตามคณิตศาสตร์ยิ่งท่อนเยอะยิ่งเลื่อนจากเสียง ผมเลยวางสูตรใหม่ที่ทุกขั้นมี assert กำกับ แล้วเขียนสรุปไว้ตรงนี้
ผมไม่ได้เล่าที่มาของภาพต้นทางหรือรายละเอียดของแผนตัด เอาเฉพาะตัวเลขกับวิธี และตัวเลขความคลาดสะสมที่เอามาเปรียบเทียบในบทความนี้เป็นผลการจำลองเพื่อประกอบคำอธิบาย ไม่ใช่ค่าที่ผมวัดจากงานจริง
ปัญหา: ปัดความยาวทีละท่อนแล้วคลาดสะสม
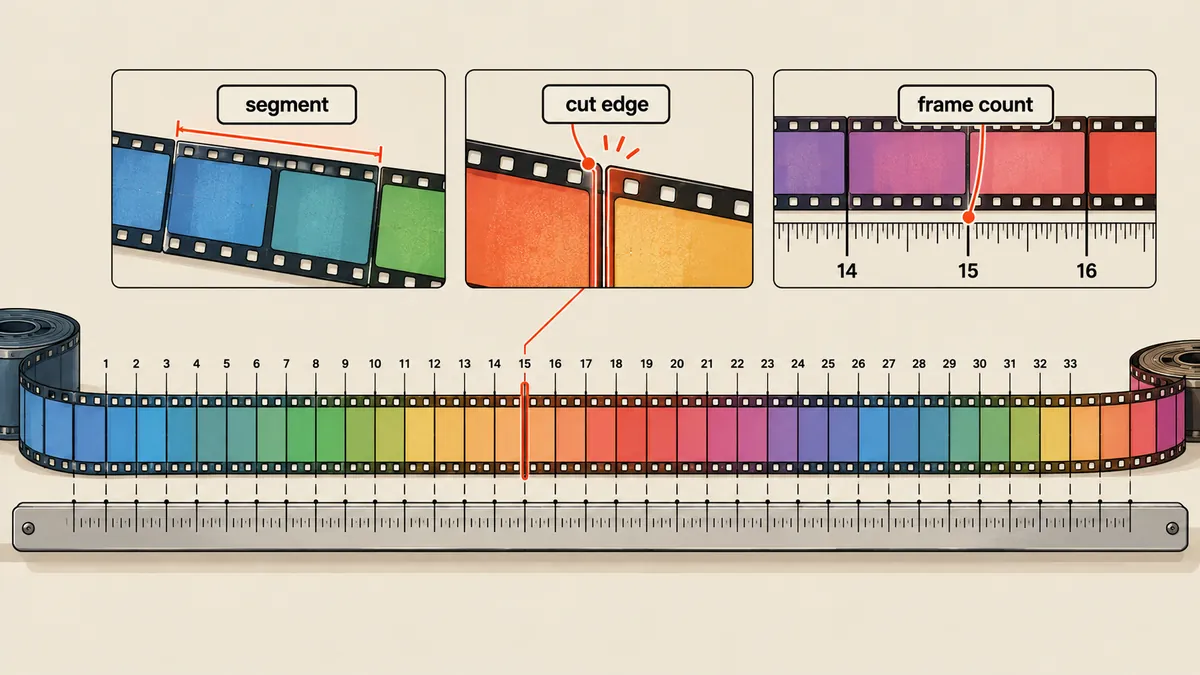
สมมติแผนตัดมีขอบที่ 0, 1.016, 2.032 และ 3.048 วินาที ที่ 30 fps แต่ละท่อนยาว 1.016 x 30 = 30.48 เฟรม ถ้าปัดความยาวทีละท่อนจะได้ท่อนละ 30 เฟรม รวมสามท่อน 90 เฟรม แต่เวลาจริง 3.048 วินาทีคือ 91.44 เฟรม ซึ่งปัดแล้ว 91 เฟรม เลยขาดไปหนึ่งเฟรมตั้งแต่ท่อนที่สาม ท่อนที่เหลือก็ต่อท้ายจากจุดที่คลาดแล้วเรื่อย ๆ
ผมเลยจำลองดูว่าคลาดได้แค่ไหนด้วยสคริปต์สั้น ๆ สุ่มขอบ 32 จุดในช่วง 192.8 วินาที ปัดความยาวทีละท่อนที่ 30 fps แล้วเทียบกับ 5,784 เฟรม ทำซ้ำ 20,000 รอบ
import random, statistics as st

random.seed(1)
FPS, TOTAL = 30, 5784
drift = []
for _ in range(20000):
    cuts = sorted(random.uniform(0, 192.8) for _ in range(32))
    edges = [0.0] + cuts + [192.8]
    naive = sum(round((edges[i + 1] - edges[i]) * FPS) for i in range(33))
    drift.append(naive - TOTAL)

print('sd', round(st.pstdev(drift), 2), 'max', max(abs(d) for d in drift))
ผมรันได้ค่าเบี่ยงเบนมาตรฐานประมาณ 1.67 เฟรม และค่าสัมบูรณ์สูงสุดในรอบจำลองทั้งหมด 6 เฟรม ตรงกับที่คำนวณด้วยมือว่า sqrt(33) x 0.29 ได้ประมาณ 1.7 เฟรม หรือราว 56 มิลลิวินาที ความคลาดระดับนี้คนฟังเพลงจับได้ถ้าภาพเป็นจังหวะกลองตรง ๆ และยังไม่นับว่า movie timescale ค่าเริ่มต้นของ ffmpeg ปัดความยาวคอนเทนเนอร์อีกชั้น (เรื่องนั้นอยู่ใน บทความเรื่อง timescale)
สูตรปัดขอบสะสม
หลักคือปัดที่ "ขอบ" ไม่ใช่ที่ "ความยาว" แปลงขอบทุกจุดของแผนตัดเป็นเลขเฟรมก่อน แล้วความยาวของแต่ละท่อนคือผลต่างของขอบสองจุดที่ติดกัน
from fractions import Fraction

FPS = 30
DURATION = Fraction(1928, 10)            # 192.8 วินาที
TOTAL = round(DURATION * FPS)            # 5784

def plan_frames(cuts):
    """cuts = [{'start': Fraction, 'end': Fraction, 'in': Fraction}, ...]"""
    out = []
    for c in cuts:
        fs, fe = round(c['start'] * FPS), round(c['end'] * FPS)
        out.append({**c, 'fs': fs, 'fe': fe, 'count': fe - fs,
                    # ขยับจุดเริ่มในไฟล์ต้นทางให้ตรงกับเฟรมที่ปัดแล้ว
                    'src_in': c['in'] + Fraction(fs, FPS) - c['start']})
    for a, b in zip(out, out[1:]):
        assert a['fe'] == b['fs'], 'ขอบท่อนต่อกันไม่สนิท'
    assert out[0]['fs'] == 0
    assert sum(p['count'] for p in out) == TOTAL == out[-1]['fe']
    assert all(p['src_in'] >= 0 for p in out), 'จุดเริ่มต้นทางติดลบ'
    return out
มีสองเรื่องที่ผมจงใจเขียนแบบนี้ ข้อแรก ใช้ Fraction ไม่ใช้ float เพื่อไม่ให้ขอบที่ควรอยู่กึ่งกลางเฟรมพอดีเพี้ยนไปด้วยเศษทศนิยม และต้องรู้ไว้ว่า round ของ Python ปัดค่ากึ่งกลางเข้าหาเลขคู่ ข้อสอง src_in คือการชดเชยเมื่อขอบถูกปัดไปทางเฟรมเต็ม ตำแหน่งเริ่มอ่านจากไฟล์ต้นทางต้องขยับตามเท่ากันเพื่อให้เนื้อภาพตรงเวลาเดิม ไม่ใช่เริ่มอ่านที่ตำแหน่งเดิมแล้วเลื่อนทั้งท่อน
คลาดสะสมแบบสุ่ม
แต่ละท่อนคลาดได้ไม่เกินครึ่งเฟรม แต่ 33 ท่อนบวกกันแล้วไม่มีอะไรดึงกลับ ผลรวมอาจเป็น 5,781 หรือ 5,787 ก็ได้ ต้องมาเลื่อนเสียงแก้ทีหลัง
ผลรวมคงที่โดยโครงสร้าง
ความคลาดของท่อนหนึ่งถูกชดเชยด้วยท่อนถัดไปเสมอ ผลรวมเท่ากับ round(ความยาว x fps) ทุกครั้ง และ assert จับได้ทันทีถ้าขอบไม่ต่อกัน
encode ทีละท่อนด้วย -frames:v
ความยาวของแต่ละท่อนผมสั่งด้วยจำนวนเฟรม ไม่ใช้ -t ภาพต้นทางของงานนี้เป็น 1280x720 ขยายเป็น 1920x1080 ด้วย Lanczos ซึ่งแค่ปรับขนาด ไม่ได้เพิ่มรายละเอียดอะไร และเสียงจากคลิปต้นทางทิ้งทั้งหมดด้วย -an เพราะเสียงจริงมาจากไฟล์มิกซ์แยก
ffmpeg -ss "$SRC_IN" -i src.mp4 -an \
  -vf "setpts=PTS-STARTPTS,scale=1920:1080:flags=lanczos,setsar=1,fps=30,tpad=stop_mode=clone:stop_duration=0.10" \
  -frames:v "$COUNT" \
  -c:v h264_nvenc -preset p5 -cq 18 -b:v 0 -pix_fmt yuv420p \
  -colorspace bt709 -color_trc bt709 -color_primaries bt709 \
  -video_track_timescale 30000 -movie_timescale 30000 part.mp4
tpad ที่ clone เฟรมสุดท้ายต่อท้าย 0.1 วินาที กันกรณีไฟล์ต้นทางสั้นกว่าที่คิดไปสักเฟรม แล้ว -frames:v เป็นตัวตัดให้เหลือจำนวนที่ต้องการพอดี พอเสร็จแต่ละท่อนผมตรวจทันที
| รายการที่ assert | เกณฑ์ |
|---|---|
| nb_frames | เท่ากับ COUNT |
| duration | ผลต่างกับ COUNT/30 น้อยกว่า 1e-6 |
| start_time | ค่าสัมบูรณ์น้อยกว่า 1e-6 |
ท่อนที่มีไฟล์อยู่แล้วและผ่านการตรวจจะถูกข้าม และสคริปต์เขียน progress.json ทีละท่อน render ที่ค้างกลางทางเลยกลับมาทำต่อได้ ผมลองสูตรเดียวกันนี้กับไฟล์ทดลอง 4 ท่อน (31, 59, 45, 83 เฟรม) ได้ nb_frames ตรงทุกท่อน start_time เป็น 0 และ duration_ts เป็น 31000, 59000, 45000 กับ 83000 ที่ time_base 1/30000 คือหนึ่งเฟรมเท่ากับ 1000 tick ตามคาด
- แปลงขอบทุกจุดของแผนตัดเป็นเลขเฟรมสะสมด้วย Fraction แล้ว assert ว่าขอบต่อกันสนิทและผลรวมเท่ากับ 5,784
- encode ทีละท่อนด้วย -frames:v ตามจำนวนเฟรมที่คำนวณ ไม่ใช้ -t
- ตรวจ nb_frames, duration และ start_time ของทุกท่อนก่อนไปขั้นถัดไป
- ต่อด้วย concat demuxer แบบ copy แล้วใส่เสียงมิกซ์
- assert ไฟล์สุดท้าย 5,784 เฟรม วิดีโอคลาดไม่เกิน 1e-6 วินาที เสียงคลาดไม่เกิน 25 มิลลิวินาที
ต่อด้วย concat demuxer แบบ copy
ท่อนทุกชิ้นถูก encode ด้วยพารามิเตอร์เดียวกัน (ขนาด, pixel format, timescale 30000) การต่อเลยใช้ concat demuxer แบบ -c copy ได้โดยไม่ต้อง encode ซ้ำ ไฟล์ list บรรทัดละ file 'path' แล้วใส่เสียงมิกซ์เข้าไปพร้อมกัน
ffmpeg -f concat -safe 0 -i list.txt -i mix.wav \
  -map 0:v:0 -map 1:a:0 \
  -c:v copy -c:a aac -b:a 320k -ar 48000 \
  -t 192.8 -movflags +faststart -movie_timescale 30000 out.mp4
ผมลองบนไฟล์ทดลองสี่ท่อนข้างบน ได้วิดีโอ 218 เฟรม (31 + 59 + 45 + 83) พอดี time_base 1/30000 และ mvhd เป็น timescale 30000 ตามที่สั่ง ซึ่งเป็นผลที่ตั้งใจจากเรื่อง movie timescale ที่เล่าในบทความพี่น้อง
สิ่งที่ต้องรู้ในขั้นสุดท้ายคือเสียง AAC เป็นบล็อกละ 1,024 ซัมเปิล ราว 21.3 มิลลิวินาทีที่ 48 kHz ความยาวของแทร็กเสียงเลยไม่ลงล็อกกับ 192.8 วินาทีเป๊ะเหมือนวิดีโอ ผมเลยตั้ง assert แยกกัน วิดีโอต้องคลาดไม่เกิน 1e-6 วินาที ส่วนเสียงยอมได้ 25 มิลลิวินาที ซึ่งมากกว่าหนึ่งบล็อก AAC เล็กน้อย
เกณฑ์ 25 ms เป็นของเสียงเท่านั้น เพราะ AAC ตัดเป็นบล็อก ถ้าเอาเกณฑ์นี้ไปใช้กับวิดีโอด้วย จะมองไม่เห็นเฟรมที่หายไปหนึ่งเฟรม (33.3 ms) ซึ่งเป็นความผิดพลาดที่ assert นี้มีไว้จับโดยตรง
ผสมเสียง 9 สเต็มโดยไม่ให้ระดับเพี้ยน
เสียงมาจากสเต็ม WAV 9 ชิ้นที่ 48 kHz ผมรวมด้วย amix แต่ต้องตั้ง normalize=0 เพราะค่าเริ่มต้นของ amix จะหารระดับเสียงตามจำนวนอินพุต ผลคือเสียงที่ผสมเบาและเพี้ยนไปจากที่ฟังในพรีวิว
ffmpeg $(printf -- '-i %s ' stems/*.wav) \
  -filter_complex "amix=inputs=9:duration=longest:dropout_transition=0:normalize=0,volume=0.885369738339" \
  -c:a pcm_s24le mix.wav
ตัวเลข 0.885369738339 คำนวณจาก min(1, 0.95 / peak) โดย peak ของผลรวมทุกชิ้นที่ไม่หารเท่ากับ 1.073 ถ้าไม่ลดจะเกิน 0 dBFS และแตก master gain ตัวเดียวเลยดึงให้พีคอยู่ที่ 0.95 โดยไม่เปลี่ยนสัดส่วนระหว่างชิ้น ผมเขียนผลลัพธ์เป็น pcm_s24le ก่อนค่อยเข้ารหัส AAC เพื่อไม่ให้ผ่านการบีบอัดสองรอบ
ตัวเลือก normalize ของ amix ต้องใช้ ffmpeg รุ่นใหม่ ผมตรวจว่าเครื่องผมรับตัวเลือกนี้ได้โดยรันกับไฟล์ sine ทดลองสองไฟล์ ใครใช้รุ่นเก่าให้ตรวจรุ่นก่อนใช้
ผลสุดท้ายและสิ่งที่ยังไม่รู้
ไฟล์สุดท้ายเป็น H.264 จาก NVENC กับ AAC 320 kbps 48 kHz stereo ขนาด 220,142,411 ไบต์ คิดเป็นบิตเรตรวมประมาณ 9.1 Mbps (ส่วนวิดีโออย่างเดียวประมาณ 8.8 Mbps) ffprobe ของไฟล์สุดท้ายให้ค่าตามนี้
{
  "time_base": "1/30000",
  "duration_ts": 5784000,
  "nb_frames": "5784",
  "start_time": "0.000000"
}
5,784,000 หารด้วย 30,000 ได้ 192.8 วินาทีพอดี และ 5,784,000 หารด้วย 1,000 tick ต่อเฟรมได้ 5,784 เฟรม สองตัวเลขสอดคล้องกันโดยไม่ต้องปัดเศษ
สิ่งที่ผมยังไม่ได้ทำคืออ่านค่าความคลาดการปัดขอบสูงสุดของงานจริง ที่สคริปต์บันทึกไว้ในไฟล์ render-job ผมเลยบอกได้เพียงว่ามันไม่เกินครึ่งเฟรม คือ 16.7 มิลลิวินาที ตามนิยามของการปัดขอบ และเพราะผมเก็บ assert ไว้ทุกขั้น ถ้ามีท่อนไหนหลุดเกณฑ์ สคริปต์จะหยุดตั้งแต่ท่อนนั้น ตรงไหนที่ผมอธิบายตกหล่นหรือใช้กับ ffmpeg รุ่นอื่นแล้วผลไม่ตรง เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย