AI หลายตัวแก้เว็บพร้อมกัน: ประกาศ scope รอคิว merge 3 ทาง
สองงานที่แก้ไฟล์เดียวกันพร้อมกันไม่ต้องมีใครพลาดก็ทับกันได้ ผมเลยเลิกพึ่งความหวังว่าโมเดลจะระวังเอง แล้วบังคับด้วยการประกาศพื้นที่ล่วงหน้า ตัวล็อกที่เป็นโค้ด และการรวมแบบสามทางสำหรับไฟล์ที่หลีกเลี่ยงไม่ได้
สรุปใน 1 นาที
- อาการ/ปัญหา
- หลายคนสั่ง AI worker แก้เว็บเดียวกันพร้อมกัน ถ้าสองงานแก้ไฟล์เดียวกันจะทับกันเงียบ ๆ
- ใครควรอ่าน
- คนที่ให้ AI worker หลายตัวแก้เว็บหรือ repo เดียวกันพร้อมกัน
- ทางแก้แบบสั้น
- ทำ dispatcher บน SQLite ให้แต่ละงานประกาศ scope ล่วงหน้า งานที่ชนต้องรอ มี hook ขอ claim ก่อนเขียนไฟล์ และไฟล์ร้อนให้รวมด้วย git merge-file แบบ 3 ทาง
พอดีเว็บลูกค้ารายหนึ่งของผมเปิดให้หลายคนสั่ง AI worker แก้เว็บได้ ทั้งผ่านหน้าแอดมินและผ่านแชท ผมเลยนั่งคิดภาพที่จะเกิดถ้าสองคนสั่งงานเกือบพร้อมกัน คนหนึ่งให้แก้หน้ารีวิว อีกคนให้แก้ข้อความในหน้าเดียวกันคนละส่วน ถ้างานที่เสร็จทีหลังเขียนไฟล์ทับของงานที่เสร็จก่อน มันจะทับกันเงียบ ๆ ไม่มี error ไม่มี log เตือนอะไรเลย และกว่าจะรู้ก็ตอนมีคนถามว่าทำไมที่แก้ไปเมื่อเช้าหายไป ผมเลยไม่รอให้เกิดแล้วค่อยแก้ เรื่องแบบนี้ผมเคยเล่าที่ระดับ git ไว้แล้วใน ตอนงานหายเงียบเมื่อหลาย agent ใช้ working tree เดียว แต่บทนี้เป็นอีกชั้น คือตัวจัดคิวที่ดูจากพื้นที่ที่แต่ละงานจะแตะ ไม่ใช่ที่ git
ชื่อไฟล์ ชื่อระเบียน และรหัสในตัวอย่าง (เช่น item:P017, page:about) เป็นของสมมติทั้งหมดเพื่อให้เห็นรูปแบบ ไม่ใช่ของจริงของลูกค้า ส่วนชื่อ worker ผมเรียกรวมว่า worker แบบแก้เว็บ
โจทย์ที่ผมตั้ง สามข้อ
ผมนั่งเขียนสิ่งที่ต้องการออกมาก่อนเป็นสามข้อ ข้อแรกคืองานที่ชนกันห้ามรันพร้อมกัน ข้อสองคือไม่อยากให้ทุกงานต้องต่อคิวยาวเพราะไฟล์ร่วมที่ทุกงานต้องแตะ และข้อสามคือถ้าชนกันจริงต้องมีการรวม ไม่ใช่การทับ
ปลอดภัย แต่ทำงานทีละงาน
ง่ายที่สุดคือให้รันทีละงาน ไม่มีอะไรทับกันเลย แต่เจ้าของเว็บสองคนที่แก้คนละหน้าต้องรอกันโดยไม่มีเหตุผล และยิ่งมีคนสั่งมากคิวยิ่งยาว
รันขนานเฉพาะงานที่ไม่ชน
ให้แต่ละงานบอกก่อนว่าจะแตะอะไร งานที่ไม่แตะของเดียวกันรันพร้อมกันได้ งานที่ชนต้องรอ แลกกับการที่ต้องมีตัวบังคับที่เป็นโค้ด เพราะเชื่อโมเดลอย่างเดียวไม่ได้
ส่วนตัวผมเลือกแบบประกาศ scope และถือหลักว่า ประกาศล่วงหน้าถูกกว่าตรวจทีหลัง แต่ประกาศอย่างเดียวไม่พอ ต้องมี hook ที่บังคับตอนเขียนไฟล์จริง ไม่งั้นโมเดลที่เผลอแตะไฟล์นอกขอบเขตก็ยังทับของคนอื่นได้อยู่ดี
Scope คือ path กับ record
scope ของงานหนึ่งเขียนเป็น JSON มีสองส่วน paths คือรายการ glob สัมพัทธ์กับตัวแอป และ records คือรายการระเบียนข้อมูลในรูป "โมเดล:รหัส" เพราะงานแก้เว็บไม่ได้แก้แค่ไฟล์ บางงานแก้ข้อมูลในฐานข้อมูลที่หน้าเว็บอ่านไปแสดง
{
  "paths": [
    "resources/views/reviews/**",
    "app/Http/Controllers/ReviewController.php"
  ],
  "records": ["item:P017", "page:about"]
}
กติกาการตีความที่ผมกำหนดมีดังนี้ path ที่ไม่มี wildcard หมายถึงไฟล์นั้นและทุกอย่างใต้โฟลเดอร์นั้น เครื่องหมาย * อยู่ในระดับโฟลเดอร์เดียว ** ข้ามโฟลเดอร์ได้ ? คือหนึ่งตัวอักษร และ [...] คือเซตตัวอักษร ส่วน records ใช้ตัวพิมพ์เล็ก และ "model:" แปลว่าทุกระเบียนของโมเดลนั้น มีตาราง alias ปรับรูปที่คนมักเขียนต่างกัน (เช่น articles กับ blog) ให้ตรงกันก่อนเทียบ ถ้า scope เป็นค่าว่าง หรือ "" หรือเขียนว่าทั้งเว็บ งานนั้นรันคนเดียว
สองรูปแบบ "ชนกัน" เมื่อมีไฟล์ไฟล์หนึ่งที่เข้าได้ทั้งคู่ ผมเลือกเทียบแบบอยู่ฝั่งปลอดภัย ถ้ามี wildcard ทั้งสองฝั่งก็เทียบแค่ส่วนที่เป็นตัวอักษรตรง ๆ ด้านหน้า ถ้าไม่แน่ใจให้ถือว่าชน เสียแค่รอนานขึ้น ดีกว่าทับกัน
import re

def to_re(p: str) -> str:
    out, i = "", 0
    while i < len(p):
        if p[i:i+2] == "**": out += ".*"; i += 2
        elif p[i] == "*":    out += "[^/]*"; i += 1
        elif p[i] == "?":    out += "[^/]"; i += 1
        else:                out += re.escape(p[i]); i += 1
    return out

def has_wild(p): return any(c in p for c in "*?[")
def lit_prefix(p): return re.split(r"[*?\[]", p, 1)[0]
def parents(p):
    parts = p.split("/")
    return ["/".join(parts[:i]) for i in range(1, len(parts) + 1)]

def overlap(a: str, b: str) -> bool:
    a, b = a.rstrip("/"), b.rstrip("/")
    wa, wb = has_wild(a), has_wild(b)
    if not wa and not wb:                       # ทั้งคู่เป็นไฟล์หรือโฟลเดอร์ตรง ๆ
        return a == b or a.startswith(b + "/") or b.startswith(a + "/")
    if wa and wb:                               # wildcard ทั้งคู่ เทียบ prefix ฝั่งปลอดภัย
        pa, pb = lit_prefix(a), lit_prefix(b)
        return pa.startswith(pb) or pb.startswith(pa)
    lit, pat = (b, a) if wa else (a, b)         # ฝั่งหนึ่งตรง ๆ อีกฝั่งเป็น pattern
    if any(re.fullmatch(to_re(pat), x) for x in parents(lit)):
        return True
    return lit_prefix(pat).startswith(lit + "/") or lit_prefix(pat) == lit
โค้ดนี้เป็นตัวอย่างย่อให้เห็นแนวคิด ใช้ไลบรารีมาตรฐานของ Python ล้วน ๆ เพราะผมอยากให้รันกับ Python ของระบบได้เลยโดยไม่ต้องติดตั้งอะไร
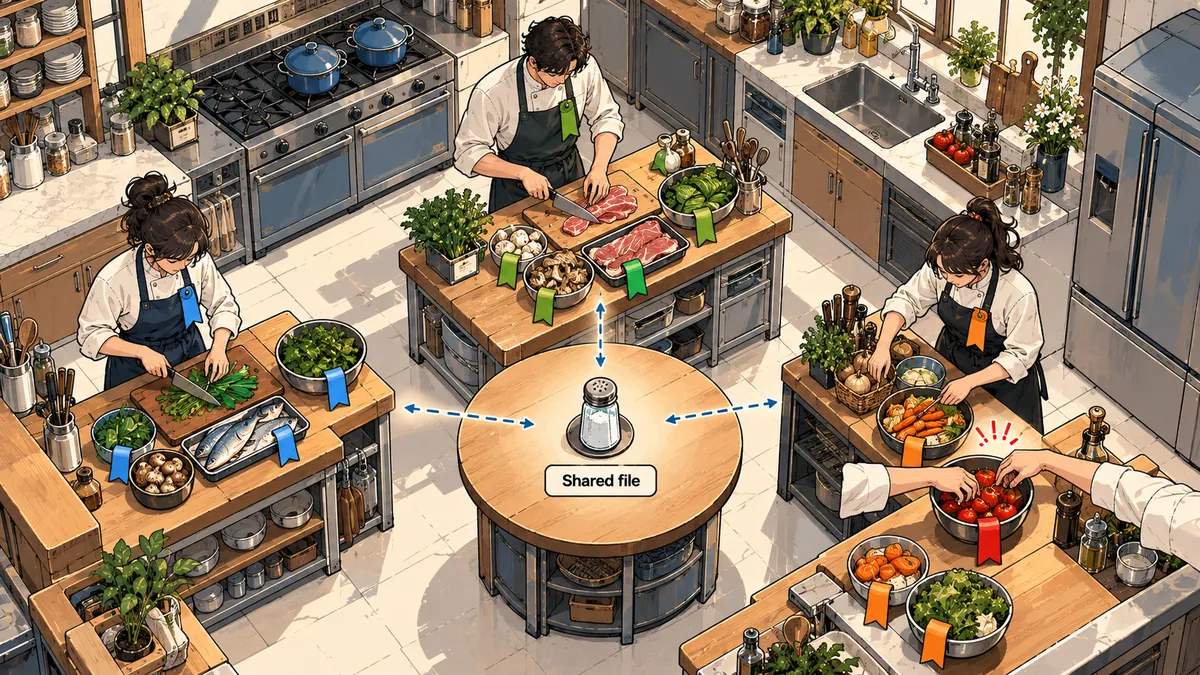
Dispatcher บน SQLite ที่ถือสิทธิ์ในธุรกรรมเดียว
ตัวจัดคิวผมใช้ SQLite เพราะอยู่เครื่องเดียว ไม่ต้องมี service เพิ่ม จุดที่ต้องเขียนให้ถูกคือตอนรับงานใหม่ ต้องอ่านงานที่รันอยู่ ตัดสินว่าชนใคร แล้วบันทึกสถานะ ทั้งหมดในธุรกรรมเดียว ผมใช้ BEGIN IMMEDIATE พร้อม busy timeout เพื่อให้สองงานที่ส่งเข้ามาพร้อมกันไม่เห็นข้อมูลเก่าคนละชุด
import json, sqlite3

def submit(db: str, job_id: str, scope: dict | None):
    con = sqlite3.connect(db, timeout=30, isolation_level=None)   # busy timeout 30 วินาที
    con.execute("BEGIN IMMEDIATE")                                # ล็อกเขียนตั้งแต่ต้น
    try:
        live = con.execute(
            "SELECT id, scope FROM jobs WHERE state IN ('queued','waiting','running') ORDER BY id"
        ).fetchall()
        waits_for = [i for i, sc in live if conflicts(scope, json.loads(sc))]
        state = "waiting" if waits_for else "queued"
        con.execute(
            "INSERT INTO jobs(id, scope, state, waits_for) VALUES (?,?,?,?)",
            (job_id, json.dumps(scope), state, json.dumps(waits_for)),
        )
        con.execute("COMMIT")
    except Exception:
        con.execute("ROLLBACK")
        raise
สังเกตว่างานใหม่ต้องรอไม่ใช่แค่งานที่กำลังรัน แต่รวมถึงงานที่เข้าคิวก่อนหน้าด้วย ไม่งั้นงานเก่าที่ยังไม่ได้เริ่มจะถูกแซง สถานะของงานเลยมี queued กับ waiting แยกกัน waiting พก waits_for ไว้ว่ารอใคร พอทุกงานใน waits_for จบ ตัวจัดคิวก็ปล่อยงานนั้นเป็น queued แล้วเริ่มรัน
Claim hook บังคับตอนเขียนไฟล์ และต้อง fail closed
scope ที่ประกาศไว้เป็นแค่คำพูด ตัวบังคับจริงคือ PreToolUse hook ของเครื่องมือเขียนไฟล์ ก่อนที่โมเดลจะเขียนไฟล์ใด hook จะขอ claim คีย์ของไฟล์นั้นในตาราง claims ถ้าไม่มีงานอื่นถืออยู่ก็ได้ไปเลย ถ้างานอื่นถืออยู่ก็รอได้ CLAIM_WAIT เท่ากับ 120 วินาที หมดเวลาแล้วยังไม่ได้ก็ปฏิเสธการเขียน
ส่วนที่ผมย้ำกับตัวเองมากที่สุดคือเมื่อ hook ติดต่อฐานข้อมูลงานไม่ได้ ต้อง ปฏิเสธการเขียน ไม่ใช่ปล่อยผ่าน ถ้าปล่อยผ่านตอนฐานข้อมูลพัง ก็เท่ากับวันที่ระบบล็อกพังคือวันที่ทุกงานทับกันได้ฟรี ผมลองใหม่สองสามครั้งก่อนแล้วค่อยปฏิเสธ
import sqlite3, sys, time, json

CLAIM_WAIT = 120

def try_claim(db, job_id, key) -> bool:
    con = sqlite3.connect(db, timeout=10, isolation_level=None)
    con.execute("BEGIN IMMEDIATE")
    try:
        row = con.execute("SELECT job_id FROM claims WHERE key=?", (key,)).fetchone()
        if row is None or row[0] == job_id:
            con.execute("INSERT OR REPLACE INTO claims(key, job_id) VALUES (?,?)", (key, job_id))
            con.execute("COMMIT")
            return True
        con.execute("COMMIT")
        return False                       # คนอื่นถืออยู่
    except Exception:
        con.execute("ROLLBACK")
        raise

def main():
    ev = json.load(sys.stdin)
    path = ev["tool_input"].get("file_path", "")
    deadline = time.time() + CLAIM_WAIT
    errors = 0
    while True:
        try:
            if try_claim(DB, JOB_ID, path):
                return 0                   # ได้ claim ปล่อยให้เขียน
        except sqlite3.Error:
            errors += 1
            if errors >= 3:                # เข้าฐานข้อมูลไม่ได้ซ้ำ ๆ
                print("ติดต่อฐานข้อมูลงานไม่ได้ ปฏิเสธการเขียน", file=sys.stderr)
                return 2                   # fail closed
        if time.time() > deadline:
            print("ไฟล์นี้ถูกงานอื่นถืออยู่ เกินเวลารอ", file=sys.stderr)
            return 2
        time.sleep(2)

sys.exit(main())
มีอีกชั้นหนึ่งที่ผมเพิ่มทีหลัง คือการแก้ไฟล์ของนักพัฒนาเองด้วยมือบนเครื่องเดียวกัน ถ้าคนแก้เองไม่ผ่านระบบนี้ worker ก็มองไม่เห็นว่ามีคนแตะไฟล์อยู่ ผมเลยมีสคริปต์เล็ก ๆ ให้การแก้ของนักพัฒนาประกาศ claim เข้าตารางเดียวกัน worker จะได้เห็นและรอ
ทำไมต้องมี records ไม่ใช่แค่ path
ตอนแรกผมคิดว่าประกาศแค่ path ก็พอ แต่เว็บที่เนื้อหาอยู่ในฐานข้อมูลมีกรณีที่สองงานไม่ได้แตะไฟล์เดียวกันเลย แต่แก้ระเบียนเดียวกัน เช่นงานหนึ่งแก้ข้อความของหน้า about ผ่านเทมเพลต อีกงานหนึ่งแก้หน้า about เหมือนกันแต่ผ่านแถวในตารางหน้า ไฟล์คนละไฟล์ แต่ผลสุดท้ายคือหน้าเดียวกัน ถ้าเทียบแค่ path ก็จะมองว่าไม่ชน
records เลยเป็นอีกแกนหนึ่งของการเทียบ สองงานชนกันเมื่อ path ชนหรือ record ชน อย่างใดอย่างหนึ่งก็พอ รูปแบบ "model:" คือถือสิทธิ์ทั้งโมเดลสำหรับงานที่แก้ทุกระเบียน เช่นเปลี่ยนคำเรียกทั่วทั้งเว็บ ส่วนงานที่ประกาศว่าทั้งเว็บ (ค่าว่างหรือ "") จะรันคนเดียว ไม่มีงานอื่นรันคู่ ผมใช้กับงานที่แตะเยอะจนระบุขอบเขตไม่ได้จริง ๆ เช่นเปลี่ยนโครงทั้งเทมเพลต
def conflicts(a: dict | None, b: dict | None) -> bool:
    if a is None or b is None:                       # ทั้งเว็บ ชนทุกงาน
        return True
    pa = [p for p in a.get("paths", []) if p not in HOT_FILES]
    pb = [p for p in b.get("paths", []) if p not in HOT_FILES]
    if any(overlap(x, y) for x in pa for y in pb):
        return True
    ra, rb = set(a.get("records", [])), set(b.get("records", []))
    if ra & rb:
        return True
    wild = lambda s: {r.split(":")[0] for r in s if r.endswith(":*")}
    return bool(wild(ra) & {r.split(":")[0] for r in rb} or wild(rb) & {r.split(":")[0] for r in ra})
ไฟล์ร้อน ไม่ล็อก แต่รวมให้
ถ้าทุกอย่างต้องรอกันตามกติกาข้างบน จะติดปัญหาข้อสองคือไฟล์ที่แทบทุกงานต้องแตะ เช่นไฟล์ภาษา ไฟล์ routes ไฟล์ CSS กลาง และไฟล์ config งานแก้ข้อความหน้าไหนก็ต้องเพิ่มคีย์ในไฟล์ภาษา ถ้าถือเป็นการชนทุกครั้ง ทุกงานจะต่อคิวเป็นแถวเดียว
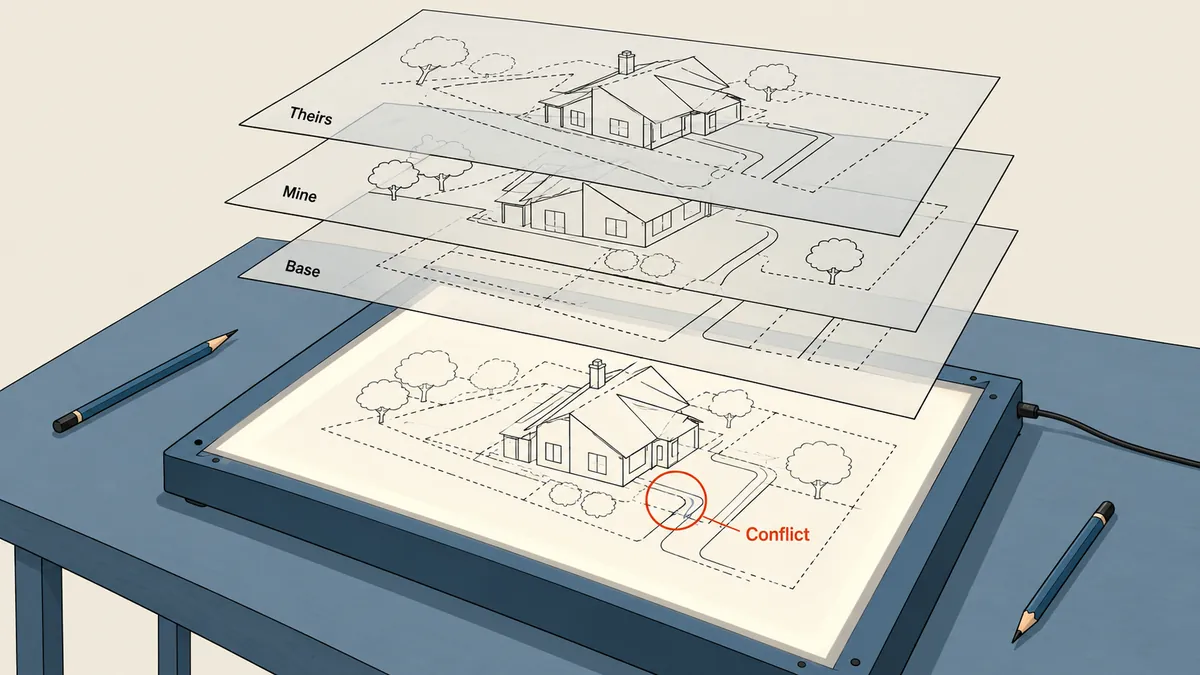
ผมเลยแยก "ไฟล์ร้อน" ออกมาเป็นรายการ ไฟล์ในรายการนี้ไม่ทำให้งานต้องรอ แต่ละงานแก้ในสำเนาของตัวเอง แล้วไปรวมกันตอน deploy ด้วย git merge-file แบบสามทาง ตอนเริ่มงานผมจดค่า sha256 ของไฟล์ที่งานเริ่มจากไว้เป็น base ตอน deploy เทียบกับไฟล์จริงตอนนั้น ถ้าตรงกันแปลว่าไม่มีใครแก้ระหว่างทาง เขียนทับได้เลย ถ้าไม่ตรง ดึงไฟล์จริงมารวม
# mine = ผลของงานนี้, base = ไฟล์ที่งานเริ่มจาก, live = ไฟล์จริงตอนนี้
sha256sum live.php | cut -d' ' -f1                 # เทียบกับ sha256 ของ base ที่จดไว้ตอนเริ่มงาน

git merge-file -p -L "this job" -L base -L live mine.php base.php live.php > merged.php
echo "conflicts=$?"      # 0 = รวมสะอาด, เลขบวก = จำนวนจุดที่ชนจริง (มี conflict marker ในไฟล์)
ถ้ามีความขัดแย้งจริง คือสองงานแก้บรรทัดเดียวกันในไฟล์ร้อน ผมไม่เดา ปล่อยให้ conflict marker อยู่ในไฟล์แล้วส่งกลับให้ worker แก้ต่อ ถ้ายังเป็นอยู่ก็ลองใหม่ตามจำนวนครั้งที่กำหนด ไฟล์ไบนารีรวมแบบนี้ไม่ได้ เลยรวมแบบนี้ไม่ได้
ตัวอย่างที่ชน กับที่ไม่ชน
ผมเขียนสามงานสมมติเพื่อให้เห็นว่าแต่ละกฎให้ผลยังไง
ชุดทดสอบ และสิ่งที่ผมเรียนรู้
ส่วนที่ทำให้ผมกล้าปล่อยระบบนี้คือชุดทดสอบ ผมมีไฟล์ทดสอบแยกสามชุด ชุดแรกทดสอบ dispatcher กับ scope ว่าชนถูกคู่ ชุดที่สองทดสอบการรันขนานของ worker หลายตัว และชุดที่สามทดสอบการแยกส่วนของระบบ เวลาแก้กติกาการเทียบ pattern ควรรันชุดแรกก่อนทุกครั้ง เพราะบั๊กตรงนี้เงียบมาก ถ้าเทียบพลาดไปทางหลวมก็แค่ทับกันเหมือนเดิม และไม่มีอะไรบอกเลย
- ให้ประกาศล่วงหน้า แต่บังคับด้วย hook ที่เป็นโค้ด ไม่ใช่ความหวังว่าโมเดลจะจำได้
- ไฟล์ร่วมที่ทุกงานต้องแตะ ใช้การรวมแบบสามทาง ไม่ใช้ล็อก
- hook ต้อง fail closed เมื่อฐานข้อมูลล็อกพัง
- เทียบ scope ให้อยู่ฝั่งปลอดภัยเสมอ ถ้าไม่แน่ใจให้ถือว่าชน
- ใช้ไลบรารีมาตรฐานล้วน จะได้รันกับ Python ของระบบได้เลย
ระบบนี้กันการทับของงานที่ผ่านมันเท่านั้น คนที่แก้ไฟล์ด้วยมือบนเครื่องโดยไม่ประกาศ claim ก็ยังทับได้ ผมเลยต้องมีสคริปต์ให้การแก้ของนักพัฒนาเองประกาศ claim ด้วย และ merge สามทางรวมได้แค่ไฟล์ข้อความ ส่วนการตัดสินว่าสองการแก้ไขที่ชนกันจริงควรเอาแบบไหนยังต้องมีคนหรือ worker มาแก้เอง
ส่วนเรื่องโควตาที่ใช้ร่วมกันระหว่างงาน และระดับสิทธิ์ที่ worker แต่ละตัวได้รับ ผมแยกไปเขียนไว้ใน ตอนระดับสิทธิ์ตามคนสั่ง ส่วนกลไก claim แบบอะตอมมิกที่มาจากแนวเดียวกันอ่านเพิ่มได้ใน ตอน claim งานแบบ idempotent สำหรับใครที่จะลองทำบ้าง ตามกำลังเครื่องและความสะดวกของแต่ละที่ แต่ถ้าต้องเลือกลงทุนเวลาแค่ข้อเดียว ผมแนะนำ hook ที่ fail closed เพราะมันคือชั้นที่ทำให้คำว่า "ประกาศ scope" กลายเป็นของจริง ตรงไหนที่ผมอธิบายยังไม่ครบ เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย