เสียงชุดใหม่ยาวไม่เท่าเดิม ย้ายแผนตัดต่อด้วย waveform correlation
เสียงสองไฟล์ที่ควรเป็นเนื้อเดียวกันแต่ยาวต่างกัน 1.48 วินาที ไม่ได้แปลว่าต้องยืดทั้งเส้น ถ้าวัดดูจะพบว่าส่วนใหญ่เป็นการเลื่อนคงที่ประมาณ 2 วินาที กับสเกลเล็กมากที่แทบมองไม่เห็น
สรุปใน 1 นาที
- อาการ/ปัญหา
- แผนตัดต่อ 33 ท่อนวางบนเสียง 194.28 วินาที แต่เสียงชุดใหม่ยาว 192.80 วินาที
- ใครควรอ่าน
- คนที่ต้องย้ายแผนตัดต่อไปใช้กับไฟล์เสียงที่ยาวไม่เท่าเดิม
- ทางแก้แบบสั้น
- อย่ายืดตามอัตราส่วน ให้ทำ cross-correlation 8 หน้าต่างที่ 8 kHz ฟิตเส้นตรง new = a*old + b แล้วแปลงทุกจุดตัดผ่านเส้นเดียวกัน
พอดีผมวางแผนตัดต่อ 33 ท่อน 9 ส่วนของเพลงตัวอย่างหนึ่งเพลงไว้บนเสียงที่อัดจากเครื่องเล่น (ผมเรียกว่า "ไฟล์อัดเดิม") ความยาว 194.28 วินาที แล้วต่อมาได้ไฟล์สเต็มชุดใหม่แบบ lossless จากต้นทางอื่น ยาว 192.80 วินาที ต้องย้ายแผนทั้งชุดไปอยู่บนเวลาใหม่ ผมไม่อยากทำแผนใหม่ทั้งหมด เลยต้องหาวิธีย้ายที่พิสูจน์ได้ว่าไม่เพี้ยน
ผมไม่เล่าเนื้อหาของเพลงหรือรายละเอียดแต่ละท่อน เอาเฉพาะวิธีวัดและตัวเลข และต้องบอกก่อนว่าผลที่เขียนในไฟล์ผลลัพธ์ระบุ humanListeningVerified = false คือผมยังไม่ได้ฟังด้วยหูเพื่อยืนยัน ทุกอย่างในบทความนี้ยืนยันด้วยตัวเลขเท่านั้น
วิธีลวกที่ผมเกือบใช้ คือคูณอัตราส่วน
วิธีที่ทุกคนนึกถึงก่อนคือเอา 192.80 / 194.28 = 0.99238 ไปคูณทุกจุดตัด ฟังดูสมเหตุสมผลเพราะความยาวสองไฟล์ต่างกัน แต่ผมคำนวณเทียบกับผลที่วัดได้ (เส้นฟิตจะมาในหัวข้อถัดไป) แล้วพบว่าวิธีนี้ผิดตั้งแต่ 0.5 ถึง 1.85 วินาที
| เวลาในไฟล์เก่า | คูณ 0.99238 | ตามเส้นที่วัดได้ | ผิดไป |
|---|---|---|---|
| 20 s | 19.848 | 17.995 | 1.85 s |
| 100 s | 99.238 | 98.002 | 1.24 s |
| 177 s | 175.652 | 175.008 | 0.64 s |
| 194.28 s | 192.800 | 192.289 | 0.51 s |
ความจริงคือ "เลื่อนคงที่ประมาณ 2 วินาที" บวก "สเกลเล็กมาก" ไม่ใช่ยืดทั้งเส้น การคูณอัตราส่วนความยาวไปผลักทั้งการเลื่อนและความยาวส่วนเกินท้ายไฟล์ให้กระจายผิดที่ ผลคือจุดตัดช่วงต้นเพลงที่ควรเลื่อนแค่สองวินาทีถูกลากไปผิดเกือบสองวินาทีเต็ม
ไฟล์ใหม่ยาวกว่าที่เส้นฟิตทำนายอยู่ประมาณ 0.5 วินาทีที่ท้ายไฟล์ (194.28 x a + b = 192.29 แต่ไฟล์ยาว 192.80) ผมไม่ขอสรุปสาเหตุของหางส่วนเกินนี้ เพราะไม่มีหลักฐานพอ ผมจัดการด้วยการบังคับให้ท่อนสุดท้ายจบที่ 192.80 พอดี
วัดจริงด้วย cross-correlation 8 หน้าต่าง
ผมเอาเสียงร้องที่แยกจากไฟล์อัดเดิม (ได้จากเครื่องมือแยกเสียง เป็นไฟล์พรีวิว) ไปเทียบกับสเต็มเสียงร้องแบบ lossless ของชุดใหม่ ใช้ normalized signed-waveform cross-correlation แปลงเป็น mono 8 kHz ก่อน เพราะที่ 8 kHz หนึ่งซัมเปิลยาว 0.125 มิลลิวินาที ละเอียดกว่าหนึ่งเฟรมที่ 30 fps (33.3 มิลลิวินาที) เกือบสามร้อยเท่า และเบากว่าการเทียบที่ 48 kHz มาก
หน้าต่างทั้ง 8 เริ่มที่ 20, 45, 70, 90, 115, 140, 165 และ 177 วินาทีของไฟล์เก่า ผลที่บันทึกไว้คือ
ผมไม่มีสคริปต์ที่สร้างไฟล์ผลลัพธ์นั้นอยู่ในมือแล้ว (เหลือแต่ผลที่บันทึกไว้) เลยไม่รู้ความยาวหน้าต่างและรายละเอียดการฟิตที่ใช้จริง โค้ดข้างล่างเป็น "ตัวอย่างวิธี" ที่ผมเขียนใหม่ให้ตรงหลักการเดียวกัน ไม่ใช่สคริปต์เดิม
import subprocess
import numpy as np
from scipy.signal import correlate

SR = 8000

def load_mono(path):
    raw = subprocess.run(
        ['ffmpeg', '-v', 'error', '-i', path,
         '-ac', '1', '-ar', str(SR), '-f', 'f32le', '-'],
        capture_output=True, check=True).stdout
    return np.frombuffer(raw, dtype=np.float32).astype(np.float64)

def ncc_best(ref, probe):
    """ref ยาวกว่า probe; คืน (offset เป็นซัมเปิลใน ref, คะแนน -1..1)"""
    n = len(probe)
    cc = correlate(ref, probe, mode='valid', method='fft')
    c2 = np.concatenate(([0.0], np.cumsum(ref * ref)))
    energy = c2[n:] - c2[:-n]                       # พลังงานหน้าต่างเลื่อน
    denom = np.sqrt(np.maximum(energy, 1e-12) * float(np.dot(probe, probe)))
    score = cc / denom
    k = int(np.argmax(score))
    return k, float(score[k])

def locate(old, new, t_old, win=6.0, search=6.0):
    p0 = int(t_old * SR)
    probe = old[p0:p0 + int(win * SR)]
    lo = max(0, p0 - int(search * SR))
    hi = min(len(new), p0 + int((search + win) * SR))
    k, s = ncc_best(new[lo:hi], probe)
    return (lo + k) / SR, s
การหารด้วยรากของพลังงานคือส่วนที่ทำให้คะแนนอยู่ระหว่าง -1 ถึง 1 โดยไม่ขึ้นกับความดังของแต่ละช่วง ผมคำนวณพลังงานหน้าต่างเลื่อนด้วย cumsum ครั้งเดียวแทนการวนคำนวณทุกตำแหน่ง ใช้สูตรเดียวกับที่ผมใช้จับคู่ไฟล์ด้วยเสียงในบทความ จับคู่ไฟล์ที่ไม่มีป้ายด้วย correlation และ Hungarian
ผมทดสอบฟังก์ชันนี้กับสัญญาณสังเคราะห์ที่สร้างให้เลื่อน 2.006 วินาทีและยืด 1.0000778 เท่า ฟิตจาก 8 หน้าต่างที่ตำแหน่งเดียวกันได้ a = 1.0000781 และ b = -2.0058 ซึ่งใกล้กับค่าที่ตั้งไว้ คะแนน correlation ในสัญญาณทดสอบอยู่ราว 0.90 (นี่เป็นค่าของสัญญาณทดสอบ ไม่ใช่ค่าของงานจริง)
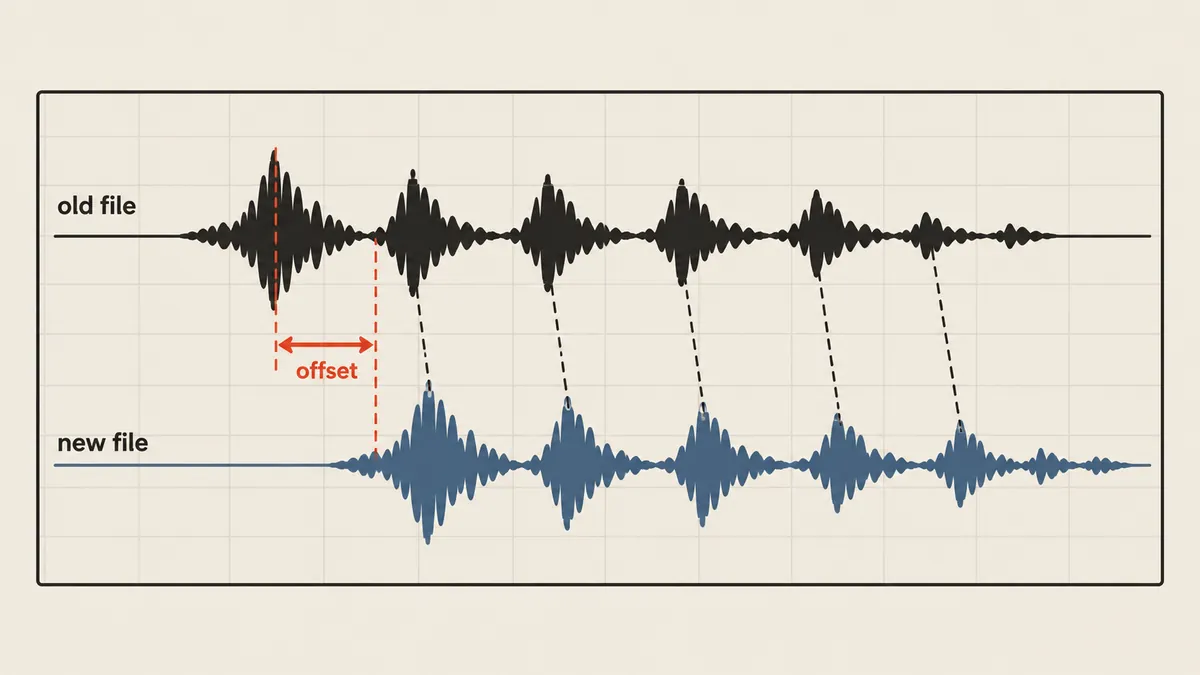
ฟิตเส้นตรง new = a*old + b
แปด offset ทำให้ผมได้แปดคู่ (เวลาเก่า, เวลาใหม่) แล้ว np.polyfit ดีกรี 1 ได้เส้นตรงที่ลดความคลาดรวมให้ต่ำสุด
import numpy as np

old_t = np.array([20, 45, 70, 90, 115, 140, 165, 177], dtype=float)
off   = np.array([-2.001875] * 5 + [-1.991875] * 3)
new_t = old_t + off

a, b = np.polyfit(old_t, new_t, 1)
resid = a * old_t + b - new_t
print(f'a = {a:.9f}  ({(a - 1) * 1e6:.1f} ppm)')
print(f'b = {b:.5f} s')
print(f'residual max = {np.abs(resid).max() * 1000:.1f} ms')
ผมเอา offset ที่บันทึกไว้มาคำนวณซ้ำได้ a = 1.000077763 (ต่างจาก 1 อยู่ 77.8 ส่วนในล้าน) b = -2.00612 วินาที และ residual สูงสุด 4.7 มิลลิวินาที ซึ่งน้อยกว่าหนึ่งเฟรมที่ 30 fps (33.3 มิลลิวินาที) มาก
สเกล 77.8 ppm คิดเป็นสะสม 15 มิลลิวินาทีตลอด 194 วินาที เล็กกว่าหนึ่งเฟรม แต่ผมเก็บไว้ในสมการเพราะมันไม่มีต้นทุน สาเหตุของสเกลนี้ผมเดาว่าอาจเป็นความต่างของนาฬิกาอุปกรณ์เล่นหรืออัดเทียบกับไฟล์ นั่นเป็นสมมติฐาน ผมไม่ได้พิสูจน์
แปลงแผนทั้งชุดผ่านเส้นเดียว
จุดสำคัญคือทุกขอบของแผนต้องผ่านสมการเดียวกัน ทั้งขอบท่อนตัดและขอบส่วนของเพลง ไม่ใช่แต่ละท่อนฟิตเอง
def mapped(t, a, b, new_dur):
    return round(min(max(a * t + b, 0.0), new_dur), 6)

def retime(plan, a, b, new_dur, src_len):
    adjustments = []
    for cut in plan['cuts']:
        cut['start'] = mapped(cut['start'], a, b, new_dur)
        cut['end'] = mapped(cut['end'], a, b, new_dur)
    plan['cuts'][-1]['end'] = new_dur                    # ท่อนสุดท้ายจบพอดีที่ท้ายไฟล์ใหม่
    plan['cuts'][0]['in'] += max(0.0, -b / a)           # ตัดช่วงเงียบหัวไฟล์อัดเดิม
    for i, cut in enumerate(plan['cuts']):
        length = cut['end'] - cut['start']
        limit = src_len[i] - length - 0.025              # กัน in เลยปลายคลิปต้นทาง
        if cut['in'] > limit:
            adjustments.append({'cut': i, 'was': cut['in'], 'now': max(0.0, limit)})
            cut['in'] = max(0.0, limit)
    return adjustments
ขอบหน้าของท่อนแรกอยู่ที่ศูนย์ในแผนเก่า พอแปลงแล้วได้ค่าลบ (-2.006) แต่ถูก clamp ที่ศูนย์ ช่วง 2.006 วินาทีแรกของไฟล์เก่าเลยไม่มีที่ลงในเสียงใหม่ ผมเลยขยับจุดเริ่มอ่านของท่อนแรกในคลิปต้นทางเพิ่ม 2.006 วินาที ซึ่งเป็นช่วงเงียบหัวไฟล์อัดเดิมพอดี ส่วนท่อนอื่นมีการตรวจ limit ว่า in-point บวกความยาวใหม่ต้องไม่เกินความยาวคลิปต้นทางลบ 0.025 วินาที ผลคือมี 2 ท่อนที่ต้องลด source-in และผมบันทึกเหตุผลลงใน sourceInAdjustments
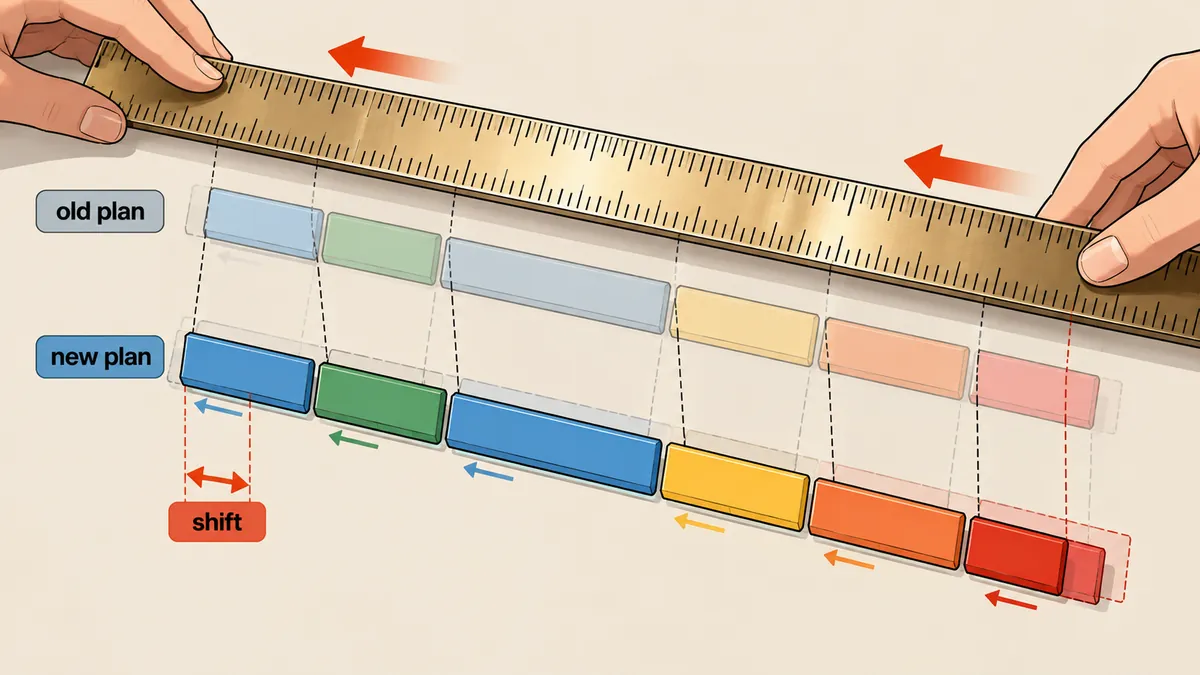
สรุปลำดับงานทั้งหมดตั้งแต่วัดจนถึงเขียนแผนใหม่ไว้ในผังนี้
แผนเก่าผมไม่แตะ เก็บเป็นประวัติพร้อมบันทึกค่า SHA-256 ไว้ใน alignment.json ส่วนแผนใหม่เขียนเป็นไฟล์แยก ถ้ามีอะไรผิดสามารถย้อนกลับไปเทียบได้เสมอ
สิ่งที่ผมยังไม่รู้ และข้อจำกัด
- ผมไม่รู้ความยาวหน้าต่างและวิธีฟิตที่ใช้ในการวัดจริง โค้ดในบทความเป็นตัวอย่างวิธี ผมยืนยันได้เฉพาะตัวเลขที่บันทึกไว้และผลคำนวณซ้ำจากตัวเลขนั้น
- ผลลัพธ์ระบุว่ายังไม่ได้ฟังด้วยหูยืนยัน (`humanListeningVerified = false`) ผมคงข้อความนี้ไว้ ไม่ปรับให้ดูดีกว่าความจริง
- วิธีนี้ต้องมีเสียงร้องหรือเนื้อสัญญาณเดียวกันในสองไฟล์ ถ้าเสียงผ่านการแปลงจนรูปคลื่นเปลี่ยน คะแนน correlation จะตกและเส้นฟิตใช้ไม่ได้
- แปดหน้าต่างพอสำหรับเส้นตรง ถ้าสงสัยว่ามีการเลื่อนแบบไม่เป็นเส้นตรง (เช่นมีช่วงที่ตัดต่อมา) ต้องเพิ่มหน้าต่างแล้วดู residual เป็นรายจุด ไม่ใช่เชื่อเส้นเดียว
ผมสรุปได้ว่าก่อนย้ายแผนตัดต่อไปอยู่บนเสียงชุดใหม่ ให้วัดก่อนด้วยหน้าต่างหลายจุด ไม่เดา และไม่ยืดตามความยาวรวม ดูทั้ง offset ที่ต่างกันตามเวลา (บ่งว่ามีสเกล) กับ residual ว่าเล็กกว่าหนึ่งเฟรมไหม แล้วเขียนผลวัดเก็บเป็นหลักฐาน เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย