#Architecture
งานที่ยิงออกนอกระบบ ต้องจองสถานะก่อนยิงเสมอ
guard แบบ "อ่านสถานะแล้วค่อยยิง" ดูปลอดภัยจนถึงวันที่ worker โดนฆ่าหลังยิงแต่ก่อนเขียนฐานข้อมูล แล้ว retry ก็ยิงซ้ำให้ลูกค้าเห็นของสองรอบ บทความนี้คือชุดกันซ้ำทั้งชุดที่ผมใช้ ตั้งแต่การจองแบบ atomic ไปจนถึง retry_after กับ failed() ที่ห้ามทับสถานะที่สำเร็จแล้ว
โค้ดชุดเดียวสองบทบาท เว็บอยู่โฮสต์ worker อยู่เครื่องที่บ้าน
ระบบทั้งตัวเคยวิ่งอยู่บนเครื่องเดียวหลังเน็ตบ้าน เครื่องดับทีเดียวทีมใช้อะไรไม่ได้เลย ผมเลยแยกเป็นสองบทบาทด้วยโค้ดชุดเดิม — เว็บอยู่โฮสต์ที่เปิดตลอด งานหนักอยู่เครื่องที่บ้านแล้ววิ่งมาดึงงานเอง พร้อมตาราง claim แบบ atomic และแผนสลับ 18 ขั้นที่มีทางถอย
ย้ายการคำนวณจาก PHP ไปทำในเบราว์เซอร์: 12 วินาที เหลือ 12 มิลลิวินาที
หน้าเดียวยิง subquery หลักหมื่นครั้งจนโหลดนาน 12 วินาที ผมแก้ด้วยการทำตารางสรุปไว้ล่วงหน้า ส่ง dataset ก้อนเดียว 107 KB แล้วย้ายสูตรไปคำนวณในเบราว์เซอร์ เหลือ 12 มิลลิวินาที พร้อม parity test ที่บังคับให้ผลฝั่ง JS ตรงกับ PHP ทุกแถว
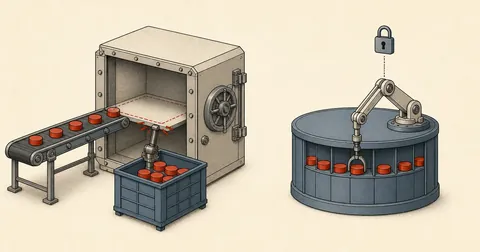
คิวงาน Laravel บน shared host — อย่าเอาคิวไว้ Redis ตัวเดียวกับ cache
จะเปิด queue ให้ Laravel บน shared host แล้วคิดจะแยก REDIS_DB ให้คิวอยู่คนละเบอร์กับ cache — ไม่ช่วยครับ เพราะ maxmemory กับ eviction เป็นของทั้ง instance ไม่ใช่ของราย DB บทความนี้เล่าเหตุผลที่ผมเลือก database driver แทน พร้อม systemd unit เต็ม ๆ ที่ใช้แทน Supervisor
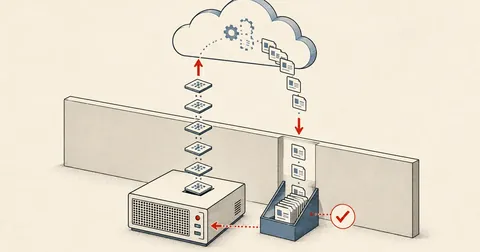
เครื่องในโรงงานหลัง NAT ขึ้นคลาวด์ ด้วย push snapshot + คิวคำสั่ง
เครื่องงานจริงอยู่ใน LAN หลัง NAT ไม่มี public IP แต่เจ้าของอยากดูข้อมูลบนเว็บคลาวด์และแก้ข้อมูลจากมือถือให้ลงไปถึงเครื่องใน — ทำได้โดยไม่เปิดพอร์ตไม่ตั้ง VPN ด้วย push snapshot + คิวคำสั่งแก้ + ack แบบ idempotent