#Crawler
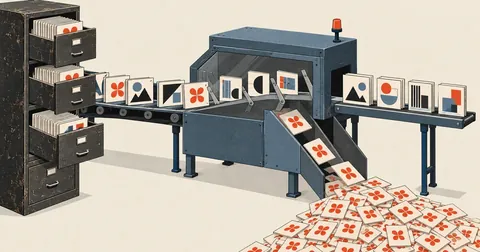
ย้ายเว็บ .aspx เก่าทั้งเว็บ ทำเป็น catalog JSON แล้วคัดรูปขยะออกเอง
เจ้าของเว็บ .aspx เก่าขอให้ทำเว็บใหม่ แต่เนื้อหาสิบกว่าปีอยู่ในฐานข้อมูลที่เข้าไม่ถึงแล้ว ผมเลยไล่เก็บหน้าเว็บของเขาเองมาทำเป็น catalog JSON ที่คง legacy_id ไว้ทั้งหมด แล้วเขียนตัวคัดรูปสามชั้นกันไม่ให้ QR ของแถมกลายเป็นรูปปกบทความ
Googlebot โดนไฟร์วอลล์ตัวเองแบนถาวร จนเว็บหายจากผลค้นหา
ไล่ตรวจว่าทำไมเว็บหายจากผลค้นหา แล้วเจอ Googlebot นอนอยู่ในรายการแบนถาวรของไฟร์วอลล์ตัวเอง 408 จาก 500 แถวมาจากตัวนับ false positive ของ WAF วิธีปลดแบน สคริปต์ดึงช่วงไอพีทางการของบอทมาใส่ ignore list ทุกวัน กับดัก grep และผลข้างเคียงของการบล็อกทั้งประเทศ
AI crawler ยิง ?add-to-cart= จนโหลดพุ่ง — บล็อกยังไงไม่ให้เสีย SEO
โหลดเซิร์ฟเวอร์พุ่งจนได้เมลเตือน ไล่ log แล้วพบว่า 84% ของทราฟฟิกทั้งวันมาจาก AI crawler ตัวเดียวที่ไล่กดลิงก์ add-to-cart ทุกสินค้า ปิดเป็นชั้น ๆ ด้วย robots.txt, rel=nofollow และ nginx limit_req โดยหน้าสินค้ายังถูก index ครบ
AdSense บอก ads.txt "ไม่พบ" ทั้งที่ไฟล์อยู่ — ไล่ log พิสูจน์ทีละชั้น
หน้า Sites ของ AdSense ขึ้น ads.txt "ไม่พบ" ทั้งที่ไฟล์อยู่ครบถูกต้อง — บทความ forensics ไล่พิสูจน์ทีละชั้นด้วย curl + access log ว่า Googlebot เคยมาแล้วได้อะไรกลับไป สรุปคดี: ไม่มีใครบล็อค มันคือสถานะค้างของ Google เอง