Whisper ถอดเสียงฮัมเป็นคำ และได้เวลาผิด ถ้าไม่ถอดจาก stem ที่ถูกต้อง
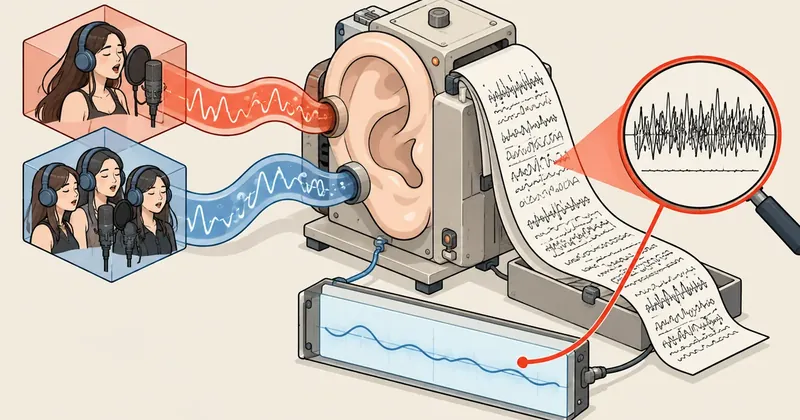
ผลถอดเสียงที่มีเวลากำกับดูน่าเชื่อถือเสมอ ทั้งที่ส่วนหนึ่งเป็นของที่ไม่มีอยู่จริง ผมเลยเก็บกับดักที่เจอจริงไว้เป็นรายการ พร้อมตัวเลขว่าเสียเวลาไปเท่าไรถ้าเชื่อโดยไม่ตรวจ
สรุปใน 1 นาที
- อาการ/ปัญหา
- Whisper ถอดเสียงทั้งมิกซ์แล้วเวลาคลาด มีข้อความหลอน และอ่านเสียงฮัมเป็นประโยค
- ใครควรอ่าน
- คนที่ใช้ Whisper ถอดเนื้อเพลงพร้อมเวลาเพื่อตัดต่อ
- ทางแก้แบบสั้น
- ถอดจากสเต็มที่ถูกต้องแทนมิกซ์ ตรวจช่วงบรรเลง เสียงฮัม และท้ายไฟล์ โดยเวลาเริ่มท่อนแรกขยับจาก 19.2 เป็น 18.5 วินาที
พอดีผมถอดเสียงของเพลงทดลองเพลงหนึ่งยาว 280.85 วินาทีเพื่อเอาเวลาของวลีร้องไปวางแผนตัดต่อ รอบแรกผมถอดจากมิกซ์ทั้งเพลง ได้ไฟล์ที่ดูสมบูรณ์มาก มีเวลาเริ่มจบกำกับทุกเซกเมนต์ ก่อนเอาไปใช้ผมลองถอดอีกรอบจากสเต็มเสียงร้องที่แยกด้วย Demucs แล้วเอาสองรอบมาเทียบกัน ปรากฏว่ามีหลายจุดที่ไม่ตรงกันเลย และไม่ใช่แค่ต่างกันนิดเดียว บางจุดคือข้อความที่ไม่มีอยู่ในเสียงจริง
บทความนี้เล่าเฉพาะกับดักของ "ผลลัพธ์" ส่วนวิธีรันงานบนเครื่อง GPU กับการส่งมอบแบบตรวจ hash อยู่ใน Demucs + Whisper ทีละไฟล์บนเครื่อง GPU แล้วดึงผลกลับตรวจ SHA-256 ข้อความที่ Whisper ถอดได้ผมไม่ยกมาสักบรรทัด ที่ต้องการคือเวลากับรูปแบบของความผิดพลาด
ภาพรวม: ผลถอดจากมิกซ์ปนของหลอนเกือบหนึ่งในห้า
ผมเอาตัวเลขที่วัดได้จริงมาวางก่อน
ตัวเลข "ประมาณ 20%" ผมบวกเองจากสองเซกเมนต์ (27.5 กับ 30.0 วินาที รวม 57.5 วินาที หารด้วย 280.85) ไม่ใช่ตัวเลขที่ระบบรายงานมา เลยขอระบุว่าเป็นการคำนวณ
กับดักที่ 1: ช่วงบรรเลงกลายเป็นสัญลักษณ์โน้ตยาวหลายสิบวินาที
ในผลถอดจากมิกซ์ มีเซกเมนต์ 96.72-124.24 วินาที (27.5 วินาที) และ 246.52-276.50 วินาที (30.0 วินาที) ที่ข้อความเป็นสตริงของสัญลักษณ์โน้ตดนตรีซ้ำยาว ๆ ช่วงนั้นเป็นเพลงบรรเลงล้วนไม่มีเสียงร้อง Whisper ออกแบบมาถอดเสียงพูด พอเจอเสียงที่ไม่ใช่คำพูดมันก็คายสตริงสัญลักษณ์นี้ออกมา (สาเหตุลึกกว่านั้นเป็นข้อสันนิษฐาน ผมไม่ได้พิสูจน์) เซกเมนต์เหล่านี้มีเวลาเริ่มจบสวยงามเหมือนของจริง ถ้าเอาไปใช้เป็น "ช่วงที่มีเสียงร้อง" จะผิดกว่าหนึ่งนาทีรวม
กับดักที่ 2: เสียงฮัมถูกอ่านเป็นประโยค
ต้นเพลงช่วง 3-19 วินาทีเป็นเสียงฮัมจริง ไม่มีคำ แต่ Whisper อ่านออกมาเป็นประโยคภาษาไทยที่ไม่มีอยู่ ผมยืนยันว่ามันเป็นฮัมได้จากสเต็มเสียงร้องและการตรวจระดับเสียง ไม่ใช่จากข้อความที่ถอดได้ ข้อความมั่นใจพอ ๆ กับคำพูดจริง นี่คือจุดที่อันตรายที่สุด เพราะผิดโดยไม่มีสัญญาณเตือน
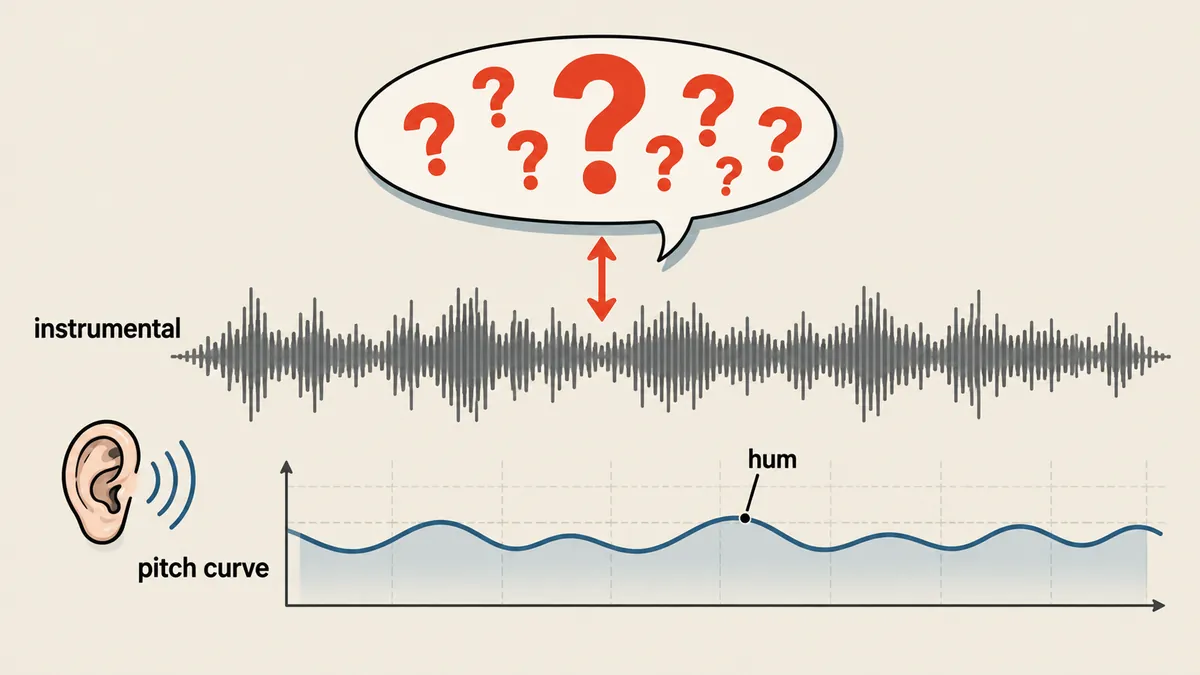
วิธียืนยันที่ผมใช้คือ pitch tracking บนสเต็มเสียงร้อง ถ้าช่วงนั้นมีระดับเสียงต่อเนื่องแต่ข้อความไม่น่าเชื่อถือ ก็น่าจะเป็นเสียงร้องที่ไม่ใช่คำ
# hum_check.py — ช่วงนี้มีระดับเสียงต่อเนื่องไหม (ใช้ librosa.pyin บนสเต็มเสียงร้อง)
import numpy as np, librosa

def voiced_ratio(vocals_wav, t0, t1):
    y, sr = librosa.load(vocals_wav, sr=22050, offset=t0, duration=t1 - t0)
    f0, voiced_flag, voiced_prob = librosa.pyin(
        y, fmin=librosa.note_to_hz('C2'), fmax=librosa.note_to_hz('C6'), sr=sr)
    return float(np.mean(voiced_flag))          # สัดส่วนเฟรมที่มีระดับเสียงชัดเจน

r = voiced_ratio('sep/vocals.wav', 3.0, 19.0)
print(f'voiced {r:.0%} ของ 3-19 s')             # สูง = มีเสียงร้อง แม้ข้อความจะน่าสงสัย
กับดักที่ 3: คำทักทายท้ายไฟล์ที่ไม่มีอยู่จริง
ในผลถอดจากสเต็มเสียงร้อง มีเซกเมนต์ 279.44-280.85 วินาทีที่ข้อความเป็นประโยคทักทายสั้น ๆ ทั้งที่ช่วงนั้นเกือบเงียบ นี่เป็นพฤติกรรมหลอนของ Whisper ที่พบได้ทั่วไปกับเสียงเงียบท้ายไฟล์ ผมไม่ยกประโยคนั้นมาลง
อีกอาการที่ใกล้เคียงกันคือเซกเมนต์ยาว 264.84-277.92 วินาที (13 วินาที) ที่มีข้อความสั้นมากซ้ำไปซ้ำมา เป็นสัญญาณของลูปซ้ำ เซกเมนต์ยาวแต่ข้อความสั้นคือของน่าสงสัยเสมอ
ตัวกรองที่ผมเสนอ (ยังไม่ใช่ค่าที่ใช้จริง)
Whisper ให้ฟิลด์ตัวบอกความมั่นใจมาในทุกเซกเมนต์อยู่แล้ว คือ avg_logprob, no_speech_prob และ compression_ratio ค่า default ของ openai-whisper ตามที่ผมจำได้คือ compression_ratio_threshold 2.4, logprob_threshold -1.0 และ no_speech_threshold 0.6 ตรงนี้เป็นความรู้ทั่วไป ควรเปิดเอกสารของรุ่นที่ติดตั้งเช็กก่อนอ้าง ตัวกรองข้างล่างเป็นข้อเสนอที่เขียนขึ้นให้อ่านง่าย ผมไม่ได้ใช้ค่าเหล่านี้ตรง ๆ ในโปรเจกต์ และต้องลองปรับกับไฟล์ของตัวเอง
# filter_segments.py — ข้อเสนอ: ติดธงเซกเมนต์ที่น่าสงสัย ไม่ลบทิ้งเงียบ ๆ
import json, sys, unicodedata

def has_letters(text):
    return any(unicodedata.category(c)[0] in 'LN' for c in text)    # ตัวอักษรหรือตัวเลขจริง

def reasons(seg):
    r = []
    if not has_letters(seg['text']):          r.append('symbols-only')
    if seg['compression_ratio'] > 2.4:        r.append('repetitive')
    if seg['avg_logprob'] < -1.0:             r.append('low-confidence')
    if seg['no_speech_prob'] > 0.6:           r.append('probably-silence')
    if seg['end'] - seg['start'] > 10 and len(seg['text'].strip()) < 12:
        r.append('long-span-short-text')      # เกณฑ์ที่ผมเพิ่มเอง ใช้จับลูปซ้ำ
    return r

segs = json.load(open(sys.argv[1], encoding='utf-8'))
for s in segs:
    s['flags'] = reasons(s)
    if s['flags']:
        print(f"[WARN] {s['start']:.2f}-{s['end']:.2f}  {','.join(s['flags'])}")
json.dump(segs, open(sys.argv[2], 'w', encoding='utf-8'), ensure_ascii=False, indent=1)
ผมเลือกติดธงแทนการลบ เพราะตัวกรองอัตโนมัติผิดได้ทั้งสองทาง ถ้าลบทิ้งเงียบ ๆ จะไม่มีใครรู้ว่าเคยมีเซกเมนต์ตรงนั้น
ผมถือผลถอดเป็น "หลักฐานเวลา" เท่านั้น และใส่ human_listening_verified = false ในข้อมูลเสมอ จนกว่าจะมีคนฟังจริง ห้ามเขียนว่า "AI ฟังแล้ว" ให้เขียนว่าประมวลผลอัตโนมัติ
กับดักที่ 4: ท่อนร้องหมู่อยู่ผิดสเต็ม
ท่อนร้องหมู่ท่อนหนึ่งที่เวลา 62.4-83.5 วินาที (ราว 21 วินาที) ไม่ได้อยู่ในสเต็มเสียงร้องนำ แต่อยู่ในสเต็มเสียงประสาน ถ้าถอดจากสเต็มร้องนำอย่างเดียวจะไม่ได้เวลาของท่อนนั้นเลย ต้องถอดสเต็มเสียงประสานแยกอีกรอบ
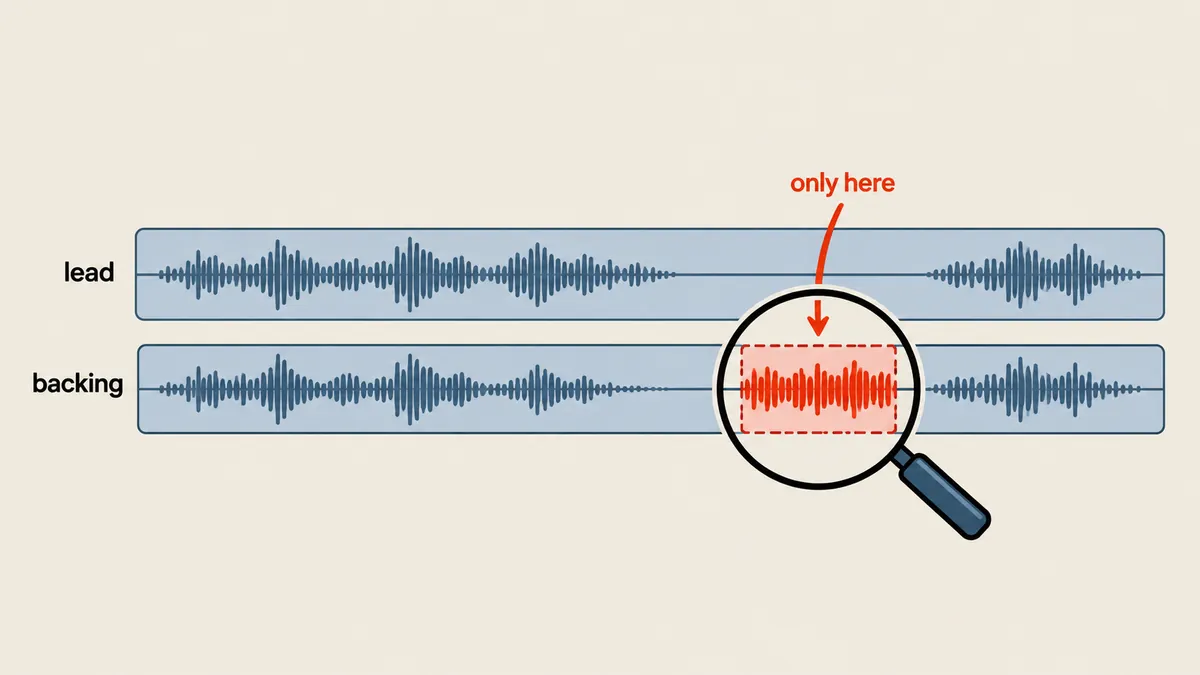
ผลคือขั้นตอนถอดต้องวนทุกสเต็มที่มีเสียงคน ไม่ใช่เลือกสเต็มเดียวแล้วเชื่อว่าครบ ในชุดที่ผมมีคือเสียงร้องนำกับเสียงประสาน ส่วนเครื่องดนตรีไม่ต้องถอด
กับดักที่ 5: เวลาเริ่มท่อนแรกคลาด 0.7 วินาที
จากมิกซ์ ผมเชื่อว่าท่อนแรกเริ่มที่ 19.2 วินาที จากสเต็มเสียงร้องนำได้ 18.5 วินาที เร็วขึ้น 0.7 วินาที เท่ากับประมาณ 21 เฟรมที่ 30 fps ซึ่งเห็นได้ชัดในคัตที่ตัดตามจังหวะ ถ้าเชื่อค่าจากมิกซ์ คัตที่วางตามเวลานั้นจะช้าไป 0.7 วินาทีโดยไม่มีอะไรเตือน
กับดักที่ 6: ขอบเซกเมนต์ต่างกันเมื่อเสียงหนาแน่น
เมื่อเทียบสองรอบ (ถอดมิกซ์กับถอดสเต็ม) ท่อนที่ชัดตรงกันมาก ต่างกันแค่ 0.02-0.1 วินาที เช่น 124.20 กับ 124.24 หรือ 127.50 กับ 127.48 แต่ท่อนที่หนาแน่นแบ่งเซกเมนต์ต่างกัน ตัวอย่างที่เห็นชัดคือสเต็มรวม 158.54-166.42 วินาทีเป็นเซกเมนต์เดียว ส่วนมิกซ์แยกเป็นสอง (158.46-161.14 และ 162.78-166.44) ดังนั้นต้องเทียบสองแหล่งก่อนเชื่อขอบเซกเมนต์
# compare_runs.py — เทียบเวลาเริ่มของสองรอบ (มิกซ์ vs สเต็ม)
import json, sys

a = json.load(open(sys.argv[1], encoding='utf-8'))      # รอบถอดจากมิกซ์
b = json.load(open(sys.argv[2], encoding='utf-8'))      # รอบถอดจากสเต็ม
b_starts = [s['start'] for s in b]

for s in a:
    near = min(b_starts, key=lambda t: abs(t - s['start']))
    d = near - s['start']
    mark = 'OK ' if abs(d) <= 0.1 else 'DIFF'
    print(f'[{mark}] a={s["start"]:7.2f}  b={near:7.2f}  ต่าง {d:+.2f} s')
บรรทัดที่ขึ้น DIFF คือจุดที่ต้องไปฟังเอง ไม่ใช่จุดที่ต้องเลือกฝั่งใดฝั่งหนึ่งอัตโนมัติ
กับดักที่ 7: วลีที่ ASR ถอดไม่ออก ต้องทำเครื่องหมายว่าเป็นประมาณการ
มีช่วงที่ ASR ถอดคำไม่ออก แต่ pitch ยืนยันว่ามีเสียงร้องอยู่ ตัวอย่างคือช่วง 53.7-61.3 วินาที ซึ่งครอบสองบรรทัด ผมใช้การแบ่งเวลาเท่า ๆ กันและบังคับใส่ธง estimated ในข้อมูลเสมอ จะได้ไม่มีใครเข้าใจผิดว่าตัวเลขนั้นวัดมาจริง
# split_estimated.py — แบ่งช่วงที่ถอดไม่ได้เท่า ๆ กัน พร้อมธงบังคับ
def split_equal(t0, t1, n):
    step = (t1 - t0) / n
    return [{'start': round(t0 + i * step, 3),
             'end':   round(t0 + (i + 1) * step, 3),
             'timing': 'estimated'}               # ห้ามขาด ธงนี้คือความซื่อตรงของข้อมูล
            for i in range(n)]

# ตัวอย่างการคำนวณ: ถ้าส่วนที่ถอดไม่ได้คือ 53.7-60.0 s (คำที่จับได้เริ่มที่ 60.0 s) มี 2 บรรทัด
for seg in split_equal(53.7, 60.0, 2):
    print(seg)                                    # 53.7-56.85 และ 56.85-60.0
ตัวอย่างข้างบนเป็นการคำนวณประกอบ ไม่ใช่ผลวัด การแบ่งเท่า ๆ กันคือการเดาที่ซื่อตรงที่สุดเมื่อไม่มีข้อมูล แต่ต้องบอกว่าเดา
อ่านผลถอดก่อนเอาไปวางแผน: ลำดับที่ผมเช็ก
ก่อนเอาเวลาจากผลถอดไปวางคัต ผมเช็กตามลำดับนี้ทุกครั้ง ขั้นแรกดูภาพรวมก่อนว่าเซกเมนต์ที่ยาวผิดปกติมีกี่อัน เพราะเซกเมนต์ยาวหลายสิบวินาทีในเพลงที่มีร้องเป็นห้วง ๆ เกือบแน่ใจได้ว่าเป็นช่วงบรรเลงที่ถูกอ่านเป็นข้อความ ขั้นต่อมาดูท้ายไฟล์กับต้นไฟล์ซึ่งเป็นจุดที่เสียงเบาที่สุดและ Whisper มักเติมของลงไป ขั้นที่สามเทียบกับรอบที่ถอดจากแหล่งอื่น ถ้าสองรอบเห็นตรงกันภายในไม่กี่ร้อยมิลลิวินาทีก็พอวางใจ ถ้าไม่ตรงก็ไปฟังช่วงนั้นจริง ๆ
ผมเลือกติดธงมากกว่าลบเพราะตัวกรองอัตโนมัติผิดได้ทั้งสองทาง ตัวกรองที่เข้มเกินจะทิ้งเซกเมนต์จริงที่เสียงเบา ตัวกรองที่หลวมเกินจะปล่อยของหลอนผ่านไป พอเป็นธงในข้อมูล คนที่มาอ่านทีหลังเห็นทั้งสิ่งที่เก็บและเหตุผลที่สงสัย ตัดสินใจเองได้ ส่วนค่าเกณฑ์ที่ผมเสนอไว้ข้างบนถ้าเอาไปใช้ต้องทดลองกับไฟล์ของตัวเองก่อน ผมไม่ได้ใช้ค่าเหล่านี้ตรง ๆ ในโปรเจกต์
อีกข้อหนึ่งที่ผมได้จากงานนี้คือ ความมั่นใจของโมเดลไม่ใช่ความถูกต้อง ฟิลด์อย่าง avg_logprob บอกว่าโมเดลมั่นใจกับสิ่งที่มันพิมพ์แค่ไหน ไม่ได้บอกว่าเสียงตรงนั้นมีสิ่งนั้นอยู่จริง เสียงฮัมที่ถูกอ่านเป็นประโยคเป็นตัวอย่างที่ดีที่สุด เลยต้องมีหลักฐานจากอีกช่องทางหนึ่งเสมอ ในกรณีนี้คือระดับเสียงที่วัดได้จากตัวสัญญาณเอง
สรุปเป็นข้อที่นำไปใช้ได้
- อย่าถอดจากมิกซ์ทั้งเพลงเพียงอย่างเดียว ถอดจากสเต็มเสียงคนที่แยกแล้ว และถอดทุกสเต็มที่มีเสียงคน
- ติดธงเซกเมนต์ที่เป็นสัญลักษณ์ล้วน ยาวแต่ข้อความสั้น มั่นใจต่ำ หรือน่าจะเป็นความเงียบ แล้วไปฟังเอง
- ยืนยันเสียงฮัมด้วยระดับเสียง (pitch) ไม่ใช่ด้วยข้อความที่ถอดได้
- เทียบสองรอบก่อนเชื่อขอบเซกเมนต์ ที่ชัดตรงกันภายใน 0.1 วินาที ที่หนาแน่นให้ไปฟัง
- ช่วงที่ถอดไม่ได้ให้แบ่งเวลาเท่า ๆ กัน พร้อมธง estimated บังคับ
- ใส่ human_listening_verified เป็น false จนกว่าจะมีคนฟังจริง
ดูครบแต่เชื่อไม่ได้
- ช่วงบรรเลงกลายเป็นสัญลักษณ์โน้ต
- ฮัมถูกอ่านเป็นประโยค
- เริ่มท่อนแรกช้าไป 0.7 วินาที
ถูกกว่าแต่ต้องเลือกให้ถูกชิ้น
- ได้เวลาเริ่มท่อนแรก 18.5 วินาที
- ท่อนร้องหมู่ต้องไปหาในสเต็มประสาน
- ยังมีของหลอนท้ายไฟล์ ต้องกรอง
ทุกตัวเลขในบทความมาจากเพลงทดลองเพลงเดียวที่ยาว 280.85 วินาที อย่านำไปเป็นอัตราความผิดพลาดของ Whisper โดยทั่วไป ที่ผมอยากให้ได้คือรูปแบบของกับดัก ไม่ใช่สถิติ ตัวกรองที่เสนอก็ต้องลองปรับกับไฟล์ของแต่ละคน
บทเรียนที่สั้นที่สุดคือ ผลถอดที่มีเวลากำกับสวยงามไม่ได้แปลว่าเสียงตรงนั้นมีอะไร ต้องมีหลักฐานอีกชั้นเสมอ อย่างระดับเสียงหรือสเต็มที่ถูกต้อง และข้อมูลที่ไม่มั่นใจต้องมีธงกำกับในไฟล์เอง ไม่ใช่จำไว้ในหัว ตรงไหนผมอธิบายตกหล่นหรือพิมพ์ผิด เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย