เทรนตายเงียบขั้นเดียว: forward hook แปลง NamedTuple เป็น tuple
งานที่ตายแล้วบอกว่า exit 0 คือคำโกหกที่แนบเนียนที่สุดอย่างหนึ่งของระบบเบื้องหลัง เพราะมันทำให้เราไม่ไปมองหา traceback ที่ไม่เคยถูกเขียนลงไฟล์ และบั๊กเองก็เล็กกว่าที่คิด คือ hook ตัวเดียวที่สร้างผลลัพธ์ใหม่ผิดชนิด
สรุปใน 1 นาที
- อาการ/ปัญหา
- งานเทรนบน GPU ตายภายในไม่ถึงนาทีเฉพาะขั้นที่เปิด discriminator แต่ได้ exit 0
- ใครควรอ่าน
- คนเทรนโมเดลภาพด้วย PyTorch ที่ใช้ forward hook และรันงานแบบ detached
- ทางแก้แบบสั้น
- ให้ forward hook คืนชนิดเดิม อย่าใช้ tuple(...) ที่ทำให้ NamedTuple เสียชื่อฟิลด์ และเขียนเทสต์กันซ้ำ
พอดีผมรันงานเทรนโมเดลภาพบน GPU ด้วยโค้ดโอเพนซอร์สบน PyTorch ที่แบ่งเป็นหลายขั้น ขั้นต้น ๆ ผ่านปกติ พอถึงขั้นที่ 3 ซึ่งเปิดการเทรนแบบ adversarial (ตั้งน้ำหนักของ adversarial loss มากกว่าศูนย์ เลยมี discriminator เข้ามา) งานโหลดตัวอย่างข้อมูลเสร็จแล้ว หลังจากนั้นราว 1 นาทีก็จบเองเงียบ ๆ log ที่เก็บได้มีบรรทัดเดียวคือ TRAIN_EXIT 0 ไม่มี traceback ไม่มีข้อความอะไรให้อ่านเลย
โค้ด ชื่อโปรเจกต์ และเครื่องที่ใช้ผมไม่ระบุ ตัวอย่างโค้ดในบทความนี้เขียนใหม่เป็น PyTorch ล้วน ๆ ที่รันได้ในตัวเอง ผมทดลองรันก่อนเอามาลงแล้ว เรื่องที่เล่าเป็นบั๊กเรื่อง forward hook กับชนิดข้อมูลของ Python ซึ่งเกิดกับโค้ดอะไรก็ได้ ไม่ผูกกับงานแบบใดแบบหนึ่ง
อาการ: ขั้นที่มี discriminator ตายเอง ขั้นอื่นไม่เป็นอะไร
สิ่งที่แปลกที่สุดไม่ใช่ว่างานตาย แต่คือมันตาย เฉพาะขั้นเดียว ขั้นที่ไม่มี discriminator รันผ่านได้ปกติ พอเปิด adversarial แล้วงานจบภายในไม่ถึงนาที และสิ่งที่ผมเห็นจากระบบมีแค่
- งานถูกสั่งแบบ detached ไม่ผูกกับ session SSH log ที่เก็บได้มีแค่บรรทัด
TRAIN_EXIT 0 - มี watchdog ที่ relaunch งานให้อัตโนมัติ ประมาณ 3 ครั้งต่อชั่วโมง แล้วหยุด คนที่ดูรายการ process เป็นช่วง ๆ จะเห็นงานโผล่มาใหม่เรื่อย ๆ เลยดูเหมือน "ทำงานอยู่"
- ไม่มี traceback ที่ไหนเลย เพราะ stdout กับ stderr ไม่ถูกเก็บเมื่อ detach
ตัวห่อที่จับ exit code ของ process ลูก แต่ไม่ได้ส่งต่อ stderr บอกได้แค่ว่า "process จบ" ไม่ได้บอกว่าจบเพราะอะไร และ watchdog ที่ relaunch โดยไม่เก็บ stderr ยิ่งซ่อนบั๊กแบบนี้ให้แนบเนียนขึ้น เพราะมีโปรเซสใหม่โผล่มาให้เห็นอยู่ตลอด
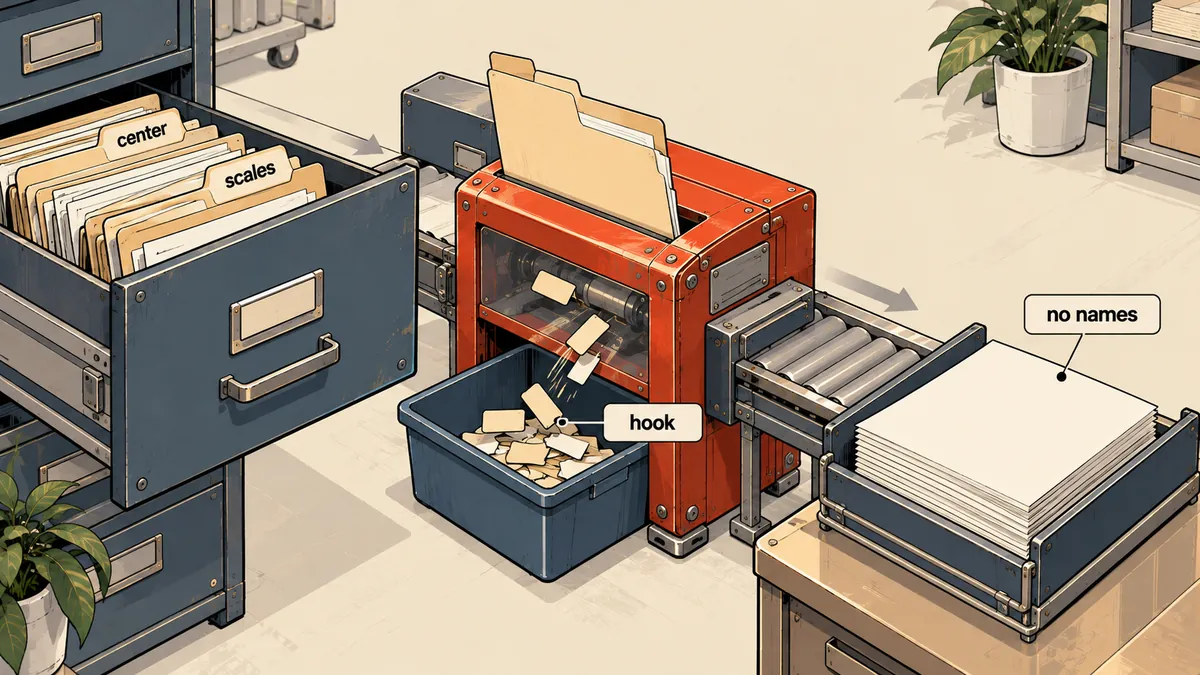
ไล่หา: รันซ้ำแบบ foreground ให้เห็นข้อความจริง
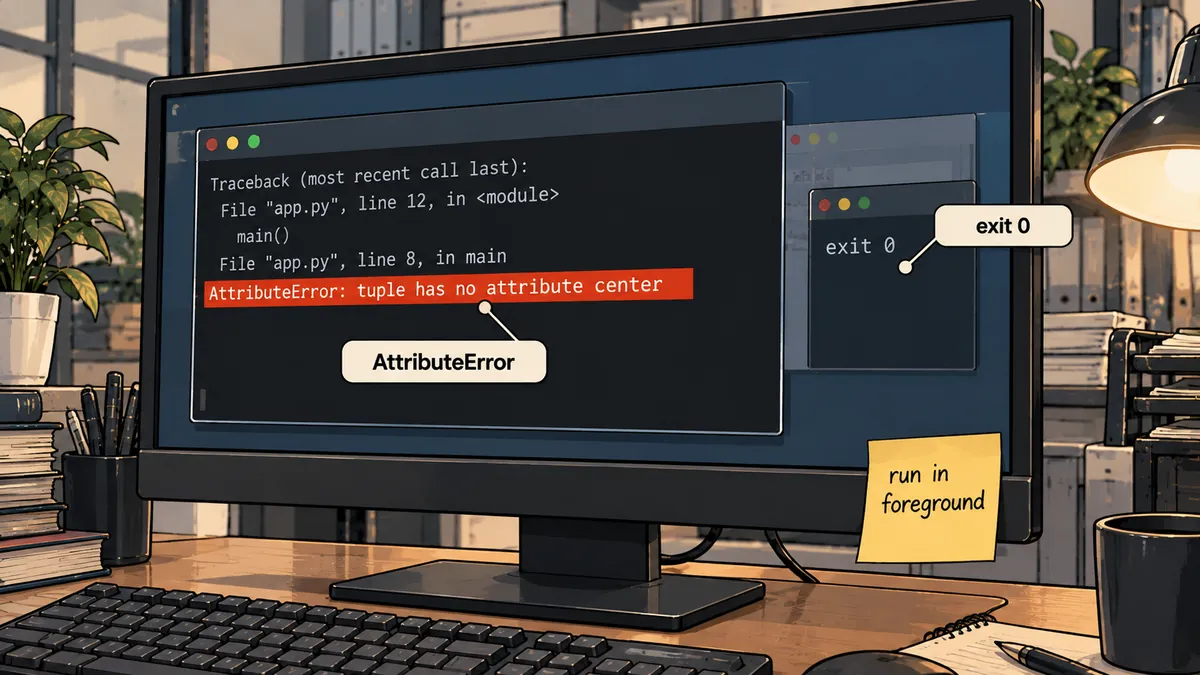
log ว่างขนาดนี้ไม่มีอะไรให้เดาต่อเลย ผมเลยกลับไปทำสิ่งที่ง่ายที่สุดที่ควรทำตั้งแต่แรก คือรัน .bat ของขั้นที่ 3 ในแบบ foreground ผ่าน SSH ให้ stdout กับ stderr ออกมาที่จอผม
# foreground + รวม stderr เข้า stdout ให้เห็นทุกอย่างที่จอ (ฝั่ง Windows ที่เป็นเครื่องเทรน)
ssh host-a 'cmd /c train_stage3.bat 2>&1'
คราวนี้ข้อความออกมาที่จอเลย
Traceback (most recent call last):
  ...
  File "train_step.py", line 142, in train_step
    d_real = pred_src_src_d.center
AttributeError: 'tuple' object has no attribute 'center'
ข้อความบรรทัดเดียวนี้บอกเกือบหมดแล้ว คือโค้ดเทรนคาดว่าผลลัพธ์ของ discriminator เป็นอ็อบเจกต์ที่มีฟิลด์ชื่อ center แต่ได้ tuple ธรรมดามา ชื่อไฟล์กับบรรทัดในตัวอย่างข้างบนผมเปลี่ยนเป็นค่าสมมติ
ตัวจริง: forward hook ที่สร้าง output ใหม่ด้วย tuple(...)
ผลลัพธ์ของ discriminator ในโค้ดนั้นเป็น NamedTuple ที่มีฟิลด์ center (ผมจะเรียกในบทความนี้ว่า DiscOutput) ขณะเดียวกัน โค้ดเทรนลงทะเบียน forward hook ตัวหนึ่งกับทุก network รวมทั้ง discriminator เมื่อเทรนบน CUDA หน้าที่ของ hook คือแปลงชนิดตัวเลขของ output และตอนสร้างผลลัพธ์ใหม่มันเขียนว่า tuple(...) ซึ่งเป็นจุดที่ NamedTuple ถูกลบชื่อฟิลด์ทิ้ง
เรื่องนี้เป็นความรู้ภาษา Python ทั่วไป ไม่เกี่ยวกับ PyTorch เลย ลองดูใน REPL ได้ทันที
from typing import NamedTuple

class DiscOutput(NamedTuple):
    center: float
    scales: float

o = DiscOutput(center=1.0, scales=2.0)
print(o.center)             # 1.0
t = tuple(v for v in o)     # สร้างใหม่จาก iterable ของค่า
print(t)                    # (1.0, 2.0)
print(type(t).__name__)     # tuple
print(hasattr(t, "center")) # False  <- ชื่อฟิลด์หายไปแล้ว
print(DiscOutput._fields)   # ('center', 'scales')  <- ตัวบอกว่าเป็น NamedTuple
tuple(...) เอาแค่ค่าที่วนออกมาไปสร้าง tuple ใหม่ ไม่รู้เรื่องคลาสเดิมเลย ส่วน NamedTuple เป็น tuple ที่มีชื่อติดมาด้วยแต่ชื่อนั้นเป็นสมบัติของคลาส พอสร้างจาก tuple(...) ก็ได้คลาสพื้นฐานที่ไม่มีชื่อมาแทน
มาดูตัวอย่างที่รันได้ครบในไฟล์เดียว ผมเขียนให้เหมือนสถานการณ์จริงที่สุดเท่าที่ทำได้ คือ module ที่คืน DiscOutput และ hook ที่แตะเฉพาะกรณีที่ต้อง cast
# hook_bug.py - ทำซ้ำบั๊กด้วย PyTorch ล้วน ๆ
from typing import NamedTuple
import torch
import torch.nn as nn

class DiscOutput(NamedTuple):
    center: torch.Tensor
    scales: torch.Tensor

class Disc(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = nn.Conv2d(3, 1, 3, padding=1)

    def forward(self, x):
        y = self.conv(x)
        return DiscOutput(center=y, scales=y.mean(dim=(2, 3)))

def cast_outputs_hook_buggy(module, args, out):
    if all(t.dtype == torch.float32 for t in out):
        return None                              # เป็น fp32 อยู่แล้ว ไม่แตะ
    return tuple(t.float() for t in out)         # <-- สร้างใหม่ด้วย tuple: NamedTuple หาย

def run(hook, dtype):
    net = Disc().to(dtype)
    h = net.register_forward_hook(hook)
    out = net(torch.randn(2, 3, 8, 8).to(dtype))
    h.remove()
    return out

# fp32: hook ข้าม ได้ DiscOutput เดิม
print(type(run(cast_outputs_hook_buggy, torch.float32)).__name__)    # DiscOutput

# bf16 (เส้นทางที่ต้อง cast): hook ทำงาน ได้ tuple ธรรมดา
out = run(cast_outputs_hook_buggy, torch.bfloat16)
print(type(out).__name__, out[0].dtype)                              # tuple torch.float32
out.center                                                           # AttributeError
ตอนรันจริง บรรทัดสุดท้ายได้ AttributeError: 'tuple' object has no attribute 'center' ข้อความเดียวกับที่ผมเห็นในงานเทรนทุกตัวอักษร
ทำไมถึงพังเฉพาะบางขั้น
ผมเขียนตามที่เห็นจริงแค่นี้ hook ตัวนี้แตะ output เฉพาะกรณีที่ต้อง cast ตอนที่ output เป็น fp32 อยู่แล้วมันไม่ต้องสร้างอะไรใหม่ NamedTuple เลยผ่านออกไปครบทั้งชนิดและชื่อฟิลด์ ส่วนเส้นทางที่ output ไม่ใช่ fp32 (เส้นทาง autocast) ซึ่งเกิดในขั้นที่มี discriminator hook จะสร้างผลใหม่ด้วย tuple(...) และนั่นคือจุดที่ชื่อ .center หายไป ขั้นอื่นไม่มี discriminator เลยไม่เจอเส้นทางนี้ ผมไม่ลงรายละเอียดลึกกว่านี้ว่า hook เลือกเงื่อนไข cast ด้วยกฎอะไรแน่ เพราะไม่ได้อ่านเหตุผลของคนเขียนเดิม
วิธีแก้: ให้ hook คืนชนิดเดิม
ผมแก้เฉพาะจุดนี้ ให้ hook ตรวจว่า output มี _fields หรือไม่ ถ้ามี (คือเป็น NamedTuple) ให้สร้างด้วยคลาสเดิม ถ้าไม่มีก็คืน tuple ธรรมดาเหมือนเดิม
def cast_outputs_hook_fixed(module, args, out):
    if all(t.dtype == torch.float32 for t in out):
        return None
    vals = [t.float() for t in out]
    if hasattr(out, "_fields"):          # NamedTuple: คืนชนิดเดิมพร้อมชื่อฟิลด์
        return type(out)(*vals)
    return tuple(vals)                   # tuple ธรรมดา ทำเหมือนเดิม

out = run(cast_outputs_hook_fixed, torch.bfloat16)
print(type(out).__name__, out.center.dtype, out.center.shape)
# DiscOutput torch.float32 torch.Size([2, 1, 8, 8])
type(out)(*vals) ได้ผลเพราะ NamedTuple รับค่าตามตำแหน่งตามลำดับฟิลด์ ซึ่งตรงกับลำดับที่วนออกมาจาก out ตอนแรกพอดี ถ้า output เป็นโครงสร้างอื่นที่ไม่ใช่ทั้ง tuple และ NamedTuple (เช่น dict หรือ dataclass) ต้องมีทางจัดการของมันเอง ตัวอย่างนี้ไม่ครอบคลุม
ในโค้ดจริงผมแก้ในไฟล์ของ dependency ตรง ๆ ติดคอมเมนต์ว่าเป็น local patch พร้อมวันที่ และเก็บไฟล์เดิมไว้ข้าง ๆ ในชื่อ .orig_<วันที่>
# ก่อนแก้ เก็บของเดิมไว้ข้างไฟล์ที่แก้
cp trainer/hooks.py trainer/hooks.py.orig_20270401

# ในไฟล์ที่แก้ ติดคอมเมนต์ให้คนถัดไปเห็น
#   # LOCAL PATCH 2027-04-01: คืนชนิดเดิมเมื่อ out เป็น NamedTuple (มี _fields)
#   # ถ้าอัปเดตหรือติดตั้ง dependency ใหม่ ต้อง re-apply จุดนี้

# เทียบหลังอัปเดตว่า patch ยังอยู่ไหม
diff -u trainer/hooks.py.orig_20270401 trainer/hooks.py
หลังแก้ ขั้นที่ 3 รันค้างไปเรื่อย ๆ ได้ แทนที่จะจบใน 1 นาที GPU ใช้ประมาณ 99% และ VRAM ราว 8.6 GB ซึ่งผมถือว่านี่คือหลักฐานว่างานทำงานจริง ไม่ใช่แค่ "ไม่มี error"
กันไม่ให้เกิดซ้ำ: เขียนเทสต์ให้ hook ตัวนี้
หลังแก้เสร็จผมเสียดายอย่างเดียวคือ hook ตัวนี้เล็กพอที่เทสต์ยี่สิบบรรทัดก็จับบั๊กได้ตั้งแต่วันแรก ไม่ต้องรอให้งานเทรนตายก่อน เทสต์ต้องครอบคลุมสองอย่างที่ตกหล่นไปคือ ชนิดของ output ต้องไม่เปลี่ยนหลังผ่าน hook และต้องรันทั้งเส้นทาง fp32 กับเส้นทางที่ต้อง cast
# test_hook.py - รันด้วย pytest ก่อนปล่อยงานเทรนยาว ๆ
import pytest
import torch
from hook_bug import Disc, DiscOutput, cast_outputs_hook_fixed

@pytest.mark.parametrize("dtype", [torch.float32, torch.bfloat16])
def test_hook_keeps_namedtuple(dtype):
    net = Disc().to(dtype)
    net.register_forward_hook(cast_outputs_hook_fixed)
    out = net(torch.randn(2, 3, 8, 8).to(dtype))
    assert isinstance(out, DiscOutput)                 # ชนิดต้องไม่เปลี่ยน
    assert out.center.dtype == torch.float32           # และต้อง cast แล้วจริง
เทสต์นี้ไม่ต้องใช้ GPU เลย รันบนเครื่องธรรมดาได้ในเวลาไม่กี่วินาที และมันตอบคำถามที่งานเทรนต้องใช้เวลานานกว่าจะตอบ ส่วนตัวผมถ้า hook ไหนแตะ output ของโมเดลแล้วสร้างค่าใหม่ ผมจะให้มีเทสต์ที่เช็กชนิดก่อนเสมอ เพราะ Python ไม่ฟ้องเมื่อชนิดเปลี่ยนไปแต่ยังวนค่าออกมาได้เหมือนเดิม มันฟ้องตอนมีคนเรียกชื่อฟิลด์เท่านั้น
บทเรียนปฏิบัติการ: ถือหลักฐานว่ายังรัน ไม่ใช่แค่เลข exit
บั๊กตัวนี้เล็ก แต่ที่ทำให้มันเสียเวลาคือวิธีที่ผมตรวจงานเบื้องหลัง ผมเลยตั้งกฎเป็นข้อ ๆ ไว้ใช้กับทุกงานที่ detach
- "detached แล้วเห็น exit 0" ไม่ได้แปลว่างานสำเร็จ ต้องมีหลักฐานว่ากระบวนการยังรัน ทั้งสี่อย่างพร้อมกัน คือมีใน process list, GPU มีการใช้งาน, ไฟล์ output มี mtime ใหม่ขึ้น และท้าย log ไม่มี Traceback
- ถ้า log ว่างหรือสั้นผิดสังเกต ให้รันคำสั่งเดียวกันแบบ foreground พร้อม
2>&1ให้เห็น traceback ที่จอก่อนจะเดาอะไรทั้งนั้น - wrapper หรือ watchdog ที่ relaunch ต้องเก็บ stderr ลงไฟล์ทุกครั้งที่ relaunch ถ้าไม่เก็บ มันคือเครื่องซ่อนบั๊ก
- local patch ใน dependency จะถูกเขียนทับเมื่ออัปเดตหรือติดตั้งใหม่ ให้เก็บ
.origจดไว้ว่าต้อง re-apply และพิจารณาส่ง fix กลับ upstream
กฎข้อแรกผมทำเป็นสคริปต์เช็กสั้น ๆ ไว้รันก่อนจะเชื่อว่างานยังเดินอยู่ ตัวอย่างฝั่ง Windows (PowerShell) กับ GPU NVIDIA
# check_training.ps1 - หลักฐาน 4 อย่างว่างานยังรันจริง
$out = "C:\train\output\model.ckpt"
$log = "C:\train\logs\stage3.log"

$proc = Get-Process python -ErrorAction SilentlyContinue
$gpu  = (nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv,noheader)
$age  = if (Test-Path $out) { [int]((Get-Date) - (Get-Item $out).LastWriteTime).TotalMinutes } else { -1 }
$tb   = if (Test-Path $log) { Select-String -Path $log -Pattern 'Traceback' -Quiet } else { $false }

"process : {0}" -f $(if ($proc) { "รันอยู่ ($($proc.Count))" } else { "ไม่มี" })
"gpu     : $gpu"
"output  : แก้ไขล่าสุด $age นาทีก่อน"
"log     : $(if ($tb) { 'พบ Traceback' } else { 'ไม่พบ Traceback' })"

if (-not $proc -or $tb) { Write-Host "[FAIL] งานไม่ได้รัน อย่าเชื่อ exit code"; exit 1 }
Write-Host "[OK] มีหลักฐานว่างานยังเดิน"
แต่ละอย่างหลอกได้เมื่อดูเดี่ยว ๆ มี process แต่ GPU ว่างอาจเป็นงานที่ค้างรอ ไฟล์ output ใหม่อาจเป็นของ relaunch รอบก่อน ส่วน log ที่ไม่มี Traceback อาจเพราะ log ไม่เคยถูกเขียน เมื่อเอามารวมกันถึงจะปลอดภัยพอ
สรุปตัวเลขของเรื่องนี้
ส่วนที่ผมยังไม่รู้และไม่ขอเดา มีสามเรื่อง คือบั๊กนี้ยังมีอยู่หรือถูกแก้แล้วใน upstream เวอร์ชันล่าสุดหรือไม่ ทำไมผู้เขียน hook เดิมถึงเลือก tuple(...) ตั้งแต่แรก และการแก้นี้มีผลต่อความแม่นยำของโมเดลหรือไม่ ผมแค่รู้ว่าหลังแก้งานเดินต่อได้ ใครจะเอาเงื่อนไข hasattr(out, "_fields") ไปเขียนให้ครอบคลุมโครงสร้างอื่นหรือส่งกลับ upstream ก็ตามสะดวกครับ เดี๋ยวกลับมาแก้เพิ่มให้ภายหลังครับ
อยากให้เราทำให้ไหม?
ให้เราช่วยติดตั้ง ตั้งค่า ย้ายระบบ หรือแก้ปัญหาเซิร์ฟเวอร์ เพื่อให้คุณมีเวลาไปทำงานที่สำคัญกว่า
เคยเจองานแบบนี้ไหม? ติดตรงไหน?
มาแลกวิธีกันต่อในบอร์ด LinuxThai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกเลย